Startseite
» WINDOWS
»
Große XML-Dateien schnell mit einem sicheren Python-Skript aufteilen
Große XML-Dateien schnell mit einem sicheren Python-Skript aufteilen
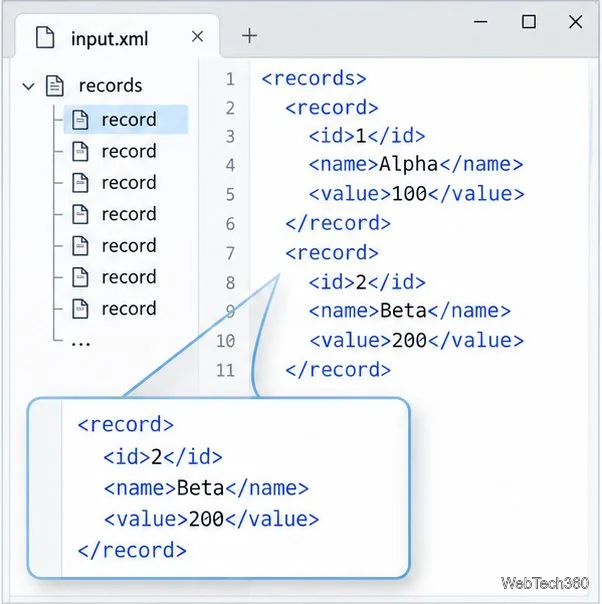
Um eine große XML-Datei schnell aufzuteilen, teilt man sie an vollständigen, sich wiederholenden Datensätzen, anstatt Bytes aus der Datei zu schneiden. Das folgende Beispiel verwendet die Python-Standardbibliothek, um die Eingabe zu streamen und separate XML-Dokumente mit demselben Wurzelelement und denselben Wurzelattributen zu schreiben. Es ist für eine gängige Struktur wie `<root>` gedacht <records><record>...</record><record>...</record></records>, bei der jedes direkte Kind des Wurzelelements einen unabhängigen Datensatz darstellt.
Aufteilung an den wiederholten direkten Kinddatensätzen unterhalb des Stammverzeichnisses; beliebige Bytegrenzen können die XML-Auszeichnung beschädigen.
Wähle einen sicheren Teilungspunkt
Ein XML-Dokument besteht aus einem Dokumentelement, dessen Tags korrekt verschachtelt sein müssen. Ein Dateisplitter kann ein Start-Tag, einen verschachtelten Datensatz oder sogar eine Zeichenkodierungssequenz durchtrennen und so Fragmente erzeugen, die kein eigenständiges XML darstellen. Die W3C-XML-Spezifikation erläutert die Regeln für wohlgeformte Dokumente und Wurzelelemente.
Vor dem Aufteilen der Datei prüfen Sie diese und identifizieren Sie das wiederholte Datensatzelement. Dieses Skript behandelt alle direkten Kindelemente unterhalb des Wurzelelements als eine Einheit. Verwenden Sie es nur, wenn es sich bei den Kindelementen um unabhängige Datensätze handelt und das Wurzelelement selbst keinen aussagekräftigen gemischten Text oder Metadaten enthält, die an einer bestimmten Stelle erscheinen müssen. Sind Datensätze mehrere Ebenen tief verschachtelt, verwenden Sie einen für dieses XML-Vokabular entwickelten Splitter, anstatt das Skript ohne Anpassungen zu ändern.
Was ist mit Split That XML / OOXP Splitter?
Der Originalartikel verwies auf Split That XML. Die zugehörige SourceForge-Projektseite beschreibt das Tool zwar noch, gibt aber als letztes Update den 27. September 2015 an. Es ist als veraltete Software zu betrachten: Die alte Windows-Kompatibilitätsangabe garantiert keine Unterstützung auf aktuellen Systemen. Falls Sie bereits eine Kopie besitzen, erstellen Sie eine Kopie der Datei und überprüfen Sie die Ausgabe, bevor Sie sie verwenden.
Datensätze mit Python aufteilen
Python xml.etree.ElementTree.iterparse()liest ein Dokument inkrementell, wodurch vermieden wird, den gesamten XML-Baum auf einmal in den Speicher zu laden. Das folgende Skript gruppiert die direkten Kindelemente in Batches und schreibt jeden Batch in eine neue Kopie des ursprünglichen Wurzel-Tags und seiner Attribute. Es benötigt keine Drittanbieterpakete. Falls Python nicht installiert ist, verwenden Sie die offiziellen Python-Downloads für Windows ; die ElementTree-Dokumentation beschreibt den hier verwendeten Parser.
Das Original sollte unverändert bleiben, und für jeden Durchlauf sollte ein neuer, leerer Ausgabeordner gewählt werden.
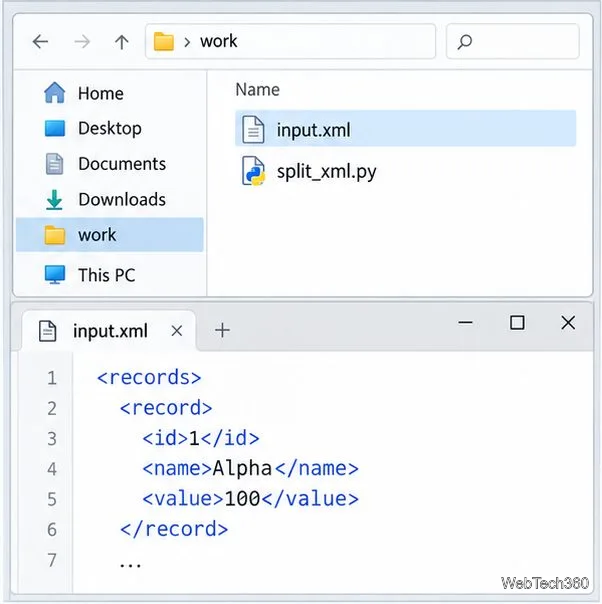
Erstellen Sie eine Arbeitskopie der XML-Quelldatei. Erstellen Sie einen neuen, leeren Ausgabeordner, z. B. parts.
Speichern Sie die folgende Datei in einem einfachen Texteditor split_xml.pyim selben Arbeitsordner wie die Kopie.
from pathlib import Path
import sys
import xml.etree.ElementTree as ET

source = Path(sys.argv[1])
out_dir = Path(sys.argv[2])
records_per_file = int(sys.argv[3]) if len(sys.argv) > 3 else 500

if records_per_file < 1:
    raise SystemExit("records_per_file must be at least 1")
out_dir.mkdir(parents=True, exist_ok=True)
if any(out_dir.glob("part_*.xml")):
    raise SystemExit("Choose a new, empty output folder first")

records = []
part_count = 0
root = None
root_tag = None
root_attrib = {}

def write_part(items, number):
    wrapper = ET.Element(root_tag, root_attrib)
    wrapper.extend(items)
    target = out_dir / f"part_{number:04d}.xml"
    ET.ElementTree(wrapper).write(
        target, encoding="utf-8", xml_declaration=True
    )

depth = 0
for event, elem in ET.iterparse(source, events=("start", "end")):
    if event == "start":
        depth += 1
        if depth == 1:
            root = elem
            root_tag = elem.tag
            root_attrib = dict(elem.attrib)
    else:
        if depth == 2:
            records.append(elem)
            if len(records) == records_per_file:
                part_count += 1
                write_part(records, part_count)
                records.clear()
                root[:] = []
        depth -= 1

if records:
    part_count += 1
    write_part(records, part_count)
if part_count == 0:
    raise SystemExit("No direct-child elements were found under the root")
print(f"Wrote {part_count} files.")
Führen Sie den Befehl aus
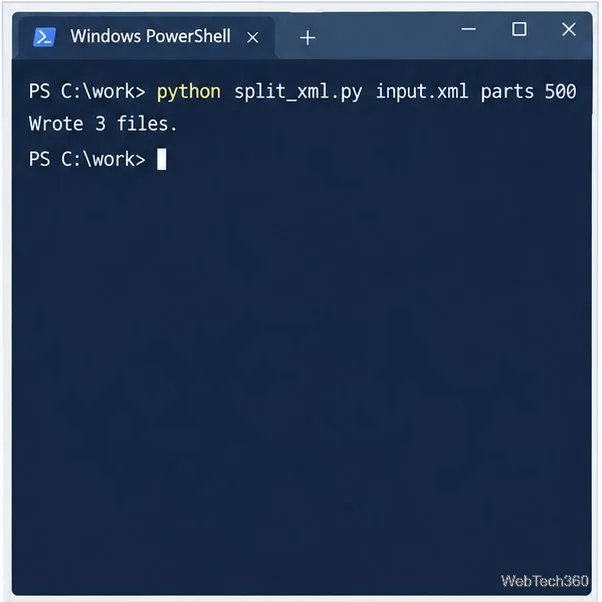
Öffnen Sie PowerShell im Arbeitsordner und prüfen Sie, ob Python verfügbar ist. Das letzte Argument gibt die Anzahl der Datensätze pro Teil an; der Standardwert ist 500, wenn Sie es weglassen.
python --version
python split_xml.py input.xml parts 500
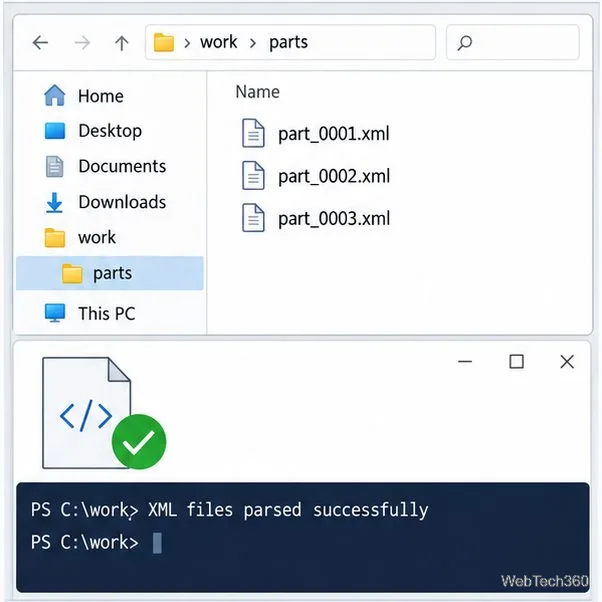
Bei einer Windows-Installation mit dem Python-Launcher kann die zweite Zeile so aussehen py -3 split_xml.py input.xml parts 500: Das Skript erstellt Dateien wie beispielsweise `.py` part_0001.xmlund gibt deren Anzahl aus. Verwenden Sie jedes Mal einen leeren Ausgabeordner; das Skript stoppt, sobald passende Teildateien vorhanden sind, sodass neue Durchläufe nicht unbemerkt mit bereits vorhandenen Dateien vermischt werden.
Das dritte Befehlsargument legt die Anzahl der Datensätze fest, nicht die garantierte maximale Dateigröße.
Überprüfen Sie die Ergebnisse vor dem Import.
Zuerst muss jeder generierte Teil analysiert werden, um fehlerhaftes XML zu erkennen. Führen Sie dazu in PowerShell Folgendes aus:
python -c "import glob, xml.etree.ElementTree as ET; files=glob.glob('parts/*.xml'); [ET.parse(p) for p in files]; print(f'{len(files)} files parsed')"
Prüfen Sie, ob die gemeldete Zahl nicht null ist, untersuchen Sie einige Dateien und vergleichen Sie die Gesamtzahl der Datensätze mit der Quelldatei. Ein erfolgreicher Parse beweist lediglich, dass ein Teil wohlgeformt ist . Er beweist nicht, dass er einem XML-Schema (XSD), einer DTD, einer Geschäftsregel oder den Anforderungen der Anwendung entspricht, die ihn verarbeiten wird. Wenn dies relevant ist, validieren Sie jeden Teil anhand des Schemas oder Validators des Zielsystems. Die W3C-Ressourcen zum XML-Schema erläutern die separate Rolle von Schemaeinschränkungen.
Prüfen Sie jeden Teil auf Wohlgeformtheit und führen Sie anschließend die Schema- oder Importprüfungen Ihrer Anwendung separat durch.
Grenzen und schnelle Lösungen
Ein Teil ist immer noch zu groß: Reduzieren Sie die Anzahl der Datensätze, beispielsweise von 500 auf 100. Ein einzelner großer Datensatz kann dazu führen, dass ein Teil die Zielgröße überschreitet; dieses Skript erzwingt keine strikte Megabyte-Obergrenze.
Die Teile bestehen die Schema-Validierung nicht: Überprüfen Sie, ob die gewählte Datensatzgrenze der erforderlichen Struktur und Reihenfolge des Schemas entspricht. Durch Aufteilung kann eine korrekte Verschachtelung erhalten bleiben, ohne die Gültigkeit auf Dokumentebene zu gewährleisten.
Geänderte Präfixe oder Formatierungen: ElementTree serialisiert Namespace-Präfixe möglicherweise anders und normalisiert die XML-Darstellung. Vergleichen Sie die geparsten Werte und das Anwendungsverhalten, anstatt bytegenaue Kopien zu erwarten.
Der Quellcode verwendet DTDs, Kommentare, Verarbeitungsanweisungen oder Metadaten auf oberster Ebene: Dieses einfache Skript erhält nicht alle Konstrukte auf Dokumentebene. Verwenden Sie stattdessen ein XML-Tool mit Vokabularunterstützung und testen Sie es mit einer Kopie.
Bei einer regulären Liste unabhängiger Datensätze liefert dieser Ansatz handhabbare, separat auswertbare Dateien, ohne die Über-/Unterordnungsstruktur zu beeinträchtigen. Die Datensatzstruktur und die Validierungsregeln des Zielsystems bestimmen, ob die resultierenden Teile auch für Ihren Workflow gültig sind.