Inicio
» WINDOWS
»
Divide rápidamente archivos XML grandes con un script seguro de Python.
Divide rápidamente archivos XML grandes con un script seguro de Python.
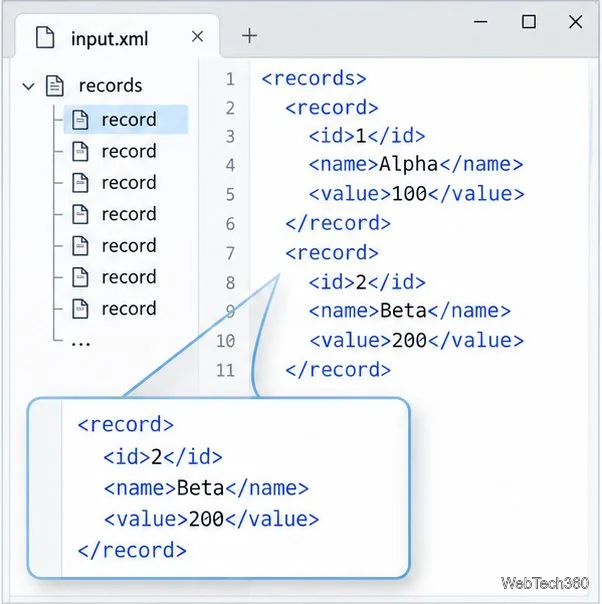
Para dividir rápidamente un archivo XML grande, divídalo en registros repetidos completos en lugar de cortar bytes del archivo. El siguiente ejemplo utiliza la biblioteca estándar de Python para procesar la entrada y escribir documentos XML separados con el mismo elemento raíz y atributos de raíz. Está diseñado para una estructura común como <records><record>...</record><record>...</record></records>, donde cada hijo directo de la raíz es un registro independiente.
La división se produce en los registros secundarios directos repetidos bajo la raíz; los límites de bytes arbitrarios pueden romper el marcado XML.
Elija un punto de división seguro
Un documento XML tiene un único elemento de documento, y sus etiquetas deben anidarse correctamente. Un divisor de archivos sin procesar puede cortar una etiqueta de inicio, un registro anidado o incluso una secuencia de codificación de caracteres, dejando fragmentos que no constituyen XML independiente. La especificación XML del W3C explica las reglas para documentos bien formados y elementos raíz.
Antes de dividir el archivo, inspeccione el archivo e identifique el elemento de registro repetido. Este script trata cada elemento hijo directo bajo la raíz como una sola unidad. Úselo únicamente cuando esos hijos sean registros independientes y la raíz no contenga texto mixto o metadatos relevantes que deban aparecer en un lugar específico. Si los registros están anidados varios niveles, utilice un divisor diseñado para ese vocabulario XML en lugar de modificar el script sin criterio.
¿Qué tal Split That XML / OOXP Splitter?
El artículo original remitía a los lectores a Split That XML. Su página de proyecto en SourceForge aún describe la utilidad, pero indica que su última actualización fue el 27 de septiembre de 2015. Considérenlo software obsoleto: la antigua afirmación de compatibilidad con Windows no garantiza su funcionamiento en los sistemas actuales. Si ya tienen una copia, trabajen con un archivo duplicado y validen los resultados antes de utilizarlos.
Dividir registros con Python
Python xml.etree.ElementTree.iterparse()lee un documento de forma incremental, lo que evita cargar todo el árbol XML en la memoria de una sola vez. El script que se muestra a continuación agrupa los elementos hijos directos en lotes y luego escribe cada lote dentro de una copia nueva de la etiqueta raíz y los atributos originales. No requiere ningún paquete de terceros. Si Python no está instalado, utilice las descargas oficiales de Python para Windows ; la documentación de ElementTree describe el analizador utilizado aquí.
Mantén el archivo original intacto y elige una carpeta de salida nueva y vacía para cada ejecución.
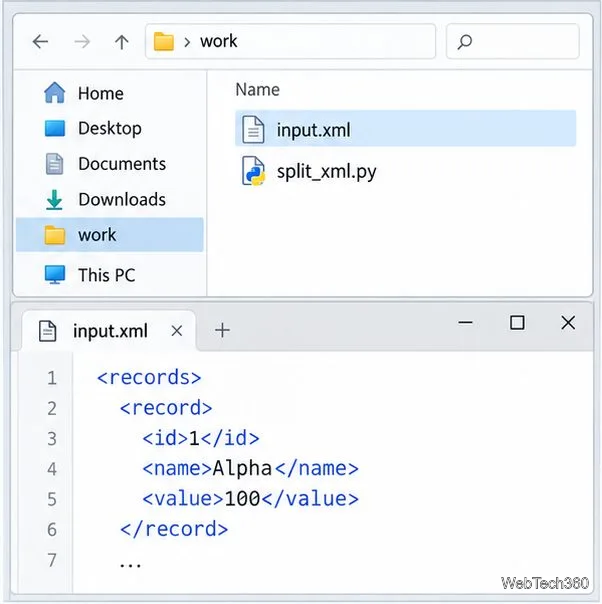
Crea una copia de trabajo del XML de origen. Crea una nueva carpeta de salida vacía, como por ejemplo parts.
En un editor de texto plano, guarde lo siguiente split_xml.pyen la misma carpeta de trabajo que la copia.
from pathlib import Path
import sys
import xml.etree.ElementTree as ET

source = Path(sys.argv[1])
out_dir = Path(sys.argv[2])
records_per_file = int(sys.argv[3]) if len(sys.argv) > 3 else 500

if records_per_file < 1:
    raise SystemExit("records_per_file must be at least 1")
out_dir.mkdir(parents=True, exist_ok=True)
if any(out_dir.glob("part_*.xml")):
    raise SystemExit("Choose a new, empty output folder first")

records = []
part_count = 0
root = None
root_tag = None
root_attrib = {}

def write_part(items, number):
    wrapper = ET.Element(root_tag, root_attrib)
    wrapper.extend(items)
    target = out_dir / f"part_{number:04d}.xml"
    ET.ElementTree(wrapper).write(
        target, encoding="utf-8", xml_declaration=True
    )

depth = 0
for event, elem in ET.iterparse(source, events=("start", "end")):
    if event == "start":
        depth += 1
        if depth == 1:
            root = elem
            root_tag = elem.tag
            root_attrib = dict(elem.attrib)
    else:
        if depth == 2:
            records.append(elem)
            if len(records) == records_per_file:
                part_count += 1
                write_part(records, part_count)
                records.clear()
                root[:] = []
        depth -= 1

if records:
    part_count += 1
    write_part(records, part_count)
if part_count == 0:
    raise SystemExit("No direct-child elements were found under the root")
print(f"Wrote {part_count} files.")
Ejecuta el comando
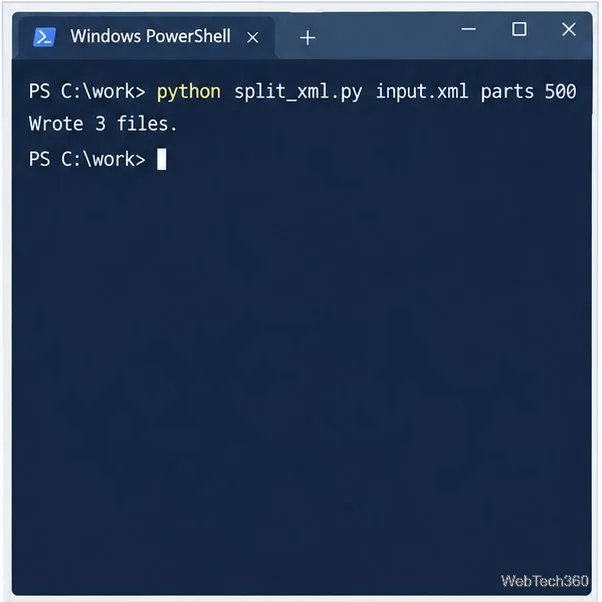
Abra PowerShell en la carpeta de trabajo y compruebe que Python esté disponible. El último argumento es el número de registros por parte; el valor predeterminado es 500 si lo omite.
python --version
python split_xml.py input.xml parts 500
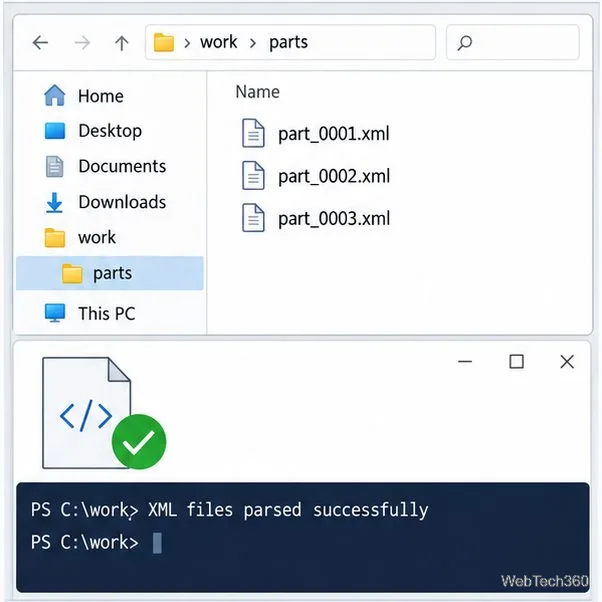
En una instalación de Windows que utilice el lanzador de Python, la segunda línea puede ser py -3 split_xml.py input.xml parts 500. El script escribe archivos como part_0001.xmly reporta cuántos creó. Utilice una carpeta de salida vacía cada vez; el script se detiene si ya existen archivos de partes coincidentes, por lo que no mezclará silenciosamente una nueva ejecución con los restos.
El tercer argumento del comando establece un número de registros, no un tamaño máximo de archivo garantizado.
Comprueba los resultados antes de importar.
Primero, analice cada parte generada para detectar XML mal formado. Desde PowerShell, ejecute:
python -c "import glob, xml.etree.ElementTree as ET; files=glob.glob('parts/*.xml'); [ET.parse(p) for p in files]; print(f'{len(files)} files parsed')"
Confirme que el número reportado no sea cero, inspeccione algunos archivos y compare el recuento total de registros con el de origen. Un análisis exitoso solo demuestra que una parte está bien formada . No demuestra que cumpla con un esquema XML (XSD), DTD, regla de negocio o los requisitos de la aplicación que la consumirá. Cuando esto sea relevante, valide cada parte con el esquema o validador utilizado por el sistema de destino. Los recursos de W3C sobre esquemas XML explican la función independiente de las restricciones de esquema.
Analice cada parte para comprobar que esté bien formada y, a continuación, ejecute por separado las comprobaciones de esquema o importación de su aplicación.
Límites y soluciones rápidas
Una parte sigue siendo demasiado grande: reduzca la cantidad de registros, por ejemplo, de 500 a 100. Un solo registro grande aún puede hacer que una parte supere el tamaño objetivo; este script no impone un límite estricto en megabytes.
Las partes no superan la validación del esquema: verifique que el límite del registro seleccionado coincida con la estructura y el orden requeridos por el esquema. La división puede preservar el anidamiento correcto sin preservar la validez a nivel de documento.
Prefijos o formato modificados: ElementTree puede serializar los prefijos de espacio de nombres de forma diferente y normaliza la representación XML. Compare los valores analizados con el comportamiento de la aplicación en lugar de esperar copias byte a byte.
El código fuente utiliza DTD, comentarios, instrucciones de procesamiento o metadatos de nivel raíz: este sencillo script no conserva todas las estructuras a nivel de documento. Utilice una herramienta XML compatible con vocabulario y realice la prueba en una copia.
Para una lista regular de registros independientes, este enfoque proporciona archivos manejables y analizables por separado sin romper el marcado jerárquico. La estructura del registro y las reglas de validación del destino determinan si las partes resultantes también son válidas para su flujo de trabajo.