Strona główna
» WINDOWS
»
Szybkie dzielenie dużych plików XML za pomocą bezpiecznego skryptu Pythona
Szybkie dzielenie dużych plików XML za pomocą bezpiecznego skryptu Pythona
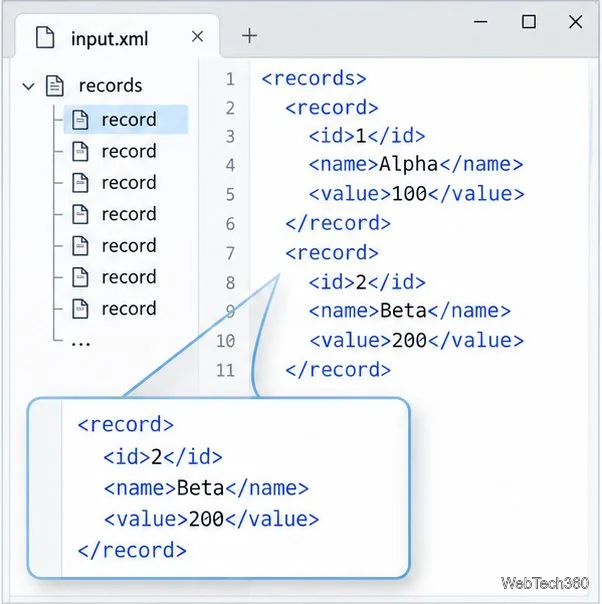
Aby szybko podzielić duży plik XML, należy podzielić go na całe, powtarzające się rekordy, zamiast wycinać z pliku bajty. Poniższy przykład wykorzystuje standardową bibliotekę Pythona do strumieniowego przesyłania danych wejściowych i zapisywania oddzielnych dokumentów XML z tym samym elementem głównym i atrybutami głównymi. Jest to przeznaczone dla typowej struktury, takiej jak <records><record>...</record><record>...</record></records>, gdzie każdy bezpośredni element potomny elementu głównego jest niezależnym rekordem.
Podział następuje w miejscu powtarzających się rekordów podrzędnych bezpośrednio pod korzeniem; dowolne granice bajtów mogą spowodować uszkodzenie znacznika XML.
Wybierz bezpieczny punkt podziału
Dokument XML ma jeden element dokumentu, a jego znaczniki muszą być poprawnie zagnieżdżone. Moduł rozdzielający pliki RAW może przeciąć znacznik początkowy, zagnieżdżony rekord, a nawet sekwencję kodowania znaków, pozostawiając fragmenty, które nie są samodzielnym dokumentem XML. Specyfikacja W3C XML wyjaśnia zasady poprawnego formatowania dokumentu i elementu głównego.
Przed podziałem sprawdź plik i zidentyfikuj powtarzający się element rekordu. Ten skrypt traktuje każdy bezpośredni element podrzędny pod elementem głównym jako jedną całość. Używaj go tylko wtedy, gdy te elementy podrzędne są niezależnymi rekordami, a sam element główny nie zawiera znaczącego tekstu mieszanego ani metadanych, które muszą znajdować się w określonym miejscu. Jeśli rekordy są zagnieżdżone kilka poziomów niżej, użyj dzielnika zaprojektowanego dla tego słownika XML, zamiast bezmyślnie zmieniać skrypt.
Co ze Split That XML / OOXP Splitter?
Oryginalny artykuł wskazywał czytelnikom Split That XML. Strona projektu SourceForge nadal opisuje to narzędzie, ale ostatnia aktualizacja została podana na 27 września 2015 roku. Traktuj je jak przestarzałe oprogramowanie: stare oświadczenie o zgodności z systemem Windows nie potwierdza obsługi na obecnych systemach. Jeśli posiadasz już kopię, pracuj nad duplikatem pliku i sprawdź poprawność wyników przed ich użyciem.
Dzielenie rekordów za pomocą Pythona
Python xml.etree.ElementTree.iterparse()odczytuje dokument przyrostowo, co pozwala uniknąć ładowania całego drzewa XML do pamięci naraz. Poniższy skrypt grupuje elementy podrzędne w partie, a następnie zapisuje każdą partię w nowej kopii oryginalnego znacznika głównego i atrybutów. Nie wymaga on żadnych zewnętrznych pakietów. Jeśli Python nie jest zainstalowany, należy skorzystać z oficjalnych plików do pobrania Python dla systemu Windows ; dokumentacja ElementTree opisuje użyty tutaj parser.
Zachowaj oryginał w stanie nienaruszonym i dla każdego przebiegu wybierz nowy, pusty folder wyjściowy.
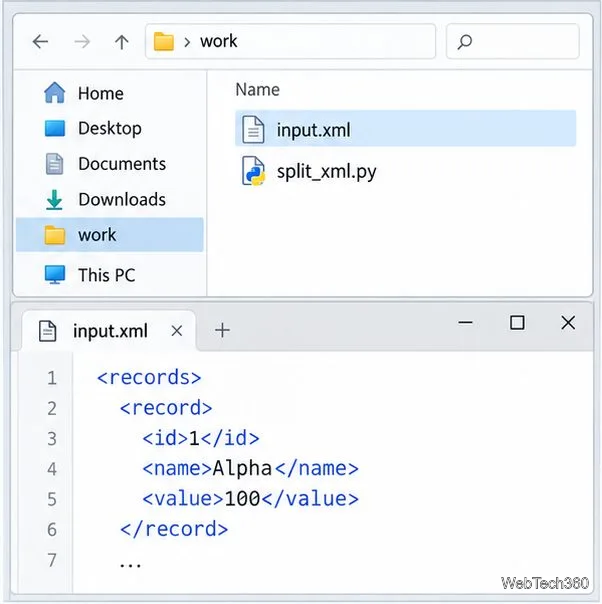
Utwórz kopię roboczą źródłowego pliku XML. Utwórz nowy, pusty folder wyjściowy, taki jak parts.
W edytorze zwykłego tekstu zapisz poniższy kod split_xml.pyw tym samym folderze roboczym, w którym znajduje się kopia.
from pathlib import Path
import sys
import xml.etree.ElementTree as ET

source = Path(sys.argv[1])
out_dir = Path(sys.argv[2])
records_per_file = int(sys.argv[3]) if len(sys.argv) > 3 else 500

if records_per_file < 1:
    raise SystemExit("records_per_file must be at least 1")
out_dir.mkdir(parents=True, exist_ok=True)
if any(out_dir.glob("part_*.xml")):
    raise SystemExit("Choose a new, empty output folder first")

records = []
part_count = 0
root = None
root_tag = None
root_attrib = {}

def write_part(items, number):
    wrapper = ET.Element(root_tag, root_attrib)
    wrapper.extend(items)
    target = out_dir / f"part_{number:04d}.xml"
    ET.ElementTree(wrapper).write(
        target, encoding="utf-8", xml_declaration=True
    )

depth = 0
for event, elem in ET.iterparse(source, events=("start", "end")):
    if event == "start":
        depth += 1
        if depth == 1:
            root = elem
            root_tag = elem.tag
            root_attrib = dict(elem.attrib)
    else:
        if depth == 2:
            records.append(elem)
            if len(records) == records_per_file:
                part_count += 1
                write_part(records, part_count)
                records.clear()
                root[:] = []
        depth -= 1

if records:
    part_count += 1
    write_part(records, part_count)
if part_count == 0:
    raise SystemExit("No direct-child elements were found under the root")
print(f"Wrote {part_count} files.")
Uruchom polecenie
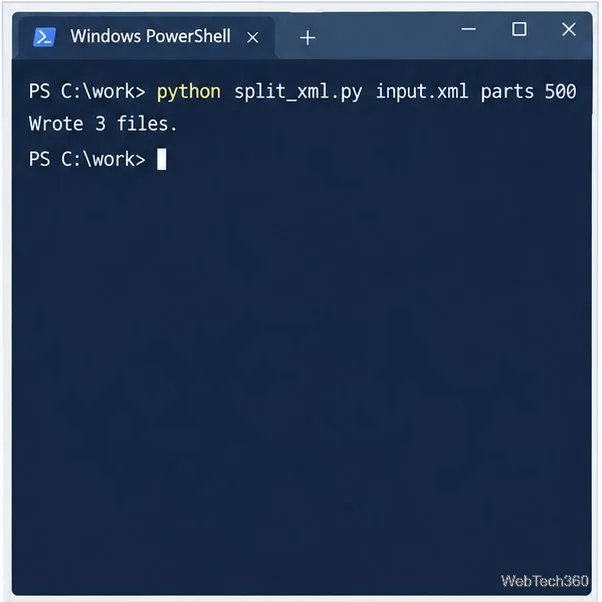
Otwórz program PowerShell w folderze roboczym i sprawdź, czy Python jest dostępny. Ostatnim argumentem jest liczba rekordów w każdej części; domyślna wartość to 500, jeśli ją pominiesz.
python --version
python split_xml.py input.xml parts 500
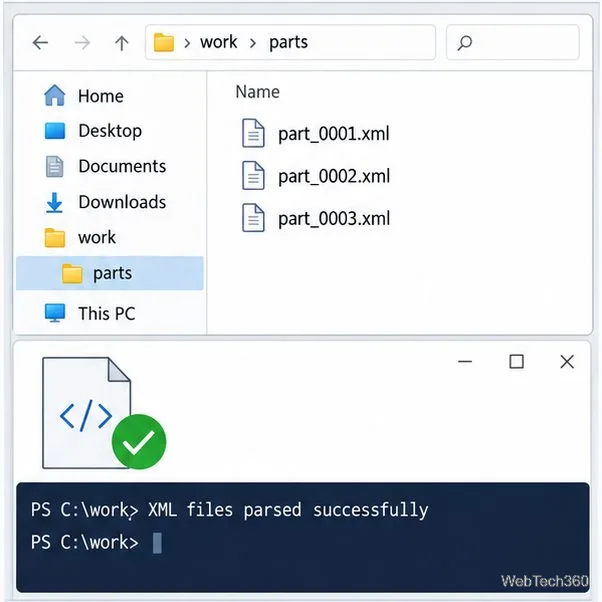
W instalacji systemu Windows z programem uruchamiającym Pythona, drugi wiersz może wyglądać następująco py -3 split_xml.py input.xml parts 500: . Skrypt zapisuje pliki takie jak part_0001.xmli raportuje ich liczbę. Za każdym razem należy używać pustego folderu wyjściowego; skrypt zatrzymuje się, jeśli pasujące pliki części już się tam znajdują, więc nie będzie automatycznie mieszać nowego uruchomienia z resztkami.
Trzeci argument polecenia ustawia liczbę rekordów, a nie gwarantowany maksymalny rozmiar pliku.
Sprawdź wyniki przed importem
Najpierw przeanalizuj każdą wygenerowaną część, aby wychwycić błędny kod XML. W programie PowerShell uruchom:
python -c "import glob, xml.etree.ElementTree as ET; files=glob.glob('parts/*.xml'); [ET.parse(p) for p in files]; print(f'{len(files)} files parsed')"
Upewnij się, że zgłoszona liczba nie jest równa zero, sprawdź kilka plików i porównaj całkowitą liczbę rekordów ze źródłem. Pomyślna analiza składniowa dowodzi jedynie, że część jest poprawnie sformatowana . Nie dowodzi natomiast, że spełnia ona schemat XML (XSD), DTD, regułę biznesową ani wymagania aplikacji, która będzie ją wykorzystywać. W razie potrzeby zweryfikuj każdą część zgodnie ze schematem lub walidatorem używanym przez system docelowy. Zasoby W3C dotyczące schematu XML wyjaśniają odrębną rolę ograniczeń schematu.
Przeanalizuj każdą część pod kątem poprawności strukturalnej, a następnie osobno uruchom sprawdzanie schematu lub importu aplikacji.
Ograniczenia i szybkie rozwiązania
Część jest nadal za duża: zmniejsz liczbę rekordów, np. z 500 do 100. Pojedynczy duży rekord nadal może spowodować, że jedna z części przekroczy rozmiar docelowy; ten skrypt nie narzuca sztywnego limitu megabajtów.
Części nie przechodzą walidacji schematu: sprawdź, czy wybrana granica rekordu jest zgodna z wymaganą strukturą i kolejnością w schemacie. Podział może zachować poprawne zagnieżdżenie bez naruszania poprawności na poziomie dokumentu.
Zmieniono prefiksy lub formatowanie: ElementTree może serializować prefiksy przestrzeni nazw w inny sposób i normalizuje reprezentację XML. Porównywanie sparsowanych wartości i zachowania aplikacji zamiast oczekiwania na kopiowanie bajt po bajcie.
Źródło używa DTD, komentarzy, instrukcji przetwarzania lub metadanych na poziomie głównym: ten prosty skrypt nie zachowuje wszystkich konstrukcji na poziomie dokumentu. Zamiast tego użyj narzędzia XML obsługującego słownictwo i przetestuj na kopii.
W przypadku standardowej listy niezależnych rekordów, takie podejście zapewnia łatwe w zarządzaniu, oddzielnie parsowalne pliki bez naruszania znaczników nadrzędny-podrzędny. Struktura rekordu i reguły walidacji w miejscu docelowym decydują o tym, czy wynikowe części są również prawidłowe dla danego przepływu pracy.