Descărcați FlightGear gratuit: Ghid oficial de instalare

Descarcă FlightGear gratuit de pe site-ul oficial. Compară pachetele Windows, macOS și Linux, instalează fișierele de date și începe primul tău zbor.
Dacă un server SUSE Linux pare să se blocheze în timpul repornirii la un mesaj de închidere systemd, cea mai utilă primă presupunere nu este că comanda de repornire în sine este defectă. În majoritatea cazurilor, systemd așteaptă finalizarea unei unități, a unei monturi, a unui proces sau a unui hook de închidere. Prin urmare, cea mai sigură soluție este identificarea exactă a jobului care încă rulează, inspectarea motivului pentru care nu se oprește și corectarea acelei componente, în loc să scurtăm global timeout-urile de închidere.
Acest ghid folosește un exemplu ipotetic pe tot parcursul: un server numit lab-sles01rulează SUSE Linux Enterprise Server și se întrerupe în timpul repornirii, afișând un mesaj similar cu A stop job is running for backup.service. Exemplul este doar o ilustrare a metodei de diagnosticare; nu este un raport al unui test real sau o afirmație că o anumită versiune de SUSE are un defect într-un serviciu numit backup.service.
| Pas | Ce să fac | Ceea ce încerci să înveți |
|---|---|---|
| 1 | Înregistrați mesajul exact de oprire | Ce unitate sau etapă blochează progresul |
| 2 | Revizuirea jurnalului de pornire anterior | Dacă oprirea a expirat, o demontare a eșuat sau închiderea a ajuns la o etapă ulterioară |
| 3 | Inspectați unitatea de blocare și piesele sub tensiune | Dacă un serviciu, o montare, un inhibitor sau o dependență este responsabilă |
| 4 | Remediați cauza principală și retestați | Dacă o normalitate systemctl rebootse desfășoară acum fără întârziere |
Urmăriți consola locală, consola mașinii virtuale, consola BMC/IPMI sau consola hypervisor în timpul unei reporniri planificate. O linie care denumește o unitate este mult mai utilă decât o descriere generală, cum ar fi „systemd a fost blocat”. În cazul ipotetic lab-sles01, să presupunem că consola arată că backup.servicesystemd se oprește în continuare, în timp ce alte unități s-au oprit deja.
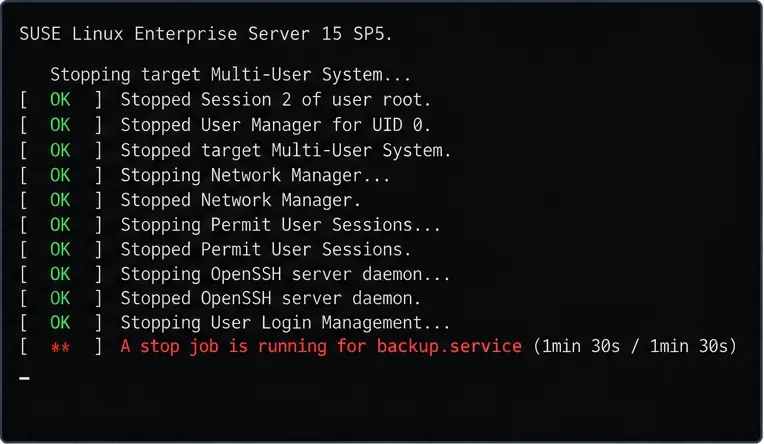
Exemplu ilustrativ: consola de închidere identifică backup.serviceunitatea pe care systemd o așteaptă încă.
Dacă consola denumește în schimb o .mountunitate, un sistem de fișiere de rețea, un dispozitiv sau un alt serviciu, urmați acel nume în loc să aplicați un timeout generic pentru serviciu. Unitatea afișată în partea de jos a consolei este un indiciu, nu automat cauza principală: este posibil să aștepte un proces copil, un spațiu de stocare, o rețea I/O sau o altă dependență.
Ghidul systemd actual al SUSE menționează că o repornire sau o oprire prelungită poate fi cauzată de un serviciu care nu se încheie și recomandă verificarea joburilor systemd. Consultați SUSE Linux Enterprise Server 16.0: Introducere în noțiunile de bază despre systemd .
După ce mașina pornește din nou, inspectați închiderea care tocmai a avut loc. SUSE documentează offset-urile de pornire în jurnal: boot 0este pornirea curentă, -1este pornirea anterioară și așa mai departe. Începeți cu:
sudo journalctl --list-boots
sudo journalctl -b -1
Pentru un jurnal mare, ordinea inversă poate afișa ultimele mesaje mai rapid:
sudo journalctl -b -1 -r
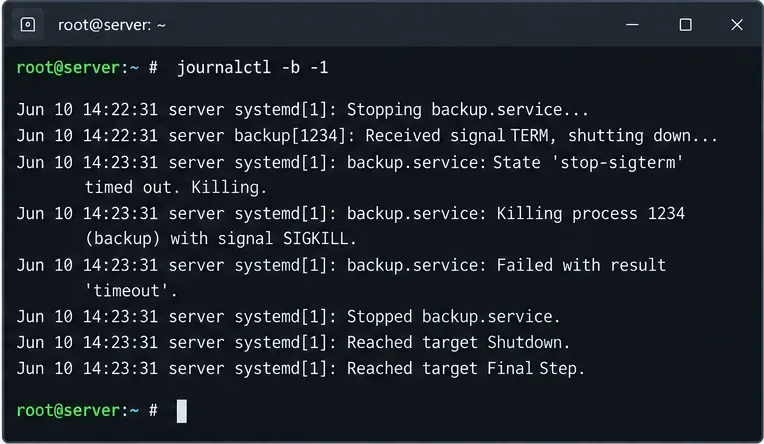
Exemplu ilustrativ: jurnalul pornirii anterioare arată serviciul ipotetic de backup care primește SIGTERM și expiră ulterior.
Căutați expresii precum Stopping, stop job, timed out, Failed with result, Unmounting, Dependency failed, sau mesaje de la serviciul suspect. Puteți restrânge vizualizarea odată ce cunoașteți numele unității:
sudo journalctl -b -1 -u backup.service
Documentează SUSE journalctl -b -1pentru analiza pornirii anterioare în documentația sa de jurnal SLES 15 SP7 . Dacă journalctl --list-bootsnu conține pornirea anterioară, nu trageți concluzii din istoricul lipsă; verificați cum este configurată stocarea journald și utilizați înregistrarea în consolă sau la distanță pentru următoarea reproducere.
Dacă puteți reproduce problema într-o fereastră de întreținere, păstrați disponibilă o a doua consolă administrativă. Înainte ca conectivitatea să dispară, executați:
sudo systemctl list-jobs
sudo systemctl status backup.service
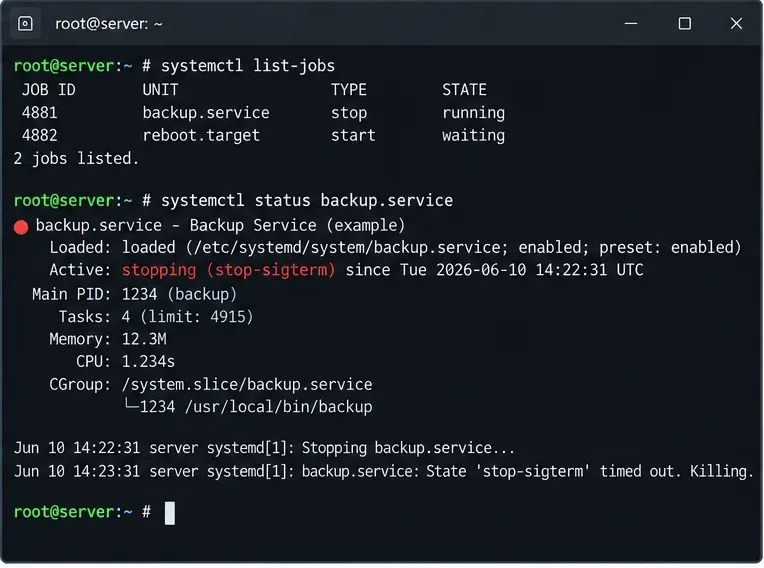
Exemplu ilustrativ: backup.serviceare o operațiune de oprire în execuție în timp ce ținta de repornire așteaptă în urma ei.
Ghidul de depanare systemd din amonte explică faptul că joburile afișate ca runningtrebuie să se termine înainte ca joburile dependente afișate ca waitingsă poată continua. SUSE recomandă, de asemenea, systemctl list-jobssituațiile în care închiderea sau repornirea durează prea mult. Acest lucru face ca această comandă să fie deosebit de utilă atunci când serverul nu este complet înghețat și PID-ul 1 este încă receptiv.
Inspectați definiția unității și comportamentul acesteia la oprire:
sudo systemctl cat backup.service
sudo systemctl status backup.service
sudo journalctl -u backup.service -b
Verificați dacă serviciul are o ExecStop=acțiune, dacă procesul său gestionează SIGTERM și dacă așteaptă resurse de stocare sau de rețea. O bază de date, un agent de backup sau un serviciu middleware ar putea avea nevoie în mod legitim de timp pentru a goli datele, așa că închiderea lor mai devreme nu este automat o soluție.
Căutați operațiuni de demontare eșuate și identificați sursa montării:
findmnt
systemctl list-units --type=mount
sudo journalctl -b -1 | grep -Ei 'unmount|umount|mount|nfs|cifs'
Pentru NFS sau CIFS, investigați accesibilitatea serverului, sesiunile învechite și dacă opțiunile de montare corespund cerințelor de oprire ale serverului. Dacă unitatea blocată este generată din /etc/fstab, remediați configurația de montare în loc să aplicați un timeout specific serviciului unei unități fără legătură.
Înainte de începerea închiderii, puteți lista inhibitorii activi ai sistemului systemd:
systemd-inhibit --list
Blocările inhibitoare pot bloca sau întârzia cererile de închidere în timp ce o aplicație execută o activitate care nu ar trebui întreruptă. Acestea sunt cele mai relevante atunci când cererea de repornire în sine este întârziată înainte ca sistemul să intre în secvența finală de închidere. Consultați manualul systemd-inhibit din amonte .
O blocare într-o etapă ulterioară merită o investigație diferită. systemd rulează executabile cu /usr/lib/systemd/system-shutdown/puțin timp înainte de repornirea sau oprirea finală și așteaptă finalizarea acestora. Dacă jurnalul și consola arată că serviciile obișnuite sunt deja oprite și blocarea are loc în etapa finală de închidere, verificați directorul respectiv și orice hook-uri instalate de furnizor. Documentația serviciului de închidere systemd din amonte descrie acest comportament.
Revenim la ipoteza lab-sles01. Să presupunem că jurnalele arată că backup.serviceignoră terminarea normală după ce procesul de backup s-a finalizat deja. Prima opțiune este remedierea serviciului sau a comenzii de oprire a acestuia. Dacă se știe că serviciul se poate termina în siguranță după o perioadă delimitată, o suprascriere systemd per unitate poate limita timpul de așteptare al systemd.
Creați o suprascriere în loc să editați o unitate de furnizor sub /usr/lib/systemd/system:
sudo systemctl edit backup.service
De exemplu:
[Service]
TimeoutStopSec=30s
Apoi reîncărcați configurația unității systemd:
sudo systemctl daemon-reload
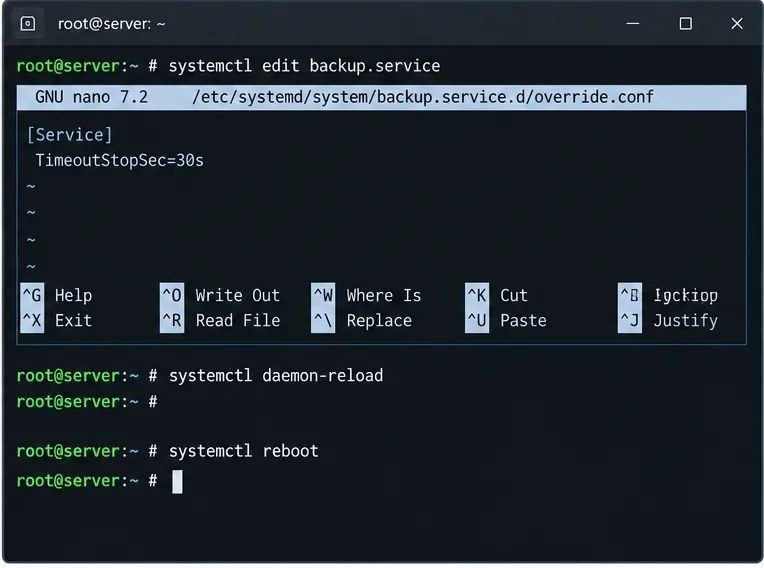
Exemplu ilustrativ: o expirare per serviciu se aplică numai după ce serviciul ipotetic a fost identificat drept blocant.
Nu copiați valoarea de 30 de secunde orbește. Timeout-ul corect depinde de ceea ce serviciul real trebuie să finalizeze în siguranță. Reducerea acestuia pentru o bază de date, un daemon de stocare, un serviciu în cluster sau un proces de backup poate întrerupe curățarea legitimă. Un timeout este o barieră de siguranță, nu un substitut pentru remedierea unei ExecStop=acțiuni defecte sau a unei aplicații care nu se termină corect.
Când sunteți mulțumit de modificare, testați o repornire normală:
sudo systemctl reboot
După ce mașina revine, verificați din nou pornirea anterioară și confirmați că unitatea s-a oprit complet, în loc să dispară pur și simplu din consolă.
O repornire forțată este o opțiune de recuperare, nu o strategie de depanare. Documentația systemd din amonte precizează că o repornire --forcecu systemctl reboot[data] omite închiderea normală a serviciilor, dar totuși oprește procesele și încearcă să demonteze sau să remonteze sistemele de fișiere în modul read-only. Furnizarea --forcede două ori este mai periculoasă, deoarece poate reporni fără a termina procesele sau a demonta sistemele de fișiere, cu riscul de pierdere a datelor.
Dacă serverul este deja blocat și nu există o modalitate mai sigură de a restabili serviciul, o repornire forțată poate fi justificată conform procedurilor operaționale:
sudo systemctl reboot --force
Evitați să tratați systemctl reboot --force --force, o repornire virtuală sau o resetare fizică ca pe o soluție normală. Aceste acțiuni pot elimina dovezile de care aveți nevoie și pot pune în pericol scrierile în timpul operațiunii. Documentația systemctl din amonte distinge în mod explicit comportamentele cu forță simplă și dublă.
Folosește o consolă de mentenanță și pornește în modul de salvare (rescue mode). SUSE documentează adăugarea systemd.unit=rescue.targetla linia de comandă a kernelului din editorul GRUB. Modul de salvare oferă o sesiune root cu sisteme de fișiere locale și servicii de bază, lăsând rețeaua inactivă, ceea ce te poate ajuta să dezactivezi sau să repari serviciul sau configurația de montare problematică.
Consultați Ghidul de administrare SLES 15 SP7 pentru procedura oficială de salvare. Pe sistemele în care problema apare numai după o anumită modificare a pachetului, kernelului, driverului sau spațiului de stocare, examinați și istoricul de întreținere SUSE relevant înainte de a efectua modificări permanente ale timeout-ului.
| Ceea ce vezi | Zona probabilă de inspectat | Cea mai bună acțiune următoare |
|---|---|---|
A stop job is running for xyz.service | Calea de închidere a serviciului | Verificare systemctl status, fișier unitate și jurnal de service |
| Mesaje repetate de demontare sau de sistem de fișiere la distanță | Montare, NFS, CIFS, stocare | Verificați findmnt, montați unități /etc/fstabși accesibilitatea serverului |
| Cererea de repornire este refuzată sau întârziată înainte de oprire | Inhibitor sau o altă lucrare systemd | Aleargă systemd-inhibit --listșisystemctl list-jobs |
| Serviciile sunt oprite, dar închiderea finală nu se finalizează niciodată | Hook pentru închidere târzie, kernel, driver, stocare | Revizuirea jurnalului de pornire anterioară și/usr/lib/systemd/system-shutdown/ |
| Încărcarea normală face reparația imposibilă | Configurație persistentă sau defecțiune a unității | Cizmă cusystemd.unit=rescue.target |
Pentru un server SUSE Linux care se blochează la închiderea systemd, soluția durabilă este identificarea jobului pe care systemd îl așteaptă și corectarea acelei unități sau a dependenței sale. Înregistrați mesajul de închidere, inspectați journalctl -b -1, utilizați systemctl list-jobsși systemctl statuspentru a izola blocatorul și abia apoi modificați o configurație de timeout sau de montare per serviciu. Păstrați metodele de repornire forțată pentru situații de recuperare, nu pentru operațiuni de rutină.
Descarcă FlightGear gratuit de pe site-ul oficial. Compară pachetele Windows, macOS și Linux, instalează fișierele de date și începe primul tău zbor.
Deschide Google Tasks într-un browser, adaugă o comandă rapidă pentru Chrome sau o lansare în stilul aplicației și gestionează activitățile de făcut în avans prin Calendar și Gmail.
OKSampler mapează clipuri MP3 pe tastele tastaturii și poate reda audio în buclă. Află ce face software-ul gratuit vechi, unde se termină funcțiile sale vechi și ce trebuie să verifici înainte de descărcare.
Instalează versiunea Linux a jocului Don't Starve Together prin Steam, creează o lume sau alătură-te prietenilor urmând acești pași de configurare și depanare.
Configurează Squad pe Linux cu Steam Play și Proton, instalează jocul, alege un instrument de compatibilitate și depanează problemele anti-cheat.
Descărcați și verificați fișierul ISO LMDE 5 arhivat, creați un USB bootabil și alegeți setările de instalare sigure. Elsie a ajuns la sfârșitul duratei de viață; consultați versiunea curentă a LMDE.
Creați un USB de instalare Windows 11 pe Linux cu Ventoy: obțineți fișierul ISO oficial, instalați Ventoy în siguranță, copiați imaginea și porniți PC-ul țintă.
Instalați Wireshark pe Ubuntu, Debian, Fedora, Arch sau openSUSE cu comenzile actuale ale pachetului, apoi configurați captura de pachete live în siguranță.
Învață cum să joci DiRT Rally pe Linux dacă îl deții deja pe Steam: instalează versiunea nativă, lansează-l și folosește Proton doar ca soluție de rezervă.
Instalați Devuan Excalibur din fișierul ISO Desktop Live. Verificați descărcarea, creați un USB bootabil, protejați partițiile existente și finalizați configurarea cu Refracta Installer.








