Acasă
» WINDOWS
»
Divizați rapid fișiere XML mari cu un script Python sigur
Divizați rapid fișiere XML mari cu un script Python sigur
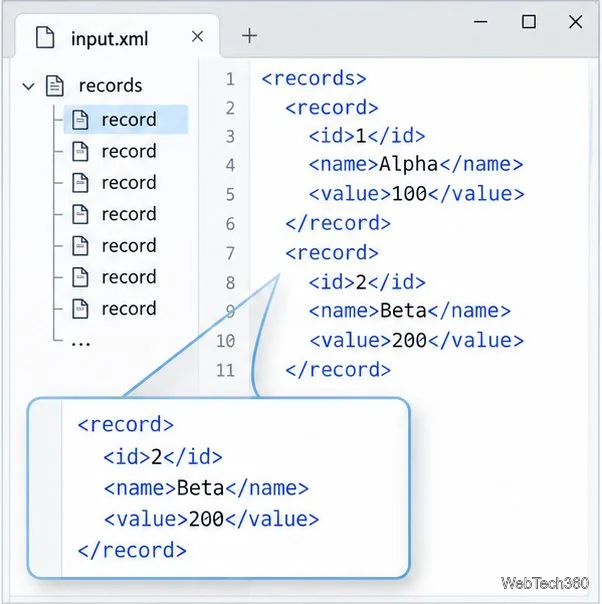
Pentru a diviza rapid un fișier XML mare, divizați-l la nivel de înregistrări repetate complete, în loc să tăiați octeți din fișier. Exemplul de mai jos folosește biblioteca standard Python pentru a transmite în flux datele de intrare și a scrie documente XML separate cu același element rădăcină și atribute rădăcină. Este destinat unei structuri comune, cum ar fi <records><record>...</record><record>...</record></records>, unde fiecare copil direct al elementului rădăcină este o înregistrare independentă.
Împărțit la înregistrările repetate directe de sub rădăcină; limitele arbitrare de octeți pot încălca marcajul XML.
Alegeți un punct de divizare sigur
Un document XML are un element de document, iar etichetele sale trebuie să se imbricate corect. Un separator de fișiere brute poate tăia o etichetă de început, o înregistrare imbricată sau chiar o secvență de codificare a caracterelor, lăsând fragmente care nu sunt XML independente. Specificația XML W3C explică regulile pentru documentele bine formate și elementele rădăcină.
Înainte de divizare, inspectați fișierul și identificați elementul de înregistrare repetat. Acest script tratează fiecare element copil direct de sub rădăcină ca o singură unitate. Folosiți-l numai atunci când acești copii sunt înregistrări independente și rădăcina în sine nu are text mixt semnificativ sau metadate care trebuie să apară într-un anumit loc. Dacă înregistrările sunt imbricate pe mai multe niveluri mai jos, utilizați un divizor conceput pentru vocabularul XML respectiv în loc să modificați scriptul orbește.
Dar cum rămâne cu Split That XML / OOXP Splitter?
Articolul original i-a îndrumat pe cititori către Split That XML. Pagina proiectului SourceForge descrie în continuare utilitarul, dar menționează ultima actualizare ca fiind 27 septembrie 2015. Tratați-l ca pe un software vechi: vechea afirmație de compatibilitate cu Windows nu confirmă suportul pe sistemele actuale. Dacă aveți deja o copie, lucrați la un fișier duplicat și validați rezultatele înainte de a le utiliza.
Divizare înregistrări cu Python
Python xml.etree.ElementTree.iterparse()citește un document incremental, ceea ce evită încărcarea întregului arbore XML în memorie simultan. Scriptul de mai jos grupează elementele direct-child în loturi, apoi scrie fiecare lot într-o copie nouă a etichetei rădăcină și a atributelor originale. Nu necesită niciun pachet terț. Dacă Python nu este instalat, utilizați descărcările oficiale Python pentru Windows ; documentația ElementTree descrie parserul utilizat aici.
Păstrați originalul neatins și alegeți un folder de ieșire nou, gol, pentru fiecare rulare.
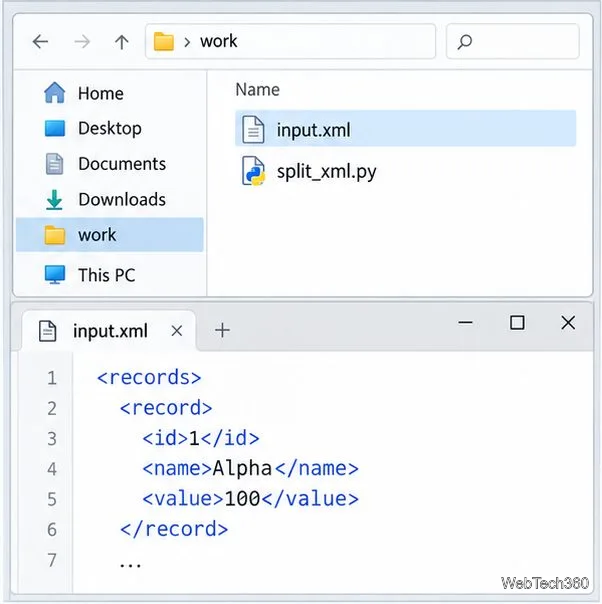
Creați o copie de lucru a fișierului XML sursă. Creați un folder de ieșire nou, gol, cum ar fi parts.
Într-un editor de text simplu, salvați următoarele split_xml.pyîn același folder de lucru ca și copia.
from pathlib import Path
import sys
import xml.etree.ElementTree as ET

source = Path(sys.argv[1])
out_dir = Path(sys.argv[2])
records_per_file = int(sys.argv[3]) if len(sys.argv) > 3 else 500

if records_per_file < 1:
    raise SystemExit("records_per_file must be at least 1")
out_dir.mkdir(parents=True, exist_ok=True)
if any(out_dir.glob("part_*.xml")):
    raise SystemExit("Choose a new, empty output folder first")

records = []
part_count = 0
root = None
root_tag = None
root_attrib = {}

def write_part(items, number):
    wrapper = ET.Element(root_tag, root_attrib)
    wrapper.extend(items)
    target = out_dir / f"part_{number:04d}.xml"
    ET.ElementTree(wrapper).write(
        target, encoding="utf-8", xml_declaration=True
    )

depth = 0
for event, elem in ET.iterparse(source, events=("start", "end")):
    if event == "start":
        depth += 1
        if depth == 1:
            root = elem
            root_tag = elem.tag
            root_attrib = dict(elem.attrib)
    else:
        if depth == 2:
            records.append(elem)
            if len(records) == records_per_file:
                part_count += 1
                write_part(records, part_count)
                records.clear()
                root[:] = []
        depth -= 1

if records:
    part_count += 1
    write_part(records, part_count)
if part_count == 0:
    raise SystemExit("No direct-child elements were found under the root")
print(f"Wrote {part_count} files.")
Executați comanda
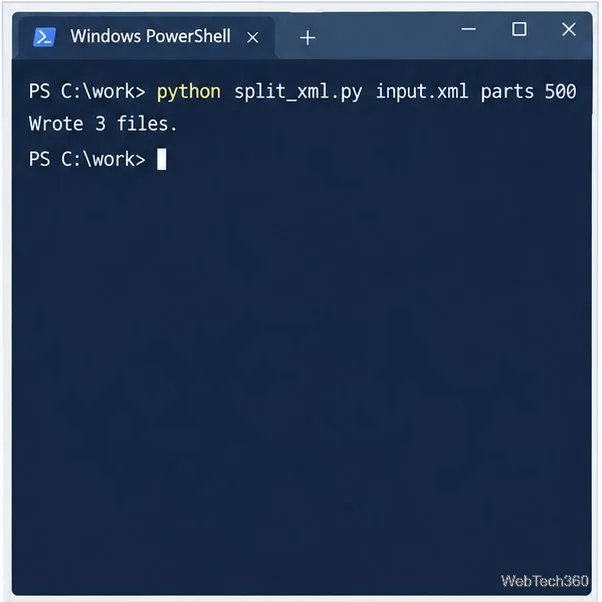
Deschideți PowerShell în folderul de lucru și verificați dacă Python este disponibil. Argumentul final este numărul de înregistrări per componentă; valoarea implicită este 500 dacă o omiteți.
python --version
python split_xml.py input.xml parts 500
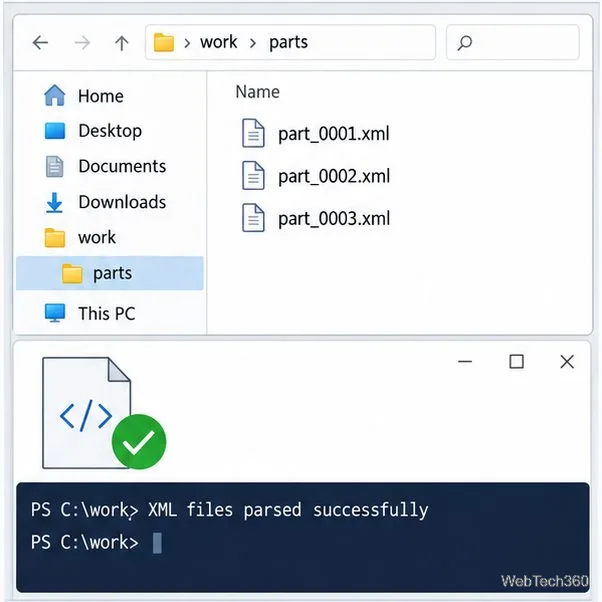
Pe o instalare Windows care utilizează lansatorul Python, a doua linie poate fi py -3 split_xml.py input.xml parts 500. Scriptul scrie fișiere precum part_0001.xmlși raportează câte a creat. Folosește un folder de ieșire gol de fiecare dată; scriptul se oprește dacă există deja fișiere parțiale corespunzătoare, astfel încât să nu amestece în mod silențios o nouă rulare cu resturi.
Al treilea argument al comenzii setează un număr de înregistrări, nu o dimensiune maximă garantată a fișierului.
Verificați rezultatele înainte de importare
Mai întâi, analizați fiecare parte generată pentru a detecta XML-ul incorect. Din PowerShell, executați:
python -c "import glob, xml.etree.ElementTree as ET; files=glob.glob('parts/*.xml'); [ET.parse(p) for p in files]; print(f'{len(files)} files parsed')"
Confirmați că numărul raportat nu este zero, inspectați câteva fișiere și comparați numărul total de înregistrări cu sursa. O analiză reușită dovedește doar că o parte este bine formată . Nu dovedește că aceasta satisface o schemă XML (XSD), un DTD, o regulă de business sau cerințele aplicației care o va consuma. Când acest lucru contează, validați fiecare parte cu schema sau validatorul utilizat de sistemul de destinație. Resursele W3C XML Schema explică rolul separat al constrângerilor de schemă.
Analizează fiecare parte pentru a verifica dacă este bine formată, apoi rulează schema aplicației sau verificările de import separat.
Limite și soluții rapide
O piesă este încă prea mare: reduceți numărul de înregistrări, de exemplu de la 500 la 100. O singură înregistrare mare poate face ca o piesă să depășească dimensiunea țintă; acest script nu impune un plafon strict de megaocteți.
Părțile nu trec de validarea schemei: verificați dacă limita înregistrării alese corespunde structurii și ordinii necesare pentru schemă. Împărțirea poate păstra imbricarea bine formată fără a păstra validitatea la nivel de document.
Prefixe sau formatare modificate: ElementTree poate serializa prefixele spațiului de nume diferit și normalizează reprezentarea XML. Comparați valorile analizate și comportamentul aplicației în loc să așteptați copii octet cu octet.
Sursa folosește DTD-uri, comentarii, instrucțiuni de procesare sau metadate la nivel de rădăcină: acest script simplu nu păstrează fiecare construcție la nivel de document. Folosește un instrument XML care ține cont de vocabular și testează pe o copie.
Pentru o listă obișnuită de înregistrări independente, această abordare vă oferă fișiere ușor de gestionat, analizabile separat, fără a încălca marcajul părinte-copil. Structura înregistrărilor și regulile de validare ale destinației determină dacă părțile rezultate sunt valide și pentru fluxul dvs. de lucru.