Inicio
» ADMINISTRADOR DE RED
»
Cómo configurar el almacenamiento de objetos S3 para ownCloud Infinite Scale
Cómo configurar el almacenamiento de objetos S3 para ownCloud Infinite Scale
ownCloud Infinite Scale puede usar almacenamiento de objetos compatible con S3 para los blobs de archivos, manteniendo los metadatos en un sistema de archivos compatible con POSIX. Esta separación es el primer concepto que hay que entender: S3 no reemplaza directamente cualquier directorio de datos local. En la s3ngconfiguración compatible, el almacenamiento de objetos guarda el contenido binario de los archivos, mientras que los metadatos permanecen en un almacenamiento POSIX, como un sistema de archivos local o NFS.
Esta guía se basa en la documentación actual de ownCloud Infinite Scale Storage, disponible en octubre de 2026. Está dirigida a administradores que no están familiarizados con el s3ngcontrolador y desean una configuración que puedan comprender antes de adaptarla a Docker Compose, systemd, Kubernetes u otro método de implementación.
S3 es una API de almacenamiento de objetos introducida originalmente por Amazon. Un servicio compatible con S3 almacena datos como objetos dentro de un bucket y expone las operaciones a través de API basadas en HTTP. ownCloud Infinite Scale utiliza el s3ngcontrolador de almacenamiento para colocar blobs de archivos en dicho bucket.
El almacenamiento POSIX se refiere a un sistema de archivos que proporciona el comportamiento que Infinite Scale espera para los metadatos. Con s3ng, los metadatos no se mueven al bucket de S3. ownCloud documenta explícitamente que los blobs van a S3, mientras que los metadatos permanecen en el almacenamiento POSIX.
Esta distinción evita un error común: configurar Infinite Scale para que apunte a un bucket y asumir que todo el estado del servidor reside allí. No es así. Su plan de copia de seguridad y recuperación debe abarcar tanto los metadatos del lado POSIX como los blobs del lado S3.
Paso 1: Preparar el bucket, el almacenamiento de metadatos, las credenciales y la ruta de red.
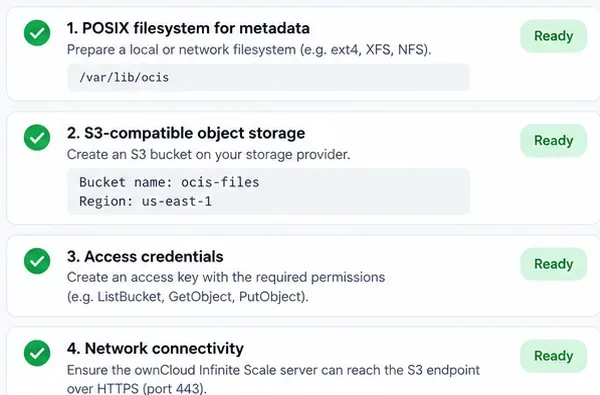
Antes de cambiar la escala infinita, prepare cuatro cosas:
Un bucket S3 dedicado.
Una ruta compatible con POSIX para s3nglos metadatos. Para una implementación de varios nodos, ownCloud recomienda considerar cuidadosamente el almacenamiento compartido; NFS se usa comúnmente cuando varias instancias de Infinite Scale necesitan acceso a la ruta de metadatos.
Una clave de acceso y una clave secreta con solo los permisos de bucket que requiere Infinite Scale.
Accesibilidad de red desde el host o contenedor de Infinite Scale al punto final de S3, normalmente a través de HTTPS.
Antes de editar la configuración de Infinite Scale, prepare la ruta de metadatos POSIX, el bucket de S3, las credenciales y la conectividad de red.
No haga público el bucket. Infinite Scale se autentica en el bucket mediante credenciales; el acceso público no es necesario ni deseable. Además, evite reutilizar credenciales de administrador generales cuando se puede crear una identidad de servicio dedicada.
Si utiliza Amazon S3, el punto final y la región siguen las convenciones de AWS. Si utiliza otro proveedor compatible con S3, consulte la documentación del proveedor para confirmar el formato del punto final, el comportamiento de la región, los requisitos de TLS y la sintaxis de la política. ownCloud advierte específicamente que ciertos aspectos, como los detalles de cifrado, pueden variar entre proveedores.
Paso 2: Habilite el controlador s3ng y proporcione la configuración de conexión S3.
La configuración de almacenamiento principal es STORAGE_USERS_DRIVER=s3ng. El servicio Storage-Users es el componente de escala infinita responsable del almacenamiento de archivos de usuario. La configuración oficial también mantiene el controlador de almacenamiento del sistema en el ocisbackend normal.
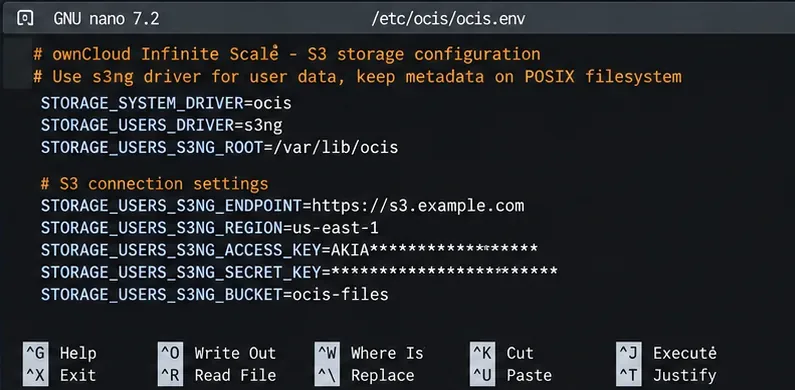
Un conjunto mínimo de variables de entorno tiene este aspecto:
Las variables de entorno esenciales de s3ng conectan el servicio Storage-Users con S3, preservando al mismo tiempo los metadatos en el almacenamiento POSIX.
Los valores de ejemplo son marcadores de posición. Utilice el punto final, la región, el bucket y las credenciales proporcionadas por su proveedor. No guarde la clave secreta en un repositorio Git público. En la orquestación de contenedores, prefiera el mecanismo de gestión de secretos de la plataforma en lugar de insertar las credenciales directamente en un archivo Compose o manifiesto.
El método de despliegue determina la ubicación de estas variables. Un despliegue con Docker Compose puede colocarlas en la environmentsección del servicio Infinite Scale o cargarlas desde un archivo de entorno. Un despliegue con systemd puede usar un archivo de entorno o la configuración de una unidad. Kubernetes suele inyectarlas mediante un Secret y un Deployment o StatefulSet. Los nombres de las variables son lo importante; la sintaxis que las rodea depende de la plataforma.
Paso 3: Otorgue al bucket los permisos que Infinite Scale necesita.
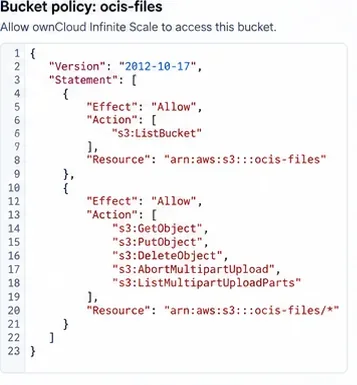
Una política de bucket es una regla de administración de identidades y accesos (IAM) que controla las acciones que una identidad autenticada puede realizar sobre un bucket y sus objetos. ownCloud publica un patrón de política obligatorio para el s3ngcontrolador.
Reemplace bucket-nameen la siguiente política con el nombre real de su bucket:
La estructura de la política debe permitir la inclusión de archivos en la lista de contenedores, así como las operaciones de carga de objetos y multipartes requeridas por el controlador s3ng. Utilice la política exacta que aparece en la documentación oficial para su implementación.
No solucione un error de acceso denegado otorgando permisos s3:*a todos los buckets de la cuenta. Comience con los permisos documentados específicos para cada bucket y, ajústelos solo cuando su proveedor de S3 requiera un equivalente específico.
Paso 4: Reinicie Infinite Scale y verifique la ruta de almacenamiento.
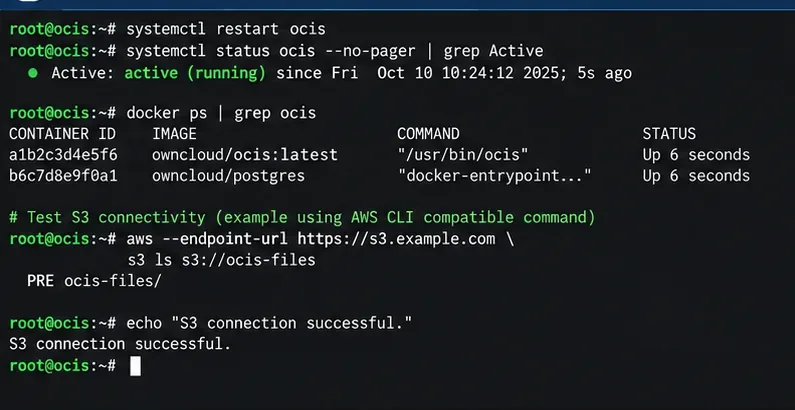
Aplique la configuración mediante el procedimiento de reinicio habitual para su implementación. Por ejemplo, una instalación de systemd podría usar systemctl restart ocis, mientras que una implementación de Compose recrearía o reiniciaría los contenedores de servicio afectados. Revise los registros inmediatamente después del inicio para detectar errores de autenticación, DNS, TLS, región o permisos.
Tras aplicar la configuración, reinicie los servicios de Infinite Scale pertinentes y verifique que el host pueda acceder al bucket deseado y autenticarse en él.
La visualización del bucket mediante la interfaz de línea de comandos (CLI) de su proveedor de S3 demuestra que el host y las credenciales pueden acceder al bucket, pero no prueba por sí sola que Infinite Scale esté escribiendo correctamente los blobs. La mejor prueba integral consiste en iniciar Infinite Scale, cargar un archivo pequeño a través de la interfaz web de ownCloud, descargarlo nuevamente y revisar los registros del servicio en busca de errores.
Si la versión de Infinite Scale instalada incluye el comando de mantenimiento del blobstore documentado por ownCloud, también puede usarlo ocis storage-users blobstore check. ownCloud describe este comando como un ciclo completo de carga, descarga y eliminación en el blobstore configurado. Consulte la documentación oficial de verificación del blobstore para conocer la sintaxis específica de la versión.
No espere que los nombres de archivo originales aparezcan como objetos S3 normales.
Uno de los errores más comunes es buscar en el bucket una estructura de carpetas de usuario familiar, como por ejemplo Documents/report.pdf. Infinite Scale trata S3 como un almacén de blobs, no como un sistema de archivos para el usuario. El s3ngformato de clave documentado se basa en identificadores de espacio e identificadores de blobs, mientras que el espacio de nombres legible se reconstruye a partir de metadatos.
Esto significa que no debes renombrar, reorganizar ni eliminar manualmente los objetos dentro del bucket solo porque sus claves parezcan desconocidas. Gestiona los archivos de usuario a través de ownCloud. La manipulación directa del bucket puede romper la relación entre los metadatos y los blobs.
Cargas grandes: compruebe el tamaño de la parte multiparte antes de la producción.
S3 utiliza la carga multiparte para dividir los objetos grandes en partes. ownCloud documenta STORAGE_USERS_S3NG_PUT_OBJECT_PART_SIZEcómo controlar el tamaño de las partes. El valor predeterminado documentado es de 16 MiB cuando no se especifica ningún valor.
Amazon S3 permite un máximo de 10 000 partes en una carga multiparte. Con un tamaño de parte de 16 MiB, esto equivale aproximadamente a 160 GiB antes de que el límite de partes se convierta en un problema. Si sus usuarios suben archivos grandes con frecuencia, calcule el tamaño de parte necesario antes de la puesta en marcha, en lugar de esperar a que falle una transferencia grande.
La disyuntiva es clara: las partes más grandes admiten archivos máximos de mayor tamaño con menos solicitudes, pero también modifican las características de memoria, almacenamiento en búfer, reintentos y transferencia. ownCloud también señala que los datos de archivos entrantes necesitan almacenamiento temporal mientras se almacenan en búfer, por lo que la planificación de la capacidad debe incluir más que solo el bucket remoto.
Problemas comunes y qué revisar primero
Síntoma
Área probable
Primera comprobación
Acceso denegado
Política de credenciales o de bucket
Confirme la clave de acceso, la clave secreta, el ARN del bucket y las acciones requeridas.
Cubo no encontrado
Nombre del bucket, punto final o región
Verifique el nombre exacto del bucket y la combinación de punto final/región específica del proveedor.
Error de TLS o certificado
Confianza HTTPS
Confirme que el certificado del punto final sea válido y de confianza dentro del host/contenedor de Infinite Scale.
Los archivos pequeños funcionan, pero los archivos muy grandes fallan.
Dimensionamiento de varias partes
Revise STORAGE_USERS_S3NG_PUT_OBJECT_PART_SIZElos límites de envíos múltiples de su proveedor.
Los archivos desaparecen después de restaurar solo S3.
Copia de seguridad incompleta
Restaurar los metadatos POSIX y los blobs de S3 como un conjunto de datos coherente.
Realizar copias de seguridad de los blobs S3 y los metadatos POSIX juntos
Con s3ng, el bucket representa solo la mitad del estado de almacenamiento. La documentación de copias de seguridad de ownCloud indica que una configuración distribuida de S3 debe incluir la configuración, los datos del sistema, los metadatos y los blobs. La documentación de restauración también exige que estos conjuntos de datos se restauren de forma consistente.
Para un servicio de producción, documente el montaje de metadatos, el bucket, las credenciales o el rol, los archivos de configuración y el procedimiento de copia de seguridad en el mismo manual de procedimientos. Pruebe la recuperación antes de confiar en el diseño. Las referencias oficiales pertinentes son la guía de copia de seguridad de ownCloud y las consideraciones de restauración .
Punto de partida recomendado
Para una primera implementación, mantenga el diseño simple: use un bucket S3 dedicado para blobs, una ruta de metadatos POSIX persistente, una identidad de servicio dedicada con los permisos de bucket documentados, HTTPS al punto final de almacenamiento de objetos y la configuración multipart predeterminada, a menos que los tamaños de archivo esperados requieran un cambio.
Tras la configuración, valide por separado tres capas: el acceso a la red y las credenciales del bucket, el inicio de Infinite Scale sin errores de almacenamiento y una carga/descarga real a través de ownCloud. Una vez superadas estas comprobaciones, continúe con la monitorización, las copias de seguridad, las reglas del ciclo de vida y la optimización del rendimiento. Esta secuencia facilita enormemente la resolución de problemas, ya que cada prueba responde a una pregunta diferente en lugar de considerar que «S3 funciona» es un resultado único de todo o nada.