Accueil
» LINUX
»
Comment configurer un cluster à haute disponibilité (HAE) sous SUSE Linux 15
Comment configurer un cluster à haute disponibilité (HAE) sous SUSE Linux 15
Ce guide d'initiation explique comment créer un cluster actif/passif à deux nœuds avec SUSE Linux Enterprise High Availability (SLE HA) 15. Il utilise les scripts d'amorçage CRM Shell : initialisez le premier nœud avec `sudo apt-get start` crm cluster init, ajoutez le second avec `sudo apt-get start` crm cluster join, vérifiez l'appartenance au cluster et testez un basculement planifié de l'adresse IP virtuelle de gestion. Les exemples suivent la documentation SUSE SLE HA 15 SP7, publiée le 24 septembre 2026 ; les invites peuvent varier selon le Service Pack, le matériel et la plateforme.
L'abréviation « HAE » est souvent utilisée de manière informelle pour désigner l'extension de haute disponibilité. La documentation produit actuelle de SUSE l'appelle SUSE Linux Enterprise High Availability, ou SLE HA. Cette procédure fournit une infrastructure de cluster fonctionnelle et un accès à la gestion Hawk2. Elle ne garantit pas automatiquement la haute disponibilité d'une application, d'une base de données ou de ses données ; ces éléments nécessitent leurs propres ressources Pacemaker, une architecture de stockage adaptée et des tests spécifiques à la charge de travail.
Les illustrations ci-dessous, représentant le terminal et l'écran Hawk2, sont des exemples d'interface et non des captures d'écran d'un système en production. Les noms et adresses sont donnés à titre d'exemple ; veuillez les remplacer par les valeurs de votre réseau.
Que fera ce cluster ?
Un cluster est un groupe de serveurs, appelés nœuds , qui se coordonnent pour assurer le fonctionnement de services spécifiques. Corosync gère l'appartenance des nœuds et la messagerie du cluster. Pacemaker, le gestionnaire de ressources du cluster, détermine l'emplacement d'exécution des ressources gérées et intervient en cas de panne. Une ressource est un service ou une adresse que Pacemaker peut démarrer, arrêter, surveiller et déplacer.
Dans ce guide, les alicenœuds bobforment un cluster à deux nœuds. Une adresse IP de gestion flottante offre aux administrateurs une adresse stable pour Hawk2, l'interface web de SUSE. Si un nœud est mis en veille, Pacemaker peut transférer cette adresse IP vers l'autre nœud. Pour un cluster de production à deux nœuds, SUSE recommande l'ajout de QDevice/QNetd pour la gestion du quorum et exige le cloisonnement des nœuds.
Que devez-vous préparer avant l'installation ?
Deux systèmes SUSE Linux Enterprise Server 15 pris en charge, exécutant le même pack de services et la même architecture de processeur, avec root ou un compte sudo disposant des privilèges appropriés.
Enregistrement SUSE valide et droit à la haute disponibilité SLE sur chaque nœud. L'extension et le modèle de paquet doivent correspondre au Service Pack et à l'architecture SLES.
Adresses de nœuds statiques, résolution de noms fonctionnelle, horloges synchronisées et connectivité réseau fiable du cluster. Choisissez judicieusement l'interface Corosync prévue ; des chemins séparés ou redondants sont utiles dans les architectures de production.
Plan de protection. La protection (STONITH, « Tirer sur l'autre nœud à la tête ») isole ou redémarre de force un nœud potentiellement défaillant, empêchant ainsi les deux côtés d'un réseau divisé d'écrire dans les données partagées. La protection doit être activée pour qu'un cluster compatible le permette.
Si vous utilisez un périphérique STONITH Block Device (SBD), un système de surveillance adapté doit être installé sur chaque nœud, ainsi qu'un stockage de blocs partagé correctement conçu avec un chemin d'accès stable. Un système de surveillance matériel est recommandé en production. Si vous utilisez une barrière d'alimentation physique, configurez et testez un périphérique STONITH compatible.
Pour un cluster à deux nœuds, prévoyez un témoin QDevice/QNetd avant l'initialisation si vous comptez le configurer via le processus d'amorçage. Ce témoin permet au cluster de déterminer quel nœud possède le quorum en cas de perte de connectivité.
Ne considérez pas une configuration de laboratoire comme étant prête pour la production. La configuration système requise pour SLE HA 15 SP7 de SUSE exige le cloisonnement du réseau, et son guide d'installation recommande de tester la configuration avec deux ou trois nœuds avant de l'étendre.
Étape 1 : Installez l’extension et les packages SLE HA
Si la haute disponibilité SLE n'a pas été sélectionnée lors de l'installation de SLES, activez l'extension sur chaque nœud. Pour un hôte SLES 15 SP7 x86_64 enregistré, la procédure documentée est la suivante :
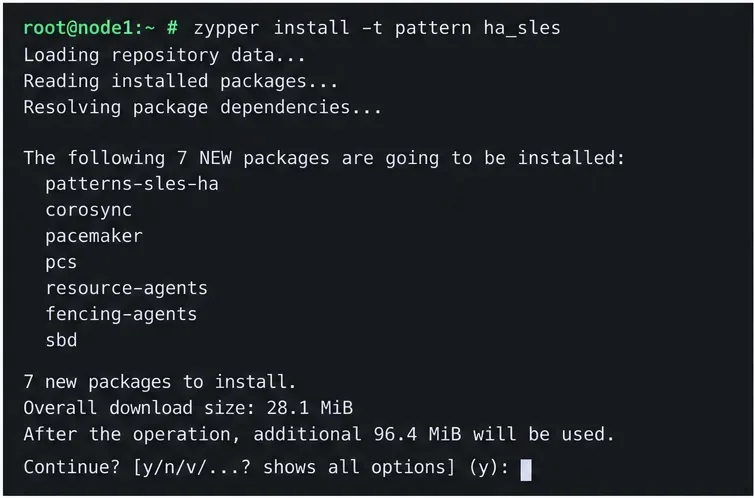
Remplacez ADDITIONAL_REGCODEpar le code d'enregistrement SLE HA. Utilisez l'identifiant de produit d'activation correspondant à votre Service Pack et à votre architecture ; ne copiez pas l'exemple SP7 vers un autre Service Pack SLES 15. Exécutez la commande `package-pattern` sur les deux nœuds. SUSE définit le ha_slesmodèle comme l'ensemble des paquets utilisés pour configurer et gérer le cluster.
Vue terminale de la commande d'installation du modèle de haute disponibilité sur le premier nœud.
Étape 2 : Préparer les noms, l’heure et l’accès au réseau
Attribuez aux deux nœuds des noms d'hôte stables et des adresses IP principales statiques. Vérifiez que chaque nœud peut résoudre l'autre par son nom court et son nom de domaine complet. Le guide d'installation de SUSE recommande d'ajouter les membres du cluster au /etc/hostsbesoin, car les échecs de résolution de noms peuvent interrompre la communication interne. Par exemple, adaptez les entrées suivantes à votre configuration DNS et à votre plan d'adressage :
10.20.0.11 alice.example.net alice
10.20.0.12 bob.example.net bob
Synchronisez les deux horloges avec une source NTP externe au cluster et assurez-vous que leurs fuseaux horaires soient identiques. Chrony est le serveur NTP par défaut sur SLES 15. Vérifiez la connectivité du réseau que vous prévoyez d'utiliser pour Corosync. Les scripts d'amorçage peuvent ouvrir les ports du pare-feu nécessaires à la communication du cluster, mais vérifiez que les pare-feu de votre hôte et de votre réseau autorisent le trafic requis par la topologie choisie. Le mode unicast est utilisé par défaut lors de l'amorçage ; le port Corosync par défaut documenté est le 5405.
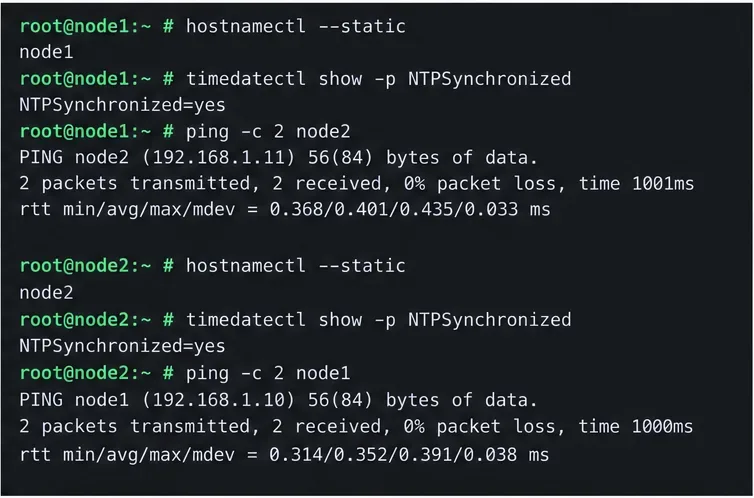
Les vérifications préalables confirment les noms des nœuds d'exemple, les horloges synchronisées et la connectivité des pairs.
Étape 3 : Initialiser le premier nœud
Pour aliceexécuter la commande bootstrap en tant que root :
crm cluster init --name demo-ha
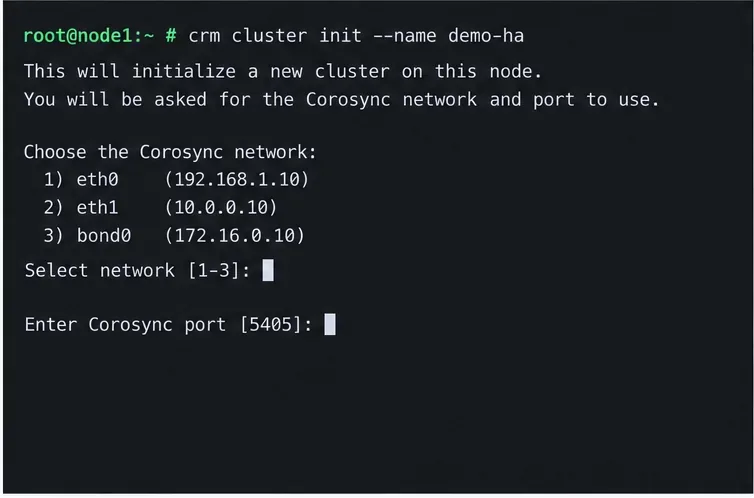
Veuillez lire attentivement les invites avant de les accepter. Sélectionnez l'interface et l'adresse réseau destinées à Corosync, puis confirmez le port. Le script vérifie la synchronisation de l'heure et la disponibilité du watchdog, et peut préparer les clés SSH ainsi que la configuration du cluster. Il vous demandera si vous souhaitez configurer SBD, une adresse IP virtuelle d'administration Hawk2 et QDevice/QNetd. SBD requiert que le watchdog et le périphérique partagé soient déjà opérationnels. Si vous configurez QDevice lors de cette initialisation, préparez d'abord le serveur QNetd. Le script crée un cluster à un seul nœud fonctionnel ; il n'ajoute aucun périphérique bobà ce stade.
Ne choisissez pas un disque partagé ou un chemin d'accès aléatoire pour SBD. Ce chemin doit identifier le même espace de stockage approprié sur chaque nœud, et son comportement en cas de panne ainsi que ses délais d'expiration doivent correspondre à la conception du stockage. SUSE indique qu'il softdogest impossible de redémarrer une machine si tous les processeurs sont bloqués ; utilisez donc le système de surveillance matériel approprié en production, lorsqu'il est disponible.
Le premier nœud d'amorçage demande le réseau de communication du cluster et le port Corosync.
Étape 4 : Rejoignez le deuxième nœud
Une fois le premier nœud initialisé, connectez-vous bobet exécutez :
crm cluster join
Suivez les instructions pour identifier le nœud du cluster existant alice. Si vous avez utilisé un compte sudo plutôt que root pour le premier nœud, consultez la documentation SUSE expliquant comment spécifier ce compte avec -c, par exemple :
sudo crm cluster join -c USER@alice
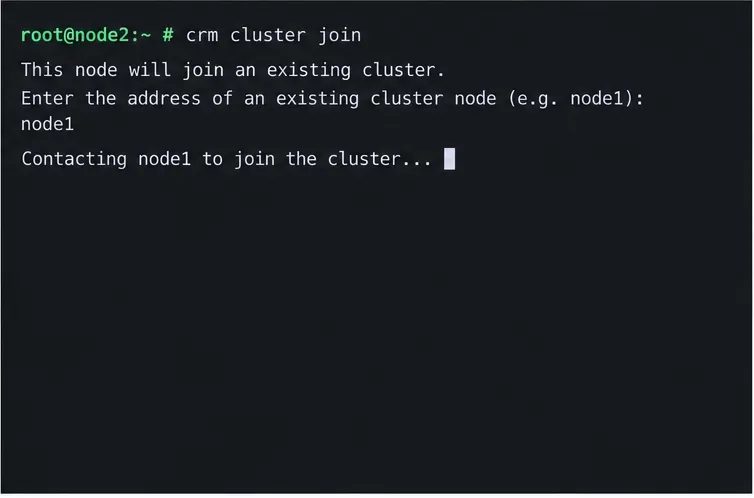
Le script d'intégration copie la configuration Corosync, configure SSH et Csync2, met la machine actuelle en ligne en tant que nœud du cluster et démarre le service nécessaire à Hawk2. N'initialisez pas les deux machines indépendamment ; le second nœud doit rejoindre le cluster créé par le premier.
Exécutez le flux de travail de jointure sur le deuxième nœud et pointez-le vers le premier nœud initialisé.
Étape 5 : Vérifiez que les deux nœuds sont en ligne.
Depuis l'un ou l'autre nœud, consultez le résumé du cluster :
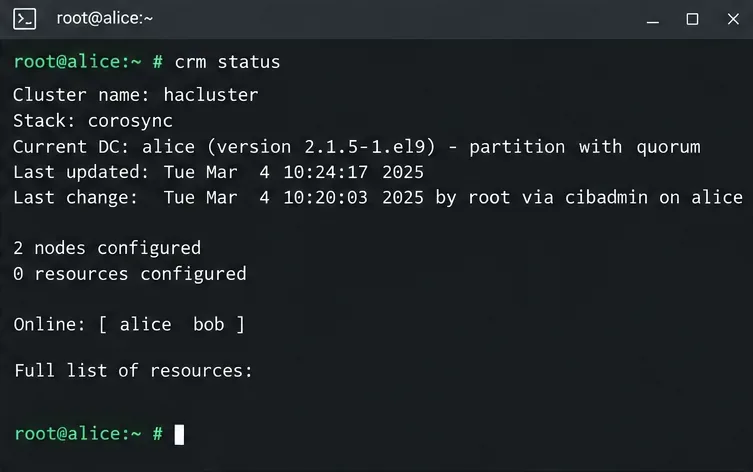
crm status
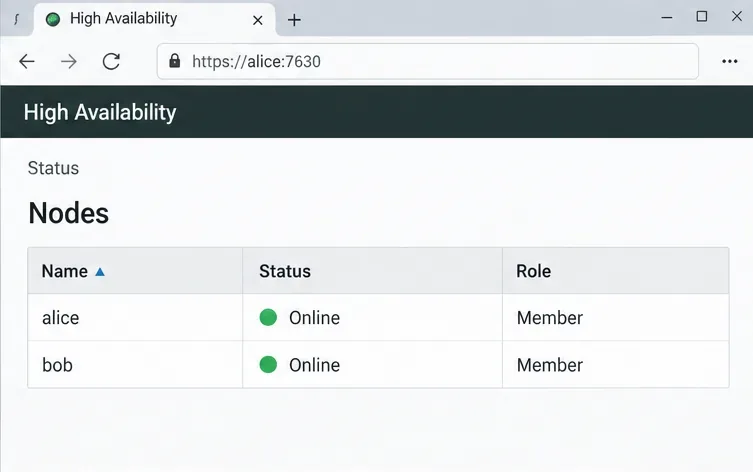
Recherchez les noms des nœuds Onlineet une partition de cluster avec quorum. Avant de poursuivre, vérifiez l'absence d'échecs d'opérations ou de nœuds hors ligne. Vous pouvez également vous connecter à Hawk2 via l'adresse IP virtuelle d'administration sélectionnée lors de l'initialisation, généralement à l'adresse indiquée https://ADMIN-VIP:7630/. Un avertissement de certificat peut s'afficher lors de la première visite si un certificat auto-signé est utilisé ; vérifiez les détails du certificat auprès de l'administrateur du cluster au lieu d'ignorer un certificat inconnu en environnement de production.
Une vérification de l'état du cluster doit indiquer que les deux nœuds sont en ligne avant de tester le basculement.La liste des nœuds offre une seconde méthode pour confirmer l'appartenance au cluster.
Étape 6 : Sécuriser le compte de gestion
La procédure d'amorçage crée un haclustercompte pour Hawk2. Le guide d'installation de SUSE indique un mot de passe par défaut lors de la configuration initiale ; modifiez-le immédiatement avant de laisser le système accessible.
passwd hacluster
Utilisez un mot de passe unique et robuste et respectez la politique d'authentification de votre organisation. Limitez l'accès au réseau de gestion Hawk2, installez les certificats de confiance nécessaires et ne rendez pas l'interface de gestion accessible directement depuis Internet.
Étape 7 : Tester en toute sécurité un basculement planifié
Un test de secours planifié vérifie si l'adresse IP virtuelle de gestion peut se déplacer lorsqu'un nœud est intentionnellement retiré du placement des ressources. Avant le test, assurez-vous que les deux nœuds sont opérationnels, que le quorum est atteint et que vous disposez d'un accès console ou hors bande en cas de comportement inattendu. Depuis un client du même réseau, effectuez un ping continu vers l'adresse IP virtuelle de gestion, par exemple :
ping 10.20.0.20
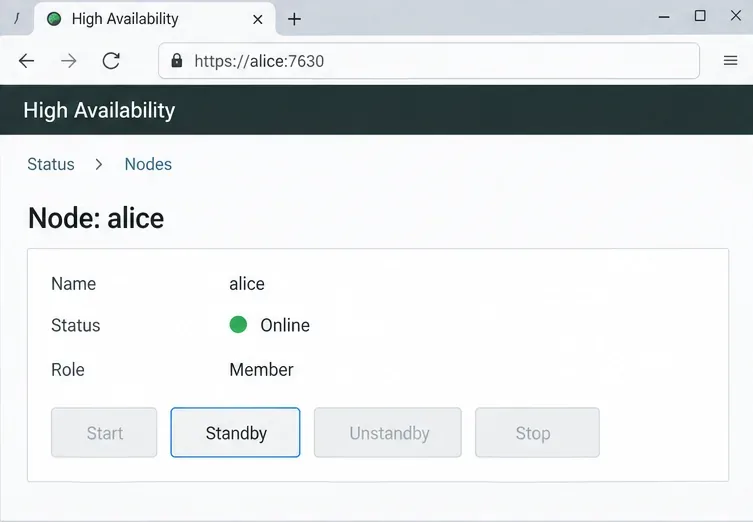
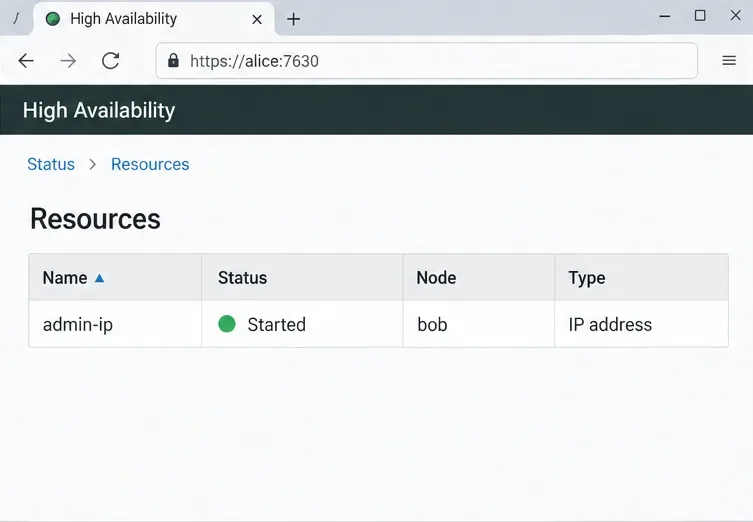
Dans Hawk2, ouvrez le nœud hébergeant actuellement l'adresse IP d'administration et sélectionnez Veille . Consultez ensuite État > Ressources . Le guide de démarrage rapide de SUSE explique comment la ressource flottante se déplace vers l'autre nœud pendant que le ping se poursuit. Une fois le test terminé, remettez le nœud en service à l'aide de l'action correspondante dans Hawk2, vérifiez que les deux nœuds sont en ligne et assurez-vous que la ressource se trouve à l'emplacement prévu.
Utilisez une action de mise en veille planifiée sur le nœud actif pour tester le déplacement des ressources sans simuler une panne.Après la mise en veille, vérifiez que l'adresse IP d'administration est bien active sur l'autre nœud.
Que prouve ce test, et que ne prouve-t-il pas ?
Si les deux nœuds restent visibles et que l'adresse IP d'administration bascule vers le nœud homologue, cela prouve que l'appartenance au cluster et la ressource d'adresse IP flottante fonctionnent correctement dans ce scénario. Un simple ping ne suffit pas à démontrer la disponibilité d'une application, la continuité des sessions client, la protection des données partagées ni la capacité du cluster à se rétablir après toute panne réseau, de stockage, d'alimentation ou logicielle.
Pour une application, ajoutez l'agent de ressources approprié et configurez l'ordonnancement, la colocation, la surveillance, l'accès au stockage et le fencing conformément à sa conception. Ne laissez jamais deux nœuds écrire simultanément sur un stockage partagé ordinaire. Testez la reprise de la charge de travail et l'intégrité des données dans un environnement de préproduction, en simulant des pannes de nœuds et de réseau réalistes, avant la mise en production.
Erreurs courantes à éviter
Ignorer la clôture : un cluster sans STONITH fonctionnel ne peut pas résoudre en toute sécurité le split-brain et ne répond pas aux exigences de support de SUSE.
En supposant que deux nœuds puissent décider seuls : prévoyez QDevice/QNetd pour un cluster à nombre pair, en particulier un cluster à deux nœuds.
Utilisation d'une identité de nœud instable ou non concordante : utilisez des adresses statiques, des noms d'hôtes cohérents, une résolution de noms directe et inverse fonctionnelle et une heure synchronisée.
Réutilisation d'un réseau incorrect : sélectionnez l'interface Corosync prévue et vérifiez la politique de pare-feu sur chaque chemin réseau.
En supposant que le cluster protège automatiquement une application : un cluster ne peut gérer que les ressources qui ont été configurées et testées.
Qualifier la configuration initiale de « prête pour la production » : le démarrage rapide correspond à une configuration de base. La préparation à la production requiert des tests de récupération spécifiques à la charge de travail, la validation du périmètre de sécurité, la surveillance, les procédures de sauvegarde et de restauration, ainsi que des opérations documentées.