Si un serveur SUSE Linux semble se bloquer lors du redémarrage suite à un message d'arrêt de systemd, il est préférable de ne pas incriminer la commande de redémarrage elle-même. Dans la plupart des cas, systemd attend la fin d'une opération (unité, montage, processus ou hook d'arrêt). La solution la plus sûre consiste donc à identifier précisément la tâche en cours, à examiner pourquoi elle ne s'arrête pas et à corriger ce composant, plutôt que de réduire globalement les délais d'arrêt.
Ce guide utilise un exemple hypothétique : un serveur nommé lab-sles01exécute SUSE Linux Enterprise Server et se bloque lors du redémarrage avec un message similaire à celui-ci A stop job is running for backup.service. Cet exemple illustre uniquement la méthode de diagnostic ; il ne s’agit pas d’un rapport de test réel ni d’une affirmation selon laquelle une version particulière de SUSE présenterait un défaut dans un service nommé backup.service.
La solution en quatre étapes, en bref
| Étape | Ce qu'il faut faire | Ce que vous essayez d'apprendre |
|---|
| 1 | Enregistrez le message d'arrêt exact | Quelle unité ou étape bloque la progression |
| 2 | Consultez le journal de démarrage précédent | Que ce soit dû à un délai d'arrêt expiré, à un échec de démontage ou à une étape ultérieure de l'arrêt, ou à un stade plus avancé de celui-ci. |
| 3 | Inspectez l'unité de blocage et les emplois en direct | Qu'il s'agisse d'un service, d'un montage, d'un inhibiteur ou d'une dépendance responsable |
| 4 | Corrigez la cause première et effectuez un nouveau test. | Qu'une activité normale systemctl rebootse termine maintenant sans délai |
Étape 1 : Enregistrez précisément l’endroit où l’arrêt s’arrête.
Surveillez la console locale, la console de la machine virtuelle, la console BMC/IPMI ou la console de l'hyperviseur lors d'un redémarrage planifié. Une ligne mentionnant le nom d'une unité est bien plus utile qu'une description générale telle que « systemd bloqué ». Par exemple lab-sles01, supposons que la console indique que systemd backup.serviceest toujours en cours d'arrêt alors que d'autres unités sont déjà arrêtées.
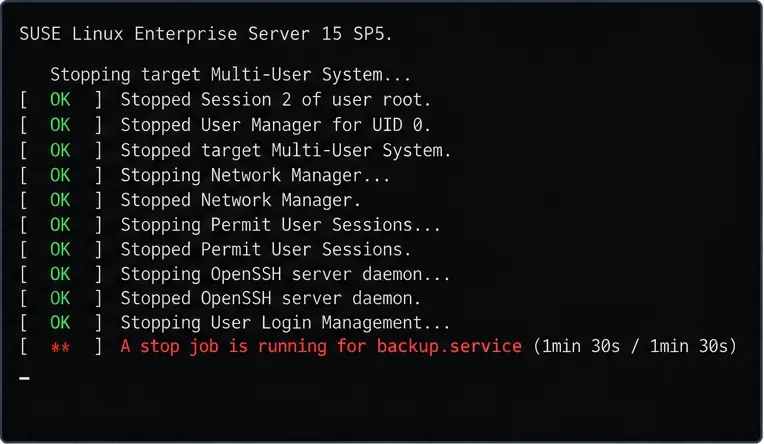
Exemple illustratif : la console d’arrêt s’identifie backup.servicecomme l’unité que systemd attend toujours.
Si la console mentionne une .mountunité, un système de fichiers réseau, un périphérique ou un autre service, suivez ce nom plutôt que d'appliquer un délai d'expiration générique. L'unité affichée en bas de la console est un indice, et non la cause première : elle peut elle-même être en attente d'un processus enfant, d'un espace de stockage, d'une entrée/sortie réseau ou d'une autre dépendance.
Les recommandations actuelles de SUSE concernant systemd indiquent qu'un redémarrage ou une mise hors tension prolongée peut être dû à un service qui ne s'arrête pas et recommandent de vérifier les tâches systemd. Voir SUSE Linux Enterprise Server 16.0 : Introduction aux bases de systemd .
Étape 2 : Utilisez le journal de démarrage précédent après le retour du serveur.
Une fois la machine redémarrée, examinez l'arrêt qui vient de se produire. SUSE documente les décalages de démarrage dans le journal : « boot » 0correspond au démarrage actuel, -1« première » au démarrage précédent, etc. Commencez par :
sudo journalctl --list-boots
sudo journalctl -b -1
Pour un journal volumineux, l'ordre inverse permet de faire apparaître les derniers messages plus rapidement :
sudo journalctl -b -1 -r
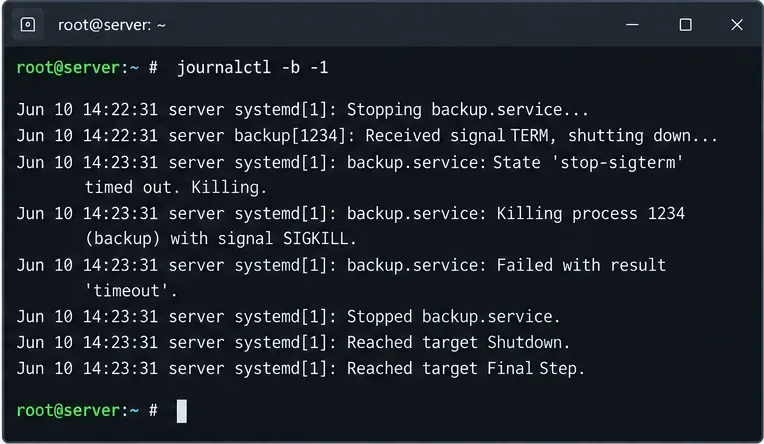
Exemple illustratif : le journal de démarrage précédent montre le service de sauvegarde hypothétique recevant le signal SIGTERM et expirant par la suite.
Recherchez des expressions telles que Stopping« ,stop job » timed out, Failed with result« , » Unmounting, «Dependency failed , » ou des messages provenant du service suspecté. Vous pouvez affiner votre recherche une fois que vous connaissez le nom de l'unité :
sudo journalctl -b -1 -u backup.service
La documentation SUSE journalctl -b -1relative à l'analyse des démarrages précédents se trouve dans la documentation du journal SLES 15 SP7 . Si journalctl --list-bootsce journal ne contient pas l'historique de démarrage précédent, ne tirez pas de conclusions hâtives ; vérifiez la configuration du stockage journald et utilisez la console ou la journalisation à distance pour reproduire le problème.
Étape 3 : Identifier si le blocage est un service, un montage, un inhibiteur ou un hook d’arrêt tardif
Si vous parvenez à reproduire le problème pendant une fenêtre de maintenance, conservez une seconde console d'administration disponible. Avant que la connexion ne soit interrompue, exécutez :
sudo systemctl list-jobs
sudo systemctl status backup.service
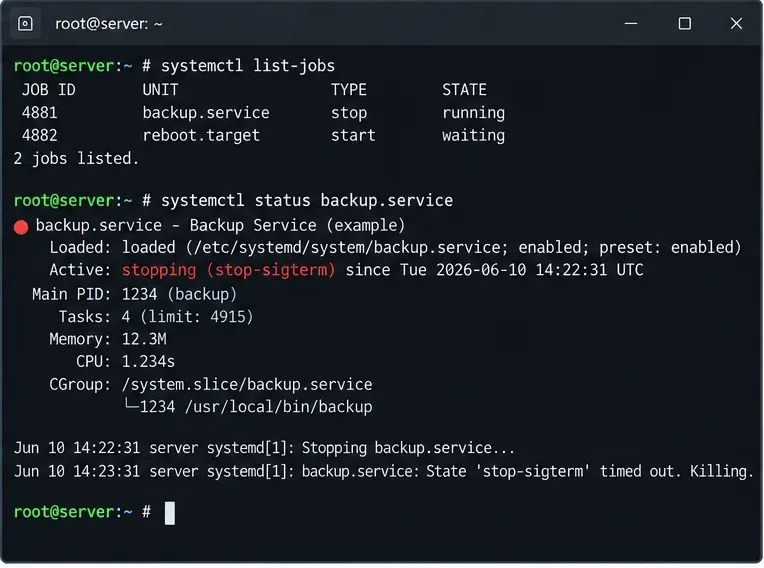
Exemple illustratif : backup.serviceune tâche d’arrêt est en cours d’exécution tandis que la cible de redémarrage attend derrière elle.
Les instructions de débogage de systemd en amont expliquent que les tâches affichées runningdoivent se terminer avant que les tâches dépendantes affichées waitingpuissent se poursuivre. SUSE recommande également cette commande systemctl list-jobslorsque l'arrêt ou le redémarrage prend trop de temps. Cela rend cette commande particulièrement utile lorsque le serveur n'est pas complètement bloqué et que le processus 1 répond encore.
Si un service s'arrête trop lentement
Examinez la définition de l'unité et son comportement à l'arrêt :
sudo systemctl cat backup.service
sudo systemctl status backup.service
sudo journalctl -u backup.service -b
Vérifiez si le service a une ExecStop=action en cours, si son processus gère le signal SIGTERM et s'il attend des ressources de stockage ou réseau. Une base de données, un agent de sauvegarde ou un service intermédiaire peut légitimement avoir besoin de temps pour vider les données ; l'arrêter prématurément ne résout donc pas automatiquement le problème.
Si un montage ou un système de fichiers réseau est impliqué
Recherchez les opérations de démontage ayant échoué et identifiez la source du montage :
findmnt
systemctl list-units --type=mount
sudo journalctl -b -1 | grep -Ei 'unmount|umount|mount|nfs|cifs'
Pour NFS ou CIFS, vérifiez l'accessibilité du serveur, les sessions inactives et la conformité des options de montage avec les exigences d'arrêt du serveur. Si l'unité bloquée provient de /etc/fstab, corrigez la configuration de montage au lieu d'appliquer un délai d'expiration spécifique au service à une unité non liée.
Si la demande de redémarrage est inhibée
Avant le début de l'arrêt, vous pouvez lister les inhibiteurs systemd actifs :
systemd-inhibit --list
Les verrous d'inhibition peuvent bloquer ou retarder les demandes d'arrêt pendant qu'une application effectue des tâches qui ne doivent pas être interrompues. Ils sont particulièrement utiles lorsque la demande de redémarrage est retardée avant que le système n'ait entamé sa séquence d'arrêt finale. Consultez la documentation de systemd-inhibit .
Si le blocage survient après que les services soient déjà hors service
Un blocage survenant plus tard nécessite une investigation différente. systemd exécute des fichiers /usr/lib/systemd/system-shutdown/juste avant le redémarrage ou la mise hors tension finale et attend leur achèvement. Si le journal et la console indiquent que les services ordinaires sont déjà arrêtés et que le blocage se produit lors de l'arrêt final, examinez ce répertoire et les hooks installés par le fournisseur. La documentation du service d'arrêt de systemd décrit ce comportement.
Étape 4 : Réparez le composant, puis effectuez un redémarrage normal.
Reprenons l'exemple hypothétique lab-sles01. Supposons que les journaux indiquent que le service backup.serviceignore l'arrêt normal une fois sa sauvegarde terminée. La première option consiste à corriger le service ou sa commande d'arrêt. Si l'arrêt du service est avéré et peut être interrompu après une période déterminée, une configuration systemd spécifique à chaque unité permet de limiter la durée d'attente de systemd.
Créez une substitution au lieu de modifier une unité fournisseur sous/usr/lib/systemd/system :
sudo systemctl edit backup.service
Par exemple:
[Service]
TimeoutStopSec=30s
Rechargez ensuite la configuration de l'unité systemd :
sudo systemctl daemon-reload
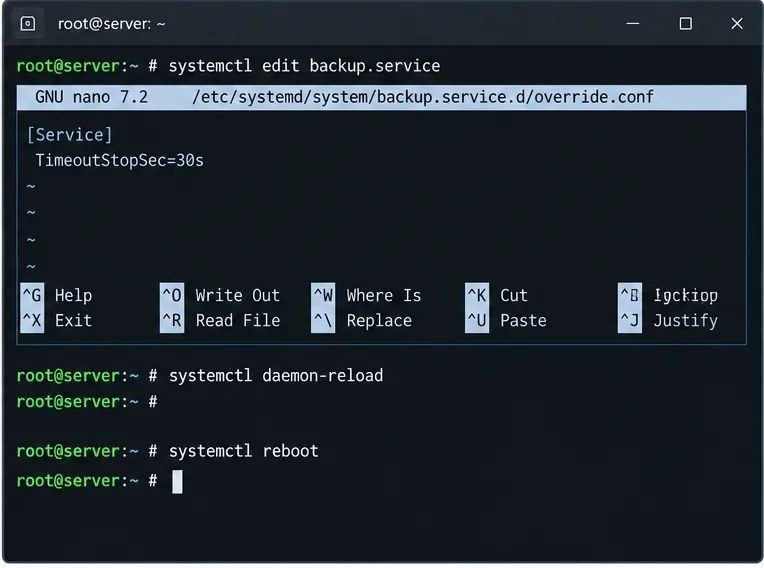
Exemple illustratif : un délai d’expiration par service n’est appliqué qu’après que le service hypothétique a été identifié comme étant le bloquant.
Ne copiez pas aveuglément la valeur de 30 secondes. Le délai d'expiration approprié dépend des opérations que le service doit effectuer en toute sécurité. Le réduire pour une base de données, un démon de stockage, un service en cluster ou un processus de sauvegarde peut interrompre le nettoyage légitime. Un délai d'expiration est une mesure de sécurité, et non un substitut à la correction d'une ExecStop=action défaillante ou d'une application qui ne s'arrête pas correctement.
Lorsque vous êtes satisfait du changement, effectuez un redémarrage normal :
sudo systemctl reboot
Une fois la machine redémarrée, vérifiez à nouveau le démarrage précédent et assurez-vous que l'unité s'est arrêtée correctement plutôt que de simplement disparaître de la console.
Quand faut-il utiliser un redémarrage forcé ?
Un redémarrage forcé est une option de récupération, et non une stratégie de dépannage. La documentation systemd indique qu'un redémarrage forcé --forceignore systemctl rebootl'arrêt normal du service, mais interrompt tout de même les processus et tente de démonter ou de remonter les systèmes de fichiers en lecture seule. Fournir cette option --forcedeux fois est plus dangereux, car cela peut entraîner un redémarrage sans interrompre les processus ni démonter les systèmes de fichiers, avec un risque de perte de données.
Si le serveur est déjà bloqué et qu'il n'existe aucun moyen plus sûr de rétablir le service, un redémarrage forcé peut être justifié par vos procédures opérationnelles :
sudo systemctl reboot --force
Évitez de considérer systemctl reboot --force --forceune réinitialisation matérielle ou logicielle comme une solution de dépannage classique. Ces actions peuvent supprimer les données nécessaires et compromettre les écritures en cours. La documentation officielle de systemctl distingue clairement les comportements de la réinitialisation matérielle simple et de la réinitialisation matérielle double.
Que se passe-t-il si chaque redémarrage se bloque et que vous ne pouvez pas effectuer de dépannage en mode normal ?
Utilisez une console de maintenance et démarrez en mode de secours. La documentation SUSE explique comment ajouter systemd.unit=rescue.targetdes commandes au noyau depuis l'éditeur GRUB. Le mode de secours offre une session root avec accès aux systèmes de fichiers locaux et aux services essentiels, tout en désactivant le réseau. Cela vous permet de désactiver ou de réparer le service ou la configuration de montage défaillante.
Consultez le Guide d'administration de SLES 15 SP7 pour connaître la procédure officielle de dépannage. Sur les systèmes où le problème n'apparaît qu'après la modification d'un paquet, du noyau, d'un pilote ou du stockage, consultez également l'historique de maintenance SUSE correspondant avant d'appliquer des modifications permanentes au délai d'expiration.
Tableau de décision rapide
| Ce que vous voyez | Zone probable à inspecter | Meilleure prochaine action |
|---|
A stop job is running for xyz.service | Chemin d'arrêt du service | Vérification systemctl status, dossier de l'unité et journal de service |
| Messages de démontage répétés ou de système de fichiers distant | Montage, NFS, CIFS, stockage | Vérifier findmnt, monter les unités /etc/fstabet l'accessibilité du serveur |
| La demande de redémarrage est refusée ou retardée avant l'arrêt. | Inhibiteur ou autre tâche systemd | Courir systemd-inhibit --listetsystemctl list-jobs |
| Les services sont arrêtés, mais l'arrêt définitif ne se produit jamais. | Crochet d'arrêt tardif, noyau, pilote, stockage | Consultez le journal de démarrage précédent et/usr/lib/systemd/system-shutdown/ |
| Un démarrage normal rend la réparation impossible | Défaillance persistante de la configuration ou de l'unité | Bottes avecsystemd.unit=rescue.target |
En résumé
Pour un serveur SUSE Linux bloqué lors de l'arrêt de systemd, la solution durable consiste à identifier la tâche en attente de systemd et à corriger cette tâche ou ses dépendances. Enregistrez le message d'arrêt, examinez-le journalctl -b -1, utilisez ` systemctl stop` systemctl list-jobset systemctl status`systemctl stop` pour isoler le processus bloquant, et ne modifiez ensuite qu'un délai d'attente ou une configuration de montage par service. Réservez les redémarrages forcés aux situations de récupération, et non aux opérations courantes.






