クライアントブラウザでのJitsi MeetにおけるCPU使用率の高さを修正する

Jitsi MeetブラウザのCPUスパイクを診断し、ビデオタイル、カメラエフェクト、ブラウザグラフィック、ホスト設定をチェックすることで、クライアントの負荷を軽減します。
Matrix Synapse ホームサーバーは、数日間は正常に動作しているように見えても、突然 PostgreSQL がマシンの利用可能な RAM のほとんどを消費してしまうことがあります。その典型的な症状はよく知られています。スワップ領域が拡大し始め、クライアント同期が遅くなり、フェデレーション ジョブがキューに溜まり、普段は控えめなサーバーでも管理が困難になります。重要な最初のステップは、PostgreSQL にメモリ リークがあると決めつけないことです。メモリ使用量の増加は、共有バッファ キャッシュ、クエリごとの作業メモリ、多数のデータベース バックエンド、メンテナンス ワーカー、古い統計情報やテーブルの頻繁な変更によって発生する非効率なクエリなど、複数の独立した原因から発生する可能性があります。
cp_minSynapseの公式ドキュメントでは、本番環境ではPostgreSQLを推奨しており、やといったデータベース接続プール制御機能を提供していますcp_max。一方、PostgreSQLでは、などの設定はwork_mem1つのクエリ内で複数の操作によって使用され、同時に多くのセッションで使用される可能性があると警告しています。そのため、単独では無害に見える設定でも、負荷の高い時間帯にはコストが高くなることがあります。最も安全な解決策は、まず測定を行い、次に不要な同時実行を減らし、最後に証拠に基づいてメモリとメンテナンスの動作を調整することです。
まずはオペレーティングシステムレベルから始めましょう。Linuxの場合、総メモリ容量、利用可能なメモリ容量、スワップ領域、および最大規模のプロセスを比較します。
free -h
ps aux --sort=-%mem | head -n 15
単一のプロセス行だけでサーバーを判断しないでください。PostgreSQLはバックエンドプロセスで共有メモリとプライベートメモリの両方を使用するため、重要なのはホストが実際に負荷を受けているかどうかです。つまり、利用可能なメモリが不足しているか、スワップ領域が拡大しているか、メモリ不足による強制終了が発生しているか、レイテンシが持続しているかなどを確認する必要があります。静かな時間帯と負荷の高い時間帯の両方で数値を記録してください。この基準値があれば、後々の変更を推測ではなく測定可能なものにすることができます。
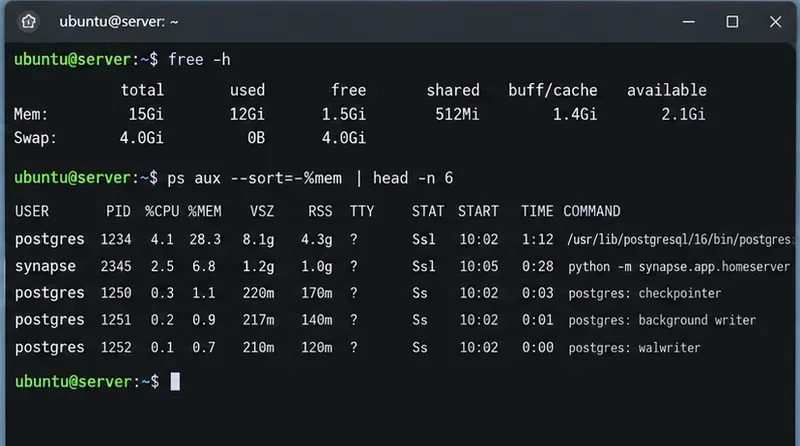
キャプション:最初のメモリチェックでは、構成変更を行う前に、ホストレベルで使用可能なRAMとPostgreSQLおよびSynapseプロセスを比較します。
次に、メモリに影響を与える可能性が最も高いPostgreSQLの設定を調べます。
SHOW shared_buffers;
SHOW work_mem;
SHOW maintenance_work_mem;
SHOW autovacuum_work_mem;
SHOW max_connections;PostgreSQLのリソース消費に関するドキュメントでは、重要な違いについて説明しています。shared_buffersはサーバー全体で共有されるキャッシュです。一方、 はwork_mem個々のソート操作やハッシュ操作が一時ファイルに書き込まれる前の制限です。複雑なクエリにはこのような操作が複数含まれることがあり、多くのセッションが同時に実行できます。PostgreSQLでは現在、デフォルト値として4MBが示されておりwork_mem、実際の使用量はその何倍にもなる可能性があると記載されています。
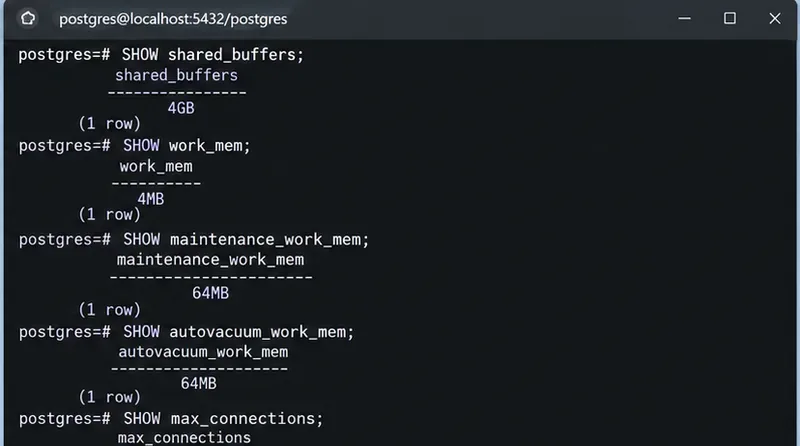
キャプション:PostgreSQLのメモリ関連設定を変更する前に、必ずその設定内容を確認してください。危険な値は、単一の数値ではなく、設定値と同時実行数の組み合わせであることが多いです。
大規模な接続プールは、work_mem接続ごとに自動的にメモリを消費するわけではありませんが、PostgreSQLの各バックエンドは独自のプロセスとプライベートメモリを持ち、同時クエリが増えると、操作ごとのメモリ割り当ての機会が増えます。実際に開いている接続数とその状態を確認してください。
SELECT state,
       usename,
       application_name,
       count(*) AS connections
FROM pg_stat_activity
GROUP BY state, usename, application_name
ORDER BY connections DESC;
次に、長時間実行されているアクティブなクエリを検査します。
SELECT pid,
       usename,
       state,
       now() - query_start AS running_for,
       wait_event_type,
       wait_event,
       left(query, 180) AS query
FROM pg_stat_activity
WHERE state <> 'idle'
ORDER BY query_start;公式ドキュメントには、pg_stat_activityセッションとアクティビティのフィールドについて説明されています。アイドル状態のセッション数が多いことと、負荷の高いアクティブなクエリの数が少ないことは異なるため、対処法も異なります。問題が接続数にある場合は、プールサイズを調整してください。問題がメモリを大量に消費するクエリが少数あることにある場合は、プールサイズを小さくするだけでは症状が隠れるだけかもしれません。
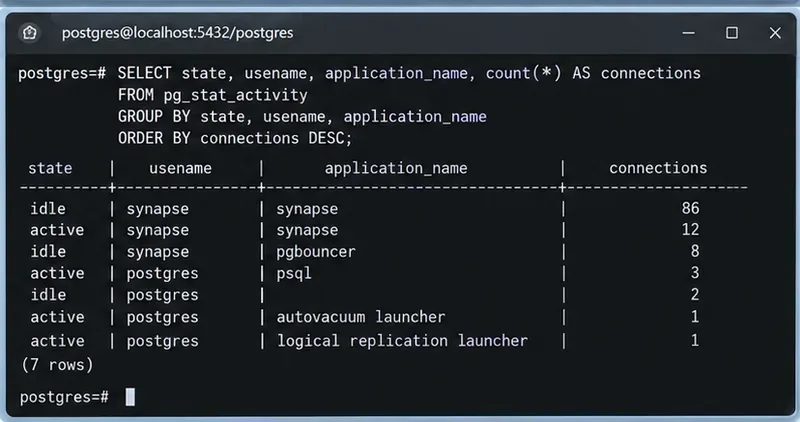
キャプション:グループ化することpg_stat_activityで、多数のアイドル状態のバックエンドと、少数のアクティブなデータベースセッションを容易に区別できます。
Synapse は、ほとんどのデータベース引数を PostgreSQL に渡しますが、cp_Twisted 接続プール用に で始まるオプションを使用します。現在のSynapse PostgreSQL ガイドではcp_min: 5、とを使用した例を示していますcp_max: 10。これらはあくまで例の値であり、普遍的なターゲットではありません。
databaseブロックを確認してくださいhomeserver.yaml:
database:
  name: psycopg2
  args:
    user: synapse_user
    password: "your-secret"
    dbname: synapse
    host: 127.0.0.1
    cp_min: 5
cp_max: 10以前に接続プールを積極的に増やしcp_max、pg_stat_activityアイドル状態のSynapse接続が多数発生している場合は、接続プールを徐々に減らし、リクエストのレイテンシを監視してください。ワーカーベースのSynapseデプロイメントでは、データベースへの要求は複数のSynapseプロセスから発生するため、個々のワーカーではなく、接続の合計数を評価する必要があります。Synapse構成マニュアルにcp_は、オプションで接続プールを設定できることが記載されています。
設定を編集した後は、デプロイ方法に応じて影響を受ける Synapse プロセスを再起動し、再度接続数クエリを実行してください。数メガバイトを節約するためだけに、リクエストがキューイングし始めるまでプールサイズを縮小しないでください。プールサイズが小さすぎると、データベースの同時実行性がアプリケーションの遅延につながる可能性があります。
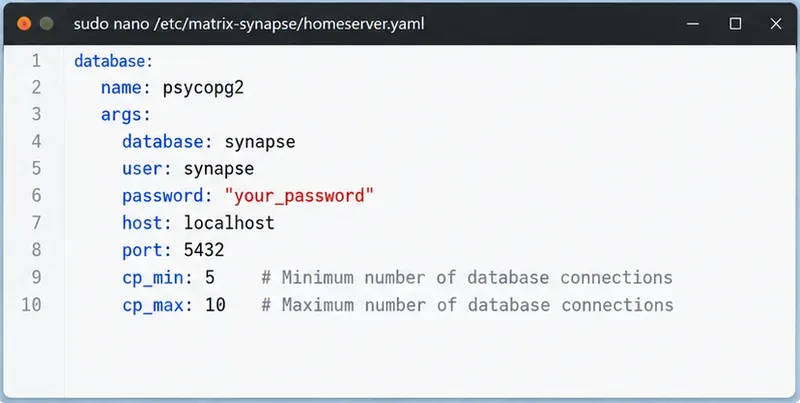
キャプション: Synapse はPostgreSQL データベース構成でcp_minと を公開し、管理者が不要なバックエンドの同時実行数を制限できるようにします。cp_max
接続数が妥当な範囲になったら、データベースで実際に使用可能な RAM を考慮して PostgreSQL のメモリ設定を確認してください。PostgreSQL によると、少なくとも 1 GB の RAM を搭載した専用データベースサーバーでは、システムメモリの約 25% が妥当な開始点となりますshared_buffers。このガイダンスは、専用データベースサーバーを前提としています。Synapse、リバースプロキシ、Redis、監視、PostgreSQL が 1 つの小さな VM を共有している場合、PostgreSQL はマシン全体を占有しないため、それに応じて予算を配分してください。
管理者にとって最も意外な設定は ですwork_mem。work_memを で乗算しmax_connectionsてハード予約として扱うことは避けてください。PostgreSQL はそのように事前割り当てしません。代わりに、同時クエリ操作の観点から考えてください。1 つのクエリで複数のソートノードまたはハッシュノードを使用することができ、ハッシュ操作では の倍数を使用する場合がありますwork_mem。1 つのレポートが遅いという理由で をグローバルに非常に大きな値に設定するとwork_mem、フェデレーションのバーストや同期が集中する期間に、予想よりもはるかに大きなメモリピークが発生する可能性があります。
賢明なパターンとしては、グローバル値を控えめに設定し、既知のクエリがより多くのメモリによってメリットを得られる場合にのみ、特定の管理セッションでその値を上げることです。値を変更する前に、既存の設定を保持し、どのパラメータでPostgreSQLの再起動が必要になるかをメモしておきましょう。shared_buffersたとえば、はサーバー起動設定です。変更は、変更前後でメモリ、レイテンシ、一時ファイルの動作を比較できるようにスケジュール設定する必要があります。
また、maintenance_work_memとを確認してくださいautovacuum_work_mem。PostgreSQLでは、自動バキュームワーカーがメンテナンスメモリを同時に割り当てることができると注意されています。autovacuum_work_memが継承された動作のままになっている場合、異常に大きなによって、maintenance_work_mem複数の自動バキュームワーカーが同時に実行されるとコストが高くなる可能性があります。RAMを節約するために自動バキュームを無効にしないでください。通常、これは短期的なメモリ不足という症状と引き換えに、テーブルの肥大化、古い統計情報、およびパフォーマンスの低下を引き起こします。
Synapseは大量のイベントデータと状態データを書き込み、更新します。PostgreSQLでは、不要になったタプルを回収して再利用し、プランナーの統計情報を最新の状態に保つために、定期的なバキューム処理が必要です。PostgreSQLのルーチンバキューム処理ガイドでは、ほとんどのインストール環境で自動バキューム(autovacuum)の使用を推奨しています。
推定されるデッドタプルが多いテーブルや、メンテナンスのタイムスタンプが古いテーブルを探してください。
SELECT relname,
       n_live_tup,
       n_dead_tup,
       last_autovacuum,
       last_autoanalyze
FROM pg_stat_user_tables
ORDER BY n_dead_tup DESC
LIMIT 20;特定のテーブルに明らかに注意が必要な場合、VACUUM (ANALYZE)通常、最初に検討すべき手動ツールは次のようになります。
VACUUM (ANALYZE) your_table_name;いきなり VACUUM に飛びつくのは避けてくださいVACUUM FULL。公式の VACUUM リファレンスでは、通常のVACUUMVACUUM は通常の読み書きと並行して実行できますが、VACUUM FULLVACUUM はテーブルを書き換えてACCESS EXCLUSIVEロックを取得します。後者は、計画された中断によってディスク領域の解放が見合う場合にのみ使用してください。
問題の原因となったワークロードと同じ種類のワークロードで結果を検証してください。「PostgresのRAM使用量がすぐに減った」というだけでは、問題解決の成功とは言えません。データベースキャッシュはメモリを使用するように設計されています。そうではなく、利用可能なメモリが安定していること、予期せぬスワップの増加がほとんどまたは全くないこと、メモリ不足イベントが発生しないこと、想定される同時接続数と一致する接続数、そして許容範囲内のSynapse応答時間を確認してください。
free -hとプロセスリストは、ベースラインで使用したのと同じトラフィックレベルで行ってください。pg_stat_activitySynapseプールを変更した場合は、接続クエリを再度実行して、アイドル状態のバックエンド数が減少したことを確認してください。cp_max、データベースの待機時間が著しく増加した場合は変更を元に戻してください。pg_stat_user_tables定期的に点検して、自動掃除機が実際に利用頻度の高いテーブルを回っていることを確認してください。work_mem、さらに下げる前に、大規模なソート処理で一時ファイルに過剰にデータが書き込まれるかどうかを監視してください。これらのチェック後もPostgreSQLがホストのスワップが激しくなるまで増大し続ける場合は、グローバルメモリ制限を繰り返し縮小するのではなく、急増時のアクティブなクエリリストをキャプチャしてワークロードを調査してください。サポートされているPostgreSQLバージョンでは、pg_backend_memory_contexts現在のバックエンドのメモリコンテキストを検査できます。PostgreSQLのシステムビューのドキュメントには、ビューとその権限について記載されています。これは、メモリ使用量の多いSynapseデプロイメントはすべて同じ原因によるものだと想定するよりも、データベースの調査を絞り込む上でより有用です。
PostgreSQL 上で動作する Matrix Synapse の場合、データベースのメモリ使用量が多いという問題は、複数のレイヤーで安全に解決できます。具体的には、ホストが実際にメモリ不足の状態にあることを確認し、データベースセッション数をカウントし、Synapse のメモリプールのサイズを適正化し、PostgreSQL の操作ごとのメモリ使用量を控えめに抑え、自動バキュームが正常に動作していることを確認します。目標は、PostgreSQL のフットプリントを最小化することではありません。目標は、通常のデータベースのキャッシュや並行処理を、回避可能なスワップ、メモリ不足イベント、または Matrix クライアントの速度低下に陥らせることなく、メモリ使用量を予測可能にすることです。
Jitsi MeetブラウザのCPUスパイクを診断し、ビデオタイル、カメラエフェクト、ブラウザグラフィック、ホスト設定をチェックすることで、クライアントの負荷を軽減します。
Jitsi Videobridgeに内蔵されたPrometheusエンドポイントを使用して、Jitsi Videobridgeの状態、会議の負荷、トラフィックを追跡し、Grafanaでデータを探索およびグラフ化できます。
Jitsi Meet Docker 用のカスタムドメインを、DNS、PUBLIC_URL、HTTPS、Let's Encrypt、ファイアウォールポート、NAT 設定、エンドツーエンド検証とともに構成します。
SSL更新後に発生するZimbra管理コンソールの404エラーを修正するには、正しいURLとポート、プロキシルーティング、サービスステータス、デプロイ済みの証明書、およびログを確認してください。
アクティブなPHP SAPI、サイズ制限、コメント、および再検証設定を確認することで、NextcloudのPHP OPcache構成警告を診断および修正する方法を学びましょう。
MySQLまたはMariaDBのアップグレード後にKopanoデータベースの移行が失敗した場合は、バックアップ、サーバーバージョン、SQLモード、文字セット、スキーマ状態、およびログを確認してトラブルシューティングを行います。
セキュアなトランスポート、ユーザーおよびグループフィルタ、ログイン属性、そしてテスト済みの展開機能を使用して、NextcloudをLDAPまたはActive Directoryに接続します。
UnifiedPush、Androidの権限設定、バッテリー設定、および信頼性の高い検証テストを設定することで、Googleサービスを削除した端末におけるElement Android通知の問題を修正します。
Nextcloudのデータベースインデックス不足警告を、公式のoccコマンドでクリアします。まずバックアップを作成し、変更内容をプレビューしてから修復を実行し、結果を確認してください。
Element Web 用の Keycloak SSO を設定するには、OIDC を Synapse に接続し、正確なコールバック URL を設定し、ユーザー クレームをマッピングし、ログアウトをテストします。







