SLES 15とRHEL 9:エンタープライズサーバーのパフォーマンス比較

SLES 15とRHEL 9のパフォーマンスに関する事実、カーネルストリーム、TuneDプロファイル、ワークロード変数、および両システムを公平にベンチマークする方法について比較します。
SUSE Linuxサーバーが再起動中にsystemdのシャットダウンメッセージでハングアップした場合、最初に考えるべき最も有用な仮説は、再起動コマンド自体に問題があるということではありません。ほとんどの場合、systemdはユニット、マウント、プロセス、またはシャットダウンフックの完了を待っています。したがって、最も安全な解決策は、シャットダウンタイムアウトを全体的に短縮するのではなく、実行中のジョブを正確に特定し、停止しない理由を調査して、そのコンポーネントを修正することです。
このガイドでは、架空の例を全体を通して使用します。 という名前のサーバーがlab-sles01SUSE Linux Enterprise Server を実行し、再起動中に のようなメッセージが表示されて一時停止しますA stop job is running for backup.service。この例は診断方法の説明にすぎず、実際のテストの報告でも、特定の SUSE リリースに という名前のサービスに欠陥があるという主張でもありませんbackup.service。
| ステップ | 何をするか | あなたが学ぼうとしていること |
|---|---|---|
| 1 | 正確なシャットダウンメッセージを記録してください。 | どのユニットまたはステージが進行を妨げているか |
| 2 | 前回のブートジャーナルを確認する | 停止がタイムアウトしたか、アンマウントが失敗したか、シャットダウンがさらに後の段階に達したかに関わらず |
| 3 | ブロッキングユニットと実行中のジョブを検査します。 | サービス、マウント、インヒビター、または依存関係のどれが原因か |
| 4 | 根本原因を修正して再テストしてください | 通常のsystemctl reboot処理が遅延なく完了するかどうか |
計画的な再起動中は、ローカルコンソール、仮想マシンコンソール、BMC/IPMIコンソール、またはハイパーバイザーコンソールを監視してください。「systemdがフリーズしました」といった一般的な説明よりも、ユニット名が表示された行の方がはるかに役立ちます。仮に、他のユニットが既にシャットダウンしているにもかかわらず、lab-sles01コンソールにがまだ停止中と表示されたとします。backup.service
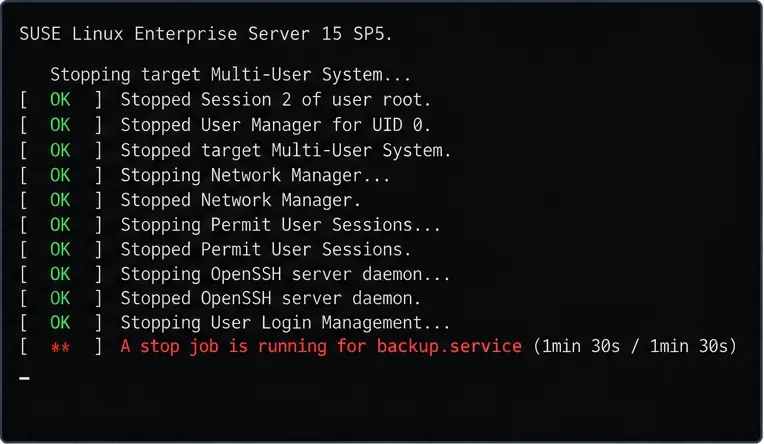
具体例:シャットダウンコンソールは、backup.servicesystemdがまだ待機しているユニットとして識別されます。
コンソールに.mountユニット、ネットワークファイルシステム、デバイス、または別のサービス名が表示された場合は、一般的なサービスタイムアウトを適用するのではなく、その名前に従ってください。コンソールの下部に表示されるユニットは手がかりであり、必ずしも根本原因を示すものではありません。ユニット自体が子プロセス、ストレージ、ネットワークI/O、またはその他の依存関係を待機している可能性があります。
SUSEの最新のsystemdガイダンスでは、長時間の再起動や電源オフは、終了しないサービスが原因である可能性があり、systemdジョブを確認することを推奨しています。詳しくは、SUSE Linux Enterprise Server 16.0: systemdの基本入門をご覧ください。
マシンが再び起動したら、先ほど発生したシャットダウンを調べます。SUSE はジャーナルにブートオフセットを記録します。`boot`0は現在のブート、`boot`-1は前回のブート、といった具合です。まずは以下から始めてください。
sudo journalctl --list-boots
sudo journalctl -b -1
大規模なジャーナルでは、逆順に並べ替えることで最新のメッセージをより早く見つけることができる。
sudo journalctl -b -1 -r

具体例:前回の起動時のジャーナルには、仮想的なバックアップサービスがSIGTERMシグナルを受信し、その後タイムアウトした様子が示されています。
Stopping、、、、、などのフレーズ、または疑わしいサービス自体からのメッセージを探してください。ユニット名がわかれば、表示範囲を絞り込むことができますstop job。timed outFailed with resultUnmountingDependency failed
sudo journalctl -b -1 -u backup.service
SUSEは、SLES 15 SP7のジャーナルドキュメントjournalctl -b -1で、以前の起動時の分析方法について説明しています。以前の起動履歴が含まれていない場合は、欠落した履歴から結論を導き出さないでください。journaldストレージの設定を確認し、次回の再現時にはコンソールまたはリモートログを使用してください。journalctl --list-boots
メンテナンスウィンドウ中に問題が再現できる場合は、別の管理コンソールを用意しておいてください。接続が切断される前に、以下のコマンドを実行してください。
sudo systemctl list-jobs
sudo systemctl status backup.service
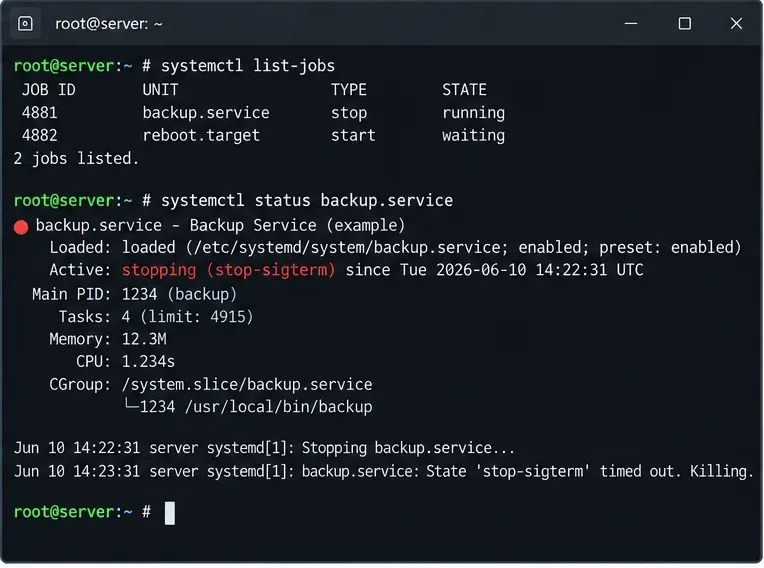
具体例:backup.service再起動対象が停止ジョブの後ろで待機している間、停止ジョブが実行されている。
上流のsystemdデバッグガイダンスでは、として表示されるジョブがrunning完了してから、として表示される依存ジョブがwaiting続行できると説明されています。SUSEは、systemctl list-jobsシャットダウンまたは再起動に時間がかかりすぎる場合にも、このコマンドの使用を推奨しています。そのため、このコマンドは、サーバーが完全にフリーズしておらず、PID 1がまだ応答している場合に特に役立ちます。
ユニット定義とそのシャットダウン動作を確認してください。
sudo systemctl cat backup.service
sudo systemctl status backup.service
sudo journalctl -u backup.service -b
サービスにExecStop=アクションがあるか、プロセスがSIGTERMシグナルを処理しているか、ストレージやネットワークリソースを待機しているかを確認してください。データベース、バックアップエージェント、ミドルウェアサービスは、データのフラッシュに正当な時間が必要な場合があるため、それらを早期に強制終了しても必ずしも解決にはなりません。
アンマウント操作の失敗箇所を探し、マウント元を特定します。
findmnt
systemctl list-units --type=mount
sudo journalctl -b -1 | grep -Ei 'unmount|umount|mount|nfs|cifs'
NFSまたはCIFSの場合は、サーバーへの到達可能性、古いセッション、およびマウントオプションがサーバーのシャットダウン要件に適合しているかどうかを調査してください。ブロックされたユニットがから生成された場合は/etc/fstab、無関係なユニットにサービス固有のタイムアウトを適用するのではなく、マウント構成を修正してください。
シャットダウンを開始する前に、アクティブなsystemd阻害要因を一覧表示できます。
systemd-inhibit --list
インヒビターロックは、アプリケーションが中断されるべきではない処理を実行している間、シャットダウン要求をブロックまたは遅延させることができます。これは、システムが最終的なシャットダウンシーケンスに入る前に再起動要求自体が遅延する場合に最も効果的です。詳細については、systemd-inhibit のマニュアルを参照してください。
後期の段階でハングアップする場合は、別の調査が必要です。systemd は、/usr/lib/systemd/system-shutdown/最終的な再起動または電源オフの直前に実行可能ファイルを実行し、それらの完了を待ちます。ジャーナルとコンソールに通常のサービスが既に停止していることが示され、最終シャットダウン段階でハングアップが発生する場合は、そのディレクトリとベンダーがインストールしたフックを確認してください。この動作については、 systemd のシャットダウンサービスのドキュメントに記載されています。
仮説に戻りlab-sles01ましょう。ログに、backup.serviceバックアップ処理が完了した後も通常の終了処理が無視されていることが示されているとします。最初の選択肢は、サービスまたはその停止コマンドを修正することです。サービスが一定期間後に安全に終了できることがわかっている場合は、systemd の単位ごとのオーバーライドによって、systemd が待機する時間を制限できます。
ベンダーユニットを編集する代わりに、オーバーライドを作成します/usr/lib/systemd/system。
sudo systemctl edit backup.service
例えば:
[Service]
TimeoutStopSec=30s
次に、systemdのユニット設定を再読み込みします。
sudo systemctl daemon-reload
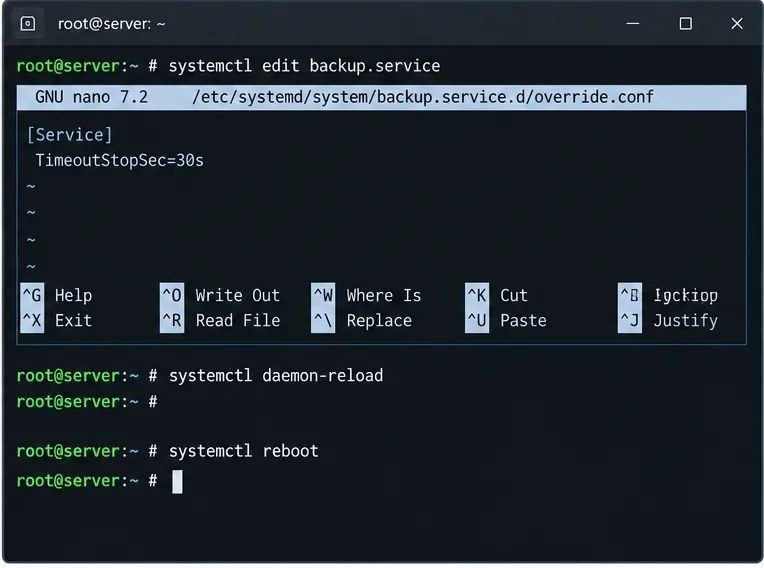
具体例:サービスごとのタイムアウトは、想定されるサービスがブロッカーとして特定された後にのみ適用されます。
30秒という値を安易にコピーしないでください。適切なタイムアウト値は、実際のサービスが安全に完了しなければならない内容によって異なります。データベース、ストレージデーモン、クラスタサービス、またはバックアッププロセスに対してタイムアウト値を短縮すると、正当なクリーンアップ処理が中断される可能性があります。タイムアウトはあくまで安全策であり、不具合のあるExecStop=処理や正しく終了しないアプリケーションの修正に代わるものではありません。
変更内容に満足したら、通常の再起動をテストしてください。
sudo systemctl reboot
マシンが復帰したら、前回の起動を再度確認し、コンソールから単に消えたのではなく、正常に停止したことを確認してください。
強制再起動は復旧手段であり、トラブルシューティング戦略ではありません。systemd の公式ドキュメントによると、強制再起動--forceではsystemctl reboot通常のサービスシャットダウンはスキップされますが、プロセスは強制終了され、ファイルシステムは読み取り専用でアンマウントまたは再マウントされます。強制再起動を--force2 回行うと、プロセスやファイルシステムをアンマウントせずに再起動してしまう可能性があり、データ損失のリスクがあるため、より危険です。
サーバーが既に停止しており、サービスを復旧させるためのより安全な方法がない場合、運用手順によっては、強制再起動を1回行うことが正当化される場合があります。
sudo systemctl reboot --force
仮想電源サイクルや物理リセットを通常の修復手段として扱わないでくださいsystemctl reboot --force --force。これらの操作は必要な証拠を消去したり、進行中の書き込みを危険にさらす可能性があります。systemctlの公式ドキュメントでは、シングルフォースとダブルフォースの動作が明確に区別されています。
メンテナンスコンソールを使用して、レスキューモードで起動してください。SUSEのドキュメントには、systemd.unit=rescue.targetGRUBエディタからカーネルコマンドラインにコマンドを追加する方法が記載されています。レスキューモードでは、ローカルファイルシステムとコアサービスへのルートセッションが提供され、ネットワークは非アクティブ状態のままになります。これにより、問題のあるサービスやマウント構成を無効化または修復することができます。
公式のレスキューモード手順については、 SLES 15 SP7 管理ガイドを参照してください。特定のパッケージ、カーネル、ドライバ、またはストレージの変更後にのみ問題が発生するシステムでは、タイムアウトを永続的に変更する前に、関連する SUSE メンテナンス履歴も確認してください。
| あなたが見るもの | 調査対象になりそうなエリア | 次に最適な行動 |
|---|---|---|
A stop job is running for xyz.service | サービスシャットダウンパス | チェックsystemctl status、ユニットファイル、およびサービスジャーナル |
| アンマウントまたはリモートファイルシステムのメッセージが繰り返し表示されます | マウント、NFS、CIFS、ストレージ | findmntユニットのマウント/etc/fstabとサーバーへの接続性を確認します。 |
| シャットダウン前に再起動要求が拒否または遅延されました | インヒビターまたは別のsystemdジョブ | 走っsystemd-inhibit --listてsystemctl list-jobs |
| サービスは停止されるが、最終的なシャットダウンは完了しない。 | 遅延シャットダウンフック、カーネル、ドライバ、ストレージ | 前回のブートジャーナルを確認し、/usr/lib/systemd/system-shutdown/ |
| 通常起動では修理は不可能 | 永続的な構成またはユニットの障害 | ブートsystemd.unit=rescue.target |
SUSE Linuxサーバーがsystemdのシャットダウン時にハングアップした場合、恒久的な解決策は、systemdが待機しているジョブを特定し、そのユニットまたはその依存関係を修正することです。シャットダウンメッセージを記録し、検査を行いjournalctl -b -1、systemctl list-jobsおよびを使用してsystemctl statusブロッカーを分離してから、サービスごとのタイムアウトまたはマウント構成を変更します。強制再起動は、日常的な操作ではなく、復旧状況のために残しておいてください。
SLES 15とRHEL 9のパフォーマンスに関する事実、カーネルストリーム、TuneDプロファイル、ワークロード変数、および両システムを公平にベンチマークする方法について比較します。
systemdシャットダウン中にハングアップするSUSE Linuxサーバーを診断して修復する方法を学びましょう。そのためには、停止しているジョブを特定し、前回の起動履歴を確認し、ブロックしているサービスやマウントを修正する必要があります。
Pardus XFCEを、下部タスクバー、アプリケーションメニュー、お気に入りランチャー、ウィンドウを開くボタン、システムトレイ、時計などを使って、使い慣れた環境のように使えるように設定しましょう。変更すべき箇所とレイアウトのテスト方法を学びます。
Configure unattended-upgrades on a headless Debian server, verify systemd timers, test safely, control reboots, and monitor automatic security updates.
SUSE Linux Enterprise Server 上の Cockpit のトラブルシューティングを行うには、HTTPS URL、systemd ソケット、インストールされているパッケージ、firewalld ゾーン、証明書、およびログを確認してください。
SLES 15 SP5からSP6への移行中にサービスを継続的に利用できるようにするための、テスト済みのSLE HAローリングアップグレード、ノードごとのチェック、および明確な単一サーバーダウンタイムに関する注意点について学びましょう。
Ubuntu Server 24.04 上で Pi-hole を設定し、dnscrypt-proxy を使用して DNS-over-HTTPS を利用するようにしてから、ローカルのアップストリームを確認し、一般的な DNS の競合を回避します。
SSH X11転送経由のYaST GUIの不具合をトラブルシューティングします。DISPLAYをテストし、既知のQt XIOエラーを修正し、SSH設定を確認し、必要に応じてncursesに切り替えます。
SLES 15 上に SUSE RMT をセットアップし、SCC メタデータを同期し、選択したリポジトリをミラーリングし、HTTPS 経由でクライアントを登録し、SMT からの移行における制限事項を理解する。
Pardus Linux 23でサウンドカードが認識されない場合のトラブルシューティングを行います。ALSA検出、カーネルモジュール、オーディオサービス、出力プロファイル、ファームウェア、およびアップデートを安全に確認します。
