Najlepsze praktyki monitorowania sieci: co śledzić i jakich narzędzi używać
Skuteczne monitorowanie sieci zaczyna się od zweryfikowanego inwentarza, metryk ukierunkowanych na usługi i alertów z możliwością podjęcia działań. Zmapuj krytyczne urządzenia i usługi, ustal normalną wydajność, a następnie wybierz platformę, która obsługuje Twoją infrastrukturę i może być utrzymywana przez Twój zespół. Pomaga to w wykrywaniu rozwijających się problemów, nie zamieniając każdej drobnej zmiany w stronę problemu.
Co powinno Ci powiedzieć monitorowanie sieci
Monitorowanie sieci śledzi dostępność urządzeń i usług oraz ich wydajność w czasie. Zazwyczaj obejmuje stan urządzeń i interfejsów, ruch, zasoby serwerów i kontrole usług. Rejestrowanie bezpieczeństwa ma inne zadanie: system NMS analizuje dostępność i wydajność, podczas gdy scentralizowane logi lub system SIEM pomagają badać zdarzenia, takie jak podejrzane logowania i zmiany konfiguracji. Wiele zespołów korzysta z obu metod. NIST definiuje ciągłe monitorowanie jako ciągłą świadomość w zakresie podejmowania decyzji dotyczących ryzyka; przegląd zasięgu sieci w miarę zmian w środowisku.
Najlepsze praktyki monitorowania sieci
1. Stwórz inwentarz przed ustawieniem alertów
Wypisz routery, przełączniki, zapory sieciowe, urządzenia bezprzewodowe, serwery krytyczne, łącza chmurowe i usługi dla klientów. Dla każdego z nich zapisz lokalizację, właściciela, priorytet firmy, adres zarządzania i zależności. Użyj funkcji wyszukiwania, aby zasilić inwentarz, a następnie zweryfikuj go i dodaj urządzenia, których nie można znaleźć automatycznie. Grupuj według lokalizacji lub usługi. Aktualizuj listę po zmianach, aby zapewnić pełne pokrycie.
Przykładowy widok topologii łączy stan urządzenia z zależnościami nadrzędnymi i podrzędnymi.
2. Monitoruj sygnały wyjaśniające wpływ użytkownika
Zacznij od kompaktowego zestawu pomiarów powiązanego z kluczowymi usługami:
Dostępność: stan urządzenia i interfejsu, a także sprawdzenie podstawowych usług, takich jak DNS, aplikacje internetowe, poczta e-mail lub dostęp do sieci VPN.
Jakość ścieżki: opóźnienie, utrata pakietów i drgania w sytuacjach, w których zależy od tego transmisja głosu lub obrazu w czasie rzeczywistym.
Ruch i przepustowość: wykorzystanie interfejsu, przepustowość, błędy i odrzucenia. Zachowaj historię, aby odróżnić krótkotrwały skok od powtarzającego się problemu z przepustowością.
Stan urządzenia: stan procesora, pamięci, temperatury, zasilania lub wentylatora, jeśli urządzenie wyświetla te odczyty.
Systemy pomocnicze: pamięć masowa serwerów i stan usług, gdy awaria aplikacji może być spowodowana czymś spoza warstwy sieciowej.
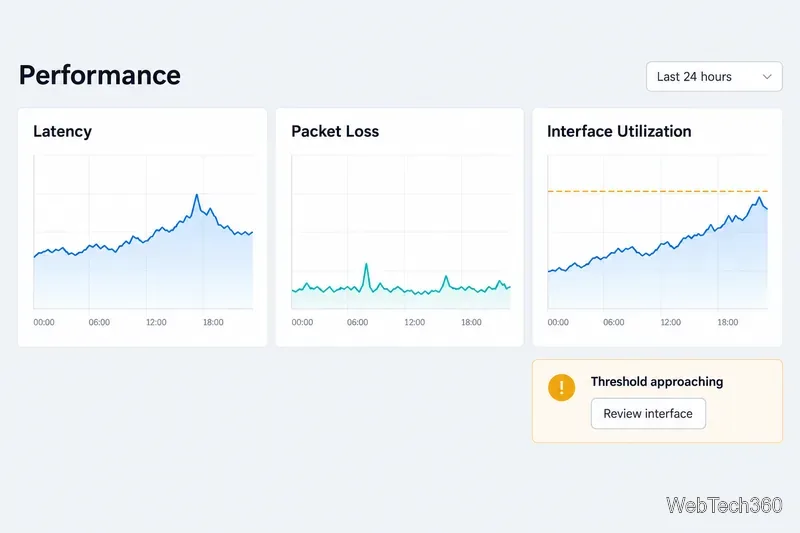
Zamiast stosować jeden uniwersalny próg, ustal punkty odniesienia dla poszczególnych placówek i usług. Porównaj obecne zachowanie z typowymi okresami wzmożonego ruchu i obserwuj, czy nie występuje utrzymująca się presja lub nagłe zmiany.
Przykładowy panel wydajności pomaga oddzielić normalne odchylenia od stałego obciążenia łącza.
3. Uczyń alerty możliwymi do wykonania i zmniejsz liczbę duplikatów
Alerty dotyczące warunków wymagających podjęcia działań: awarii, nieudanych kontroli usług lub długotrwałych przekroczeń progów. Użyj reguły opóźnienia lub odzyskiwania, aby filtrować przejściowe zakłócenia. Uwzględnij urządzenie lub interfejs, usługę lub lokalizację, której dotyczy problem, czas pierwszego wykrycia, wartości obserwowane i oczekiwane oraz podręcznik. Kieruj alerty do właściciela i definiuj eskalację.
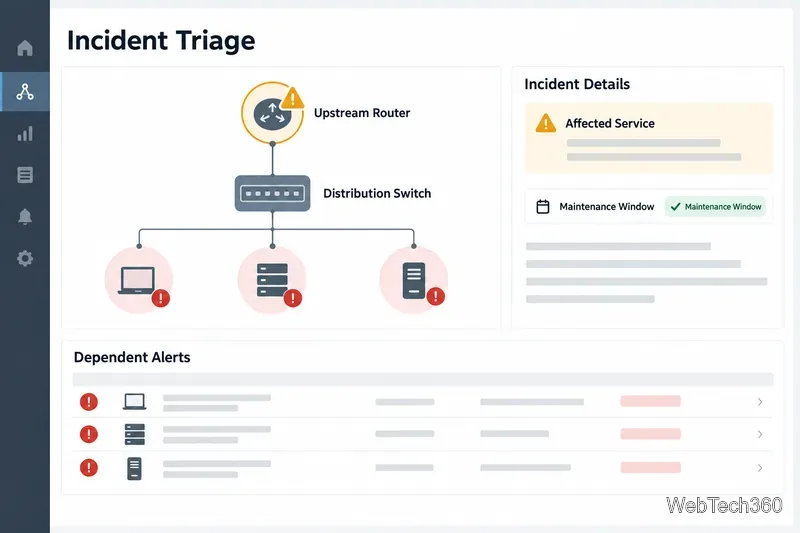
Grupuj alerty downstream, gdy awaria upstream je wyjaśnia; planuj okna konserwacyjne na zaplanowane prace. Pomaga to służbom ratunkowym szybciej znaleźć prawdopodobne przyczyny. Przejrzyj reguły tłumienia po zmianach topologii, aby niezależne awarie były widoczne.
Przykładowy widok incydentu pokazuje, w jaki sposób alerty zależne mogą wskazywać osobom reagującym pierwsze uszkodzone łącze.
4. Chroń system monitorowania
Monitorowanie danych uwierzytelniających i logów może ujawnić wrażliwą infrastrukturę. Ogranicz ruch administracyjny, używaj kont tylko do odczytu, gdy to możliwe, udzielaj dostępu opartego na rolach i zabezpiecz serwer monitorujący oraz kopie zapasowe. Preferuj protokół SNMPv3, jeśli jest obsługiwany, z kompatybilnymi ustawieniami uwierzytelniania i prywatności; model bezpieczeństwa SNMPv3 oparty na użytkownikach definiuje te usługi bezpieczeństwa. Postępuj zgodnie ze wskazówkami CISA dotyczącymi ochrony logów i nigdy nie udostępniaj interfejsów administracyjnych bezpośrednio w publicznym Internecie.
5. Testowanie zasięgu, alertów i odzyskiwania
Sprawdź, czy sondy docierają do urządzeń z odpowiednich lokalizacji, czy działają poświadczenia, a historia jest zachowywana na potrzeby rozwiązywania problemów i planowania pojemności. Przetestuj alerty z ich odbiorcami, właścicielami dokumentów i harmonogramami konserwacji. Przejrzyj nieaktualne urządzenia, luki i reguły powodujące zakłócenia po zmianach w sieci. Przygotuj przetestowany plan odzyskiwania dla platformy monitorującej.
Trzy narzędzia do monitorowania sieci, które można ocenić
Te produkty zaspokajają typowe potrzeby. Dopasowanie zależy od środowiska, modelu wdrożenia, licencji i dostępnych umiejętności. Sprawdź plany i wsparcie techniczne urządzeń u każdego dostawcy.
Narzędzie
Gdzie może pasować
Sprawdź podczas oceny
Monitor wydajności sieci SolarWinds
Środowiska wielu dostawców wymagające metryk urządzeń, map, alertów, raportowania lub rozwiązywania problemów ze ścieżkami. Dostawca podaje dostępność, opóźnienia, utratę pakietów, wykorzystanie i stan urządzenia.
Sprawdź obsługę urządzeń i protokołów, wdrożenie, retencję i potrzebne moduły. Zobacz SolarWinds NPM .
Monitor sieciowy Paessler PRTG
Zespoły monitorujące urządzenia, ruch, serwery i usługi za pomocą map, pulpitów nawigacyjnych i powiadomień. PRTG reprezentuje monitorowane wartości jako czujniki.
Oszacuj zapotrzebowanie na czujniki i sondy w ramach swojego planu zasięgu. Zobacz Paessler PRTG .
ManageEngine OpManager
Organizacje poszukujące rozwiązań do wykrywania i monitorowania wydajności urządzeń sieciowych i serwerów. Dokumentacja opisuje obsługę SNMP, CLI i WMI.
Sprawdź dostęp do protokołu, szablony, kontrolę ról, dodatki i zarządzanie zdalne. Zobacz OpManager .
Wybierz z małym pilotem
Przeprowadź pilotaż reprezentatywnej lokalizacji, usługi krytycznej i zestawu urządzeń. Przetestuj wykrywanie, dokładność metryk, alerty, obsługę konserwacji, raporty, uprawnienia i odzyskiwanie. Zapytaj użytkowników pulpitu, jakiego kontekstu brakuje. Krótki pilotaż pokaże, czy platforma pasuje do Twojej sieci lepiej niż lista kontrolna funkcji.