Strona główna
» LINUX
»
How to Set Up High Availability Clustering (HAE) on SUSE Linux 15
How to Set Up High Availability Clustering (HAE) on SUSE Linux 15
This beginner walkthrough builds a basic two-node, active/passive cluster with SUSE Linux Enterprise High Availability (SLE HA) 15. It uses the supported CRM Shell bootstrap scripts: initialize the first node with crm cluster init, add the second with crm cluster join, check membership, and test a planned failover of the management virtual IP. The examples follow SUSE’s SLE HA 15 SP7 documentation, published September 24, 2026; prompts can vary by service pack, hardware, and platform.
“HAE” is often used informally for the High Availability Extension. SUSE’s current product documentation calls it SUSE Linux Enterprise High Availability, or SLE HA. This procedure provides a working cluster foundation and Hawk2 management access. It does not automatically make an application, database, or its data highly available; those need their own Pacemaker resources, storage design, and workload-specific testing.
The terminal and Hawk2 screen illustrations below show representative interface views, not captures from a live system. Names and addresses are examples. Replace them with values from your network.
What will this cluster do?
A cluster is a group of servers, called nodes, that coordinate to keep selected services running. Corosync handles node membership and cluster messaging. Pacemaker, the cluster resource manager, decides where managed resources should run and responds to failures. A resource is a service or address Pacemaker can start, stop, monitor, and move.
In this walkthrough, node alice and node bob form a two-node cluster. A floating management IP gives administrators a stable address for Hawk2, SUSE’s web interface. If one node is placed in standby, Pacemaker can move that IP to the other node. For a production two-node cluster, SUSE recommends adding QDevice/QNetd for quorum decisions and requires node fencing.
What should you prepare before installing?
Two supported SUSE Linux Enterprise Server 15 systems running the same service pack and processor architecture, with root or an appropriately privileged sudo account.
Valid SUSE registration and an entitlement for SLE HA on every node. The extension and package pattern must match the SLES service pack and architecture.
Static node addresses, working name resolution, synchronized clocks, and reliable cluster-network connectivity. Choose the intended Corosync interface deliberately; separate or redundant paths are useful in production designs.
A fencing plan. Fencing (STONITH, “Shoot the Other Node in the Head”) forcibly isolates or reboots a node that may be unhealthy, preventing both sides of a network split from writing to shared data. A supported cluster must have fencing enabled.
If using SBD (STONITH Block Device), a suitable watchdog on each node and properly designed shared block storage with a stable device path. A hardware watchdog is preferred for production. If using a physical power fence instead, configure and test a supported STONITH device.
For two nodes, plan a QDevice/QNetd witness before initialization if you intend to configure it through the bootstrap flow. A witness helps the cluster decide which side has quorum when connectivity is lost.
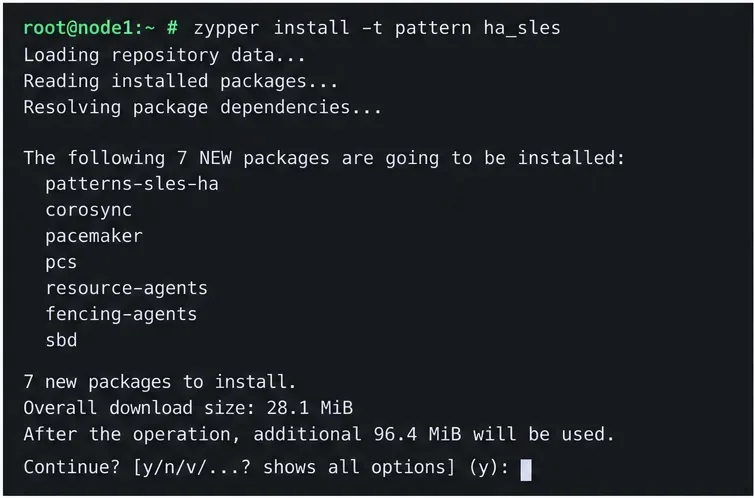
If SLE HA was not selected during SLES installation, enable the extension on each node. For a registered x86_64 SLES 15 SP7 host, the documented pattern is:
Replace ADDITIONAL_REGCODE with the SLE HA registration code. Use the activation product identifier that matches your own service pack and architecture; do not copy the SP7 example to a different SLES 15 service pack. Run the package-pattern command on both nodes. SUSE documents the ha_sles pattern as the set of packages used to configure and manage the cluster.
A terminal view of the High Availability pattern installation command on the first node.
Step 2: Prepare names, time, and network access
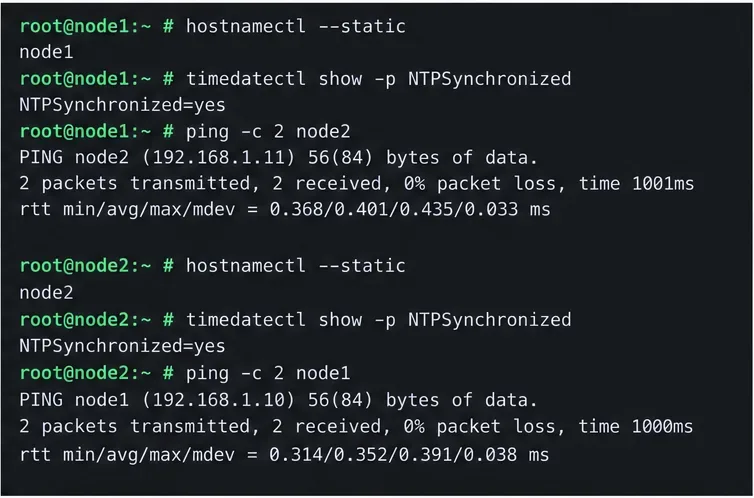
Give both nodes stable hostnames and static primary IP addresses. Confirm that each node can resolve the other by both short name and fully qualified name. SUSE’s setup guidance recommends listing cluster members in /etc/hosts when needed, because name resolution failures can break internal communication. For example, adapt entries like these to your DNS and address plan:
10.20.0.11 alice.example.net alice
10.20.0.12 bob.example.net bob
Synchronize both clocks to an NTP source outside the cluster and keep their time zones consistent. Chrony is the default NTP implementation on SLES 15. Check connectivity on the network you plan to use for Corosync. Bootstrap scripts can open the firewall ports needed for cluster communication, but confirm your host and network firewalls allow the traffic required by your selected topology. Unicast is the default in the bootstrap flow; the documented default Corosync port is 5405.
Preflight checks confirm the example node names, synchronized clocks, and peer connectivity.
Step 3: Initialize the first node
On alice, run the bootstrap command as root:
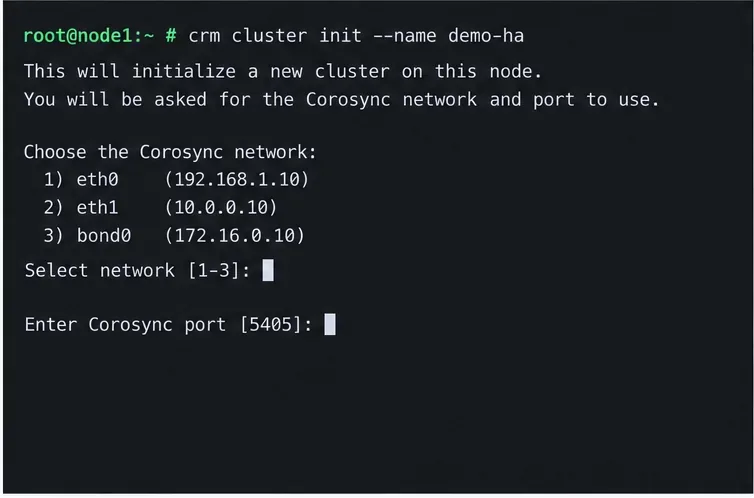
crm cluster init --name demo-ha
Przejrzyj monity przed ich zaakceptowaniem. Wybierz interfejs i adres sieciowy przeznaczony dla Corosync, a następnie potwierdź port. Skrypt sprawdza synchronizację czasu i dostępność watchdoga oraz może przygotować klucze SSH i powiązaną konfigurację klastra. Pyta, czy skonfigurować SBD, wirtualny adres IP administratora Hawk2 oraz QDevice/QNetd. SBD wymaga, aby watchdog i urządzenie współdzielone były już gotowe. Konfigurując QDevice w tym bootstrapie, należy najpierw przygotować serwer QNetd. Skrypt tworzy działający klaster jednowęzłowy; bobna tym etapie nie dodaje żadnych elementów.
Nie wybieraj losowego współdzielonego dysku ani ścieżki urządzenia dla SBD. Ścieżka musi identyfikować tę samą odpowiednią pamięć masową na każdym węźle, a jej zachowanie w przypadku awarii i przekroczenia limitu czasu muszą być zgodne z projektem pamięci masowej. SUSE zaznacza, że softdognie można zrestartować maszyny, jeśli wszystkie procesory są zablokowane, dlatego należy używać odpowiedniego sprzętowego mechanizmu nadzorującego (watchdog) w środowisku produkcyjnym, o ile jest dostępny.
Pierwszy węzeł uruchamia się automatycznie i wymaga podania sieci komunikacyjnej klastra oraz portu Corosync.
Krok 4: Dołącz do drugiego węzła
Po zainicjowaniu pierwszego węzła zaloguj się bobi uruchom:
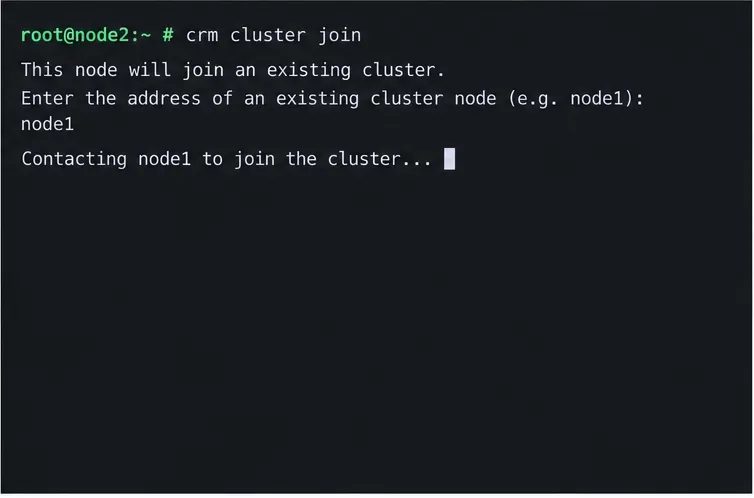
crm cluster join
Postępuj zgodnie z monitami, aby zidentyfikować istniejący węzeł klastra alice. Jeśli dla pierwszego węzła użyto konta sudo zamiast konta root, dokumenty SUSE określają to konto za pomocą -c, na przykład:
sudo crm cluster join -c USER@alice
Skrypt dołączania kopiuje konfigurację Corosync, konfiguruje SSH i Csync2, uruchamia bieżącą maszynę jako węzeł klastra i uruchamia usługę potrzebną dla Hawk2. Nie inicjuj obu maszyn niezależnie; drugi węzeł musi dołączyć do klastra utworzonego przez pierwszy.
Uruchom przepływ pracy dołączania na drugim węźle i skieruj go do zainicjowanego pierwszego węzła.
Krok 5: Sprawdź, czy oba węzły są online
Sprawdź podsumowanie klastra na dowolnym węźle:
crm status
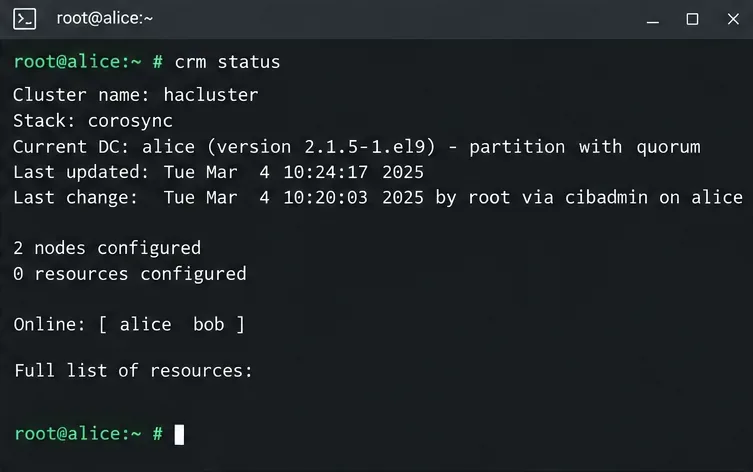
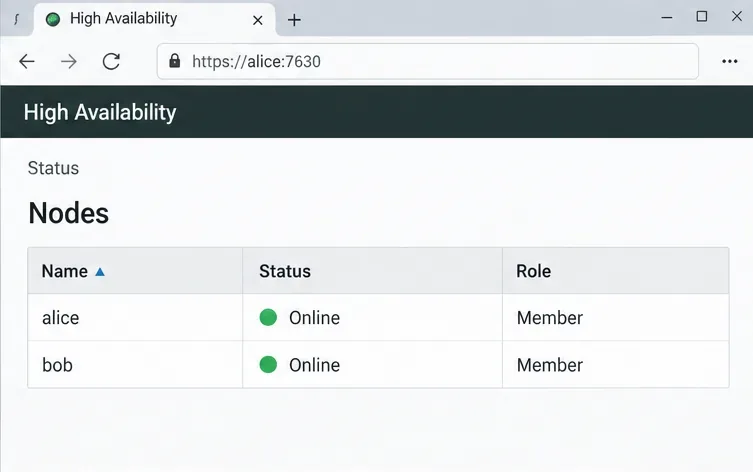
Poszukaj nazw węzłów w sekcji „Nazwa węzła” Onlineoraz partycji klastra z kworum. Przed kontynuowaniem sprawdź, czy nie wystąpiły błędy lub czy węzeł nie jest offline. Możesz również zalogować się do Hawk2 za pomocą konta VIP administratora wybranego podczas inicjalizacji, zazwyczaj w https://ADMIN-VIP:7630/. Ostrzeżenie o certyfikacie przy pierwszej wizycie może wystąpić, gdy używany jest certyfikat podpisany samodzielnie; zweryfikuj szczegóły certyfikatu z administratorem klastra, zamiast ignorować nieznany certyfikat w środowisku produkcyjnym.
Przed testowaniem przełączania awaryjnego sprawdzenie stanu klastra powinno wykazać, że oba węzły są online.Lista węzłów stanowi drugi sposób potwierdzania przynależności do klastra.
Krok 6: Zabezpiecz konto zarządzające
Procedura rozruchu tworzy haclusterkonto dla Hawk2. W podręczniku instalacji SUSE opisano domyślne hasło używane podczas podstawowej konfiguracji, dlatego należy je zmienić natychmiast przed pozostawieniem systemu dostępnego:
passwd hacluster
Używaj unikalnego, silnego hasła i postępuj zgodnie z polityką poświadczeń obowiązującą w Twojej organizacji. Ogranicz dostęp do sieci zarządzania Hawk2, zainstaluj zaufane certyfikaty w razie potrzeby i nie udostępniaj interfejsu zarządzania bezpośrednio w publicznym internecie.
Krok 7: Bezpieczne testowanie planowanego przejścia w tryb failover
Planowany test gotowości sprawdza, czy wirtualny adres IP zarządzania może zostać przeniesiony, gdy jeden z węzłów zostanie celowo usunięty z zasobów. Przed testowaniem upewnij się, że oba węzły są sprawne, klaster ma kworum i masz dostęp do konsoli lub poza pasmem na wypadek nieoczekiwanego zachowania. Z klienta w tej samej sieci, stale wysyłaj pingi do adresu VIP zarządzania, na przykład:
ping 10.20.0.20
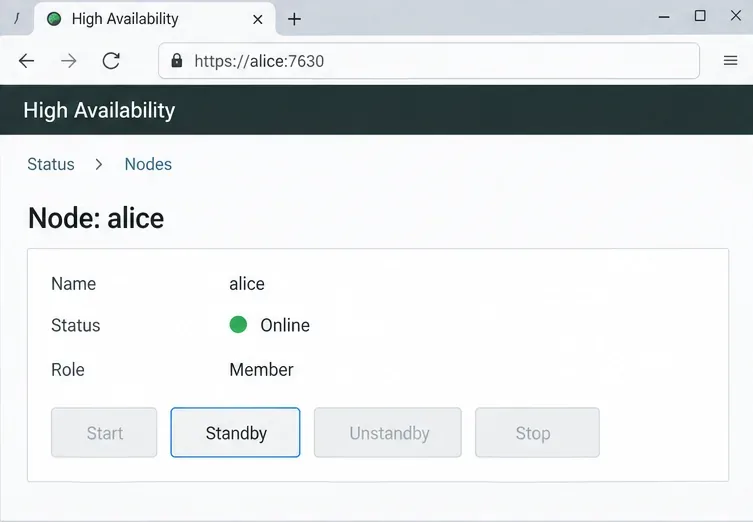
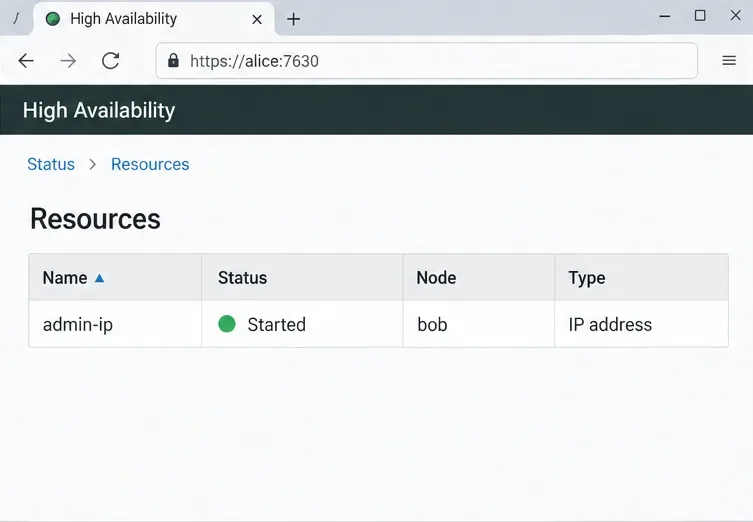
W Hawk2 otwórz węzeł, który aktualnie obsługuje adres IP administratora i wybierz opcję „Czuwanie” . Następnie sprawdź „Stan > Zasoby” . Szybki start SUSE opisuje przeniesienie zasobu pływającego na inny węzeł podczas trwania pingowania. Po zakończeniu testu przywróć węzeł do działania, wykonując odpowiednią akcję w Hawk2, upewnij się, że oba węzły są online i sprawdź, czy zasób znajduje się w oczekiwanej lokalizacji.
Użyj zaplanowanej akcji rezerwowej na aktywnym węźle, aby przetestować ruch zasobów bez symulowania awarii.Po przejściu w tryb gotowości sprawdź, czy adres IP administratora działa na drugim węźle.
Co ten test udowadnia, a czego nie?
Jeśli oba węzły pozostaną widoczne, a adres IP administratora zostanie przeniesiony na węzeł równorzędny, uzyskasz dowód, że podstawowe członkostwo w klastrze i zmienne zasoby IP działają w tym planowanym scenariuszu. Sam ping nie dowodzi dostępności aplikacji, przetrwania sesji klientów, ochrony współdzielonych danych ani możliwości odzyskania sprawności klastra po każdej awarii sieci, pamięci masowej, zasilania lub oprogramowania.
W przypadku aplikacji należy dodać odpowiedniego agenta zasobów i skonfigurować kolejność, kolokację, monitorowanie, dostęp do pamięci masowej i odgradzanie zgodnie z projektem aplikacji. Nigdy nie należy pozwalać dwóm węzłom na jednoczesne zapisywanie danych w zwykłej, współdzielonej pamięci masowej. Przed uruchomieniem należy przetestować odzyskiwanie obciążenia i integralność danych w środowisku przejściowym, uwzględniając realistyczne awarie węzłów i sieci.
Typowe błędy, których należy unikać
Pomijanie ogrodzenia: klaster bez działającego STONITH nie jest w stanie bezpiecznie rozwiązać problemu rozdzielenia mózgu i nie spełnia wymagań wsparcia technicznego SUSE.
Zakładając, że dwa węzły mogą samodzielnie podjąć decyzję: zaplanuj QDevice/QNetd dla klastra o parzystym numerze, szczególnie dla klastra dwuwęzłowego.
Korzystanie z niestabilnej lub niedopasowanej tożsamości węzła: używaj statycznych adresów, spójnych nazw hostów, rozwiązywania nazw w przód i w tył oraz synchronizacji czasu.
Ponowne wykorzystanie niewłaściwej sieci: wybierz odpowiedni interfejs Corosync i zweryfikuj politykę zapory na każdej ścieżce sieciowej.
Zakładając, że klaster automatycznie chroni aplikację: klaster może zarządzać tylko tymi zasobami, które zostały skonfigurowane i przetestowane.
Nazywając początkowy bootstrap „gotowym do produkcji”: szybki start to podstawowa konfiguracja. Gotowość do produkcji wymaga testów odzyskiwania danych specyficznych dla obciążenia, walidacji odgrodzenia, monitorowania, procedur tworzenia kopii zapasowych i przywracania oraz udokumentowanych operacji.