Jeśli serwer SUSE Linux wydaje się zawieszać podczas restartu po wyświetleniu komunikatu o wyłączeniu systemu, najskuteczniejszym pierwszym założeniem nie jest to, że samo polecenie restartu jest uszkodzone. W większości przypadków systemd czeka na zakończenie działania jednostki, montowania, procesu lub haka wyłączającego. Najbezpieczniejszym rozwiązaniem jest zatem zidentyfikowanie konkretnego zadania, które nadal działa, sprawdzenie, dlaczego się nie zatrzymuje, i naprawienie tego komponentu, zamiast globalnego skracania limitów czasu wyłączania.
W niniejszym przewodniku wykorzystano hipotetyczny przykład : serwer o nazwie lab-sles01SUSE Linux Enterprise Server uruchamia się i zatrzymuje podczas ponownego uruchamiania, wyświetlając komunikat podobny do A stop job is running for backup.service. Przykład ten stanowi jedynie ilustrację metody diagnostycznej; nie jest raportem z rzeczywistego testu ani stwierdzeniem, że konkretna wersja systemu SUSE ma wadę w usłudze o nazwie backup.service.
Krótki opis naprawy w czterech krokach
| Krok | Co robić | Czego próbujesz się nauczyć |
|---|
| 1 | Zapisz dokładny komunikat o wyłączeniu | Która jednostka lub etap blokuje postęp |
| 2 | Przejrzyj poprzedni dziennik rozruchu | Czy zatrzymanie nastąpiło po upływie limitu czasu, nie udało się odmontować urządzenia lub wyłączenie osiągnęło późniejszy etap |
| 3 | Sprawdź jednostkę blokującą i prace na żywo | Czy odpowiedzialna jest usługa, mocowanie, inhibitor czy zależność |
| 4 | Napraw przyczynę źródłową i przetestuj ponownie | Czy normalność systemctl rebootteraz kończy się bez opóźnień |
Krok 1: Zapisz dokładnie miejsce, w którym następuje zatrzymanie wyłączenia
Obserwuj konsolę lokalną, konsolę maszyny wirtualnej, konsolę BMC/IPMI lub konsolę hiperwizora podczas planowanego restartu. Wiersz z nazwą jednostki jest o wiele bardziej przydatny niż ogólny opis, taki jak „systemd zawiesił się”. W hipotetycznym przypadku lab-sles01załóżmy, że konsola pokazuje, że backup.servicejednostka nadal się zatrzymuje, podczas gdy inne jednostki już się wyłączyły.
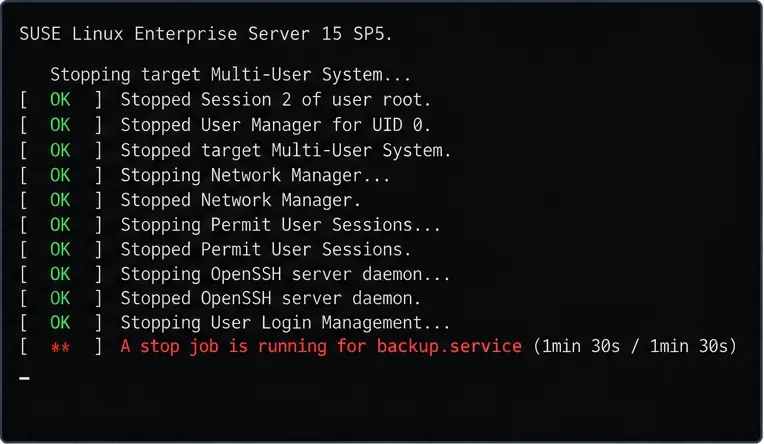
Przykład ilustrujący: konsola wyłączania identyfikuje backup.servicejednostkę, na którą systemd nadal czeka.
Jeśli konsola zamiast tego podaje nazwę .mountjednostki, sieciowego systemu plików, urządzenia lub innej usługi, należy postępować zgodnie z tą nazwą, zamiast stosować ogólny limit czasu usługi. Jednostka wyświetlana u dołu konsoli jest wskazówką, a nie automatycznie przyczyną problemu: sama może oczekiwać na proces potomny, pamięć masową, wejście/wyjście sieciowe lub inną zależność.
Aktualne wytyczne SUSE dotyczące systemu systemd wskazują, że długi restart lub wyłączenie zasilania może być spowodowane przez usługę, która nie jest zamykana, i zalecają sprawdzenie zadań systemd. Zobacz SUSE Linux Enterprise Server 16.0: Wprowadzenie do podstaw systemd .
Krok 2: Użyj poprzedniego dziennika rozruchowego po powrocie serwera
Po ponownym uruchomieniu komputera sprawdź, czy nastąpiło wyłączenie. SUSE dokumentuje przesunięcia rozruchu w dzienniku: „boot” 0oznacza bieżące uruchomienie, „boot” -1oznacza poprzednie uruchomienie itd. Zacznij od:
sudo journalctl --list-boots
sudo journalctl -b -1
W przypadku dużego dziennika odwrotna kolejność pozwala szybciej wyświetlić ostatnie wiadomości:
sudo journalctl -b -1 -r

Przykład ilustrujący: dziennik poprzedniego uruchomienia pokazuje hipotetyczną usługę kopii zapasowej otrzymującą sygnał SIGTERM i później przekraczającą limit czasu.
Szukaj fraz takich jak Stopping, stop job, timed out, Failed with result, Unmounting, Dependency failed, lub wiadomości od podejrzanej usługi. Możesz zawęzić widok, znając nazwę jednostki:
sudo journalctl -b -1 -u backup.service
Dokumenty SUSE journalctl -b -1dotyczące analizy poprzedniego rozruchu znajdują się w dokumentacji dziennika SLES 15 SP7 . Jeśli journalctl --list-bootsnie zawierają one wcześniejszego rozruchu, nie należy wyciągać wniosków z brakującej historii; należy sprawdzić konfigurację pamięci masowej dziennika i użyć konsoli lub zdalnego logowania do następnego odtworzenia.
Krok 3: Określ, czy bloker jest usługą, montowaniem, inhibitorem czy hakiem późnego wyłączania
Jeśli uda Ci się odtworzyć problem w oknie konserwacji, miej dostępną drugą konsolę administracyjną. Zanim łączność zniknie, uruchom:
sudo systemctl list-jobs
sudo systemctl status backup.service
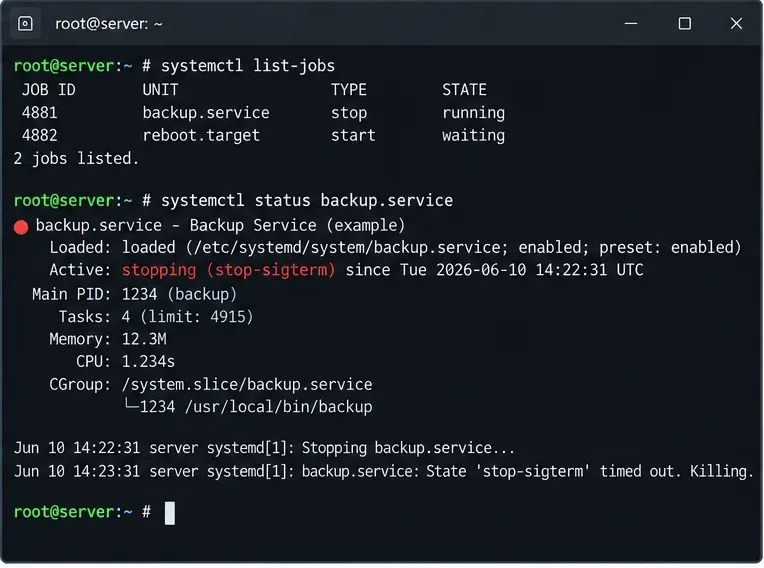
Przykład ilustrujący: backup.servicetrwa zadanie zatrzymania, podczas gdy cel ponownego uruchomienia czeka za nim.
Wskazówki dotyczące debugowania w systemie systemd wyjaśniają, że zadania oznaczone jako runningmuszą się zakończyć, zanim zadania zależne oznaczone jako waitingbędą mogły być kontynuowane. SUSE zaleca to również systemctl list-jobsw przypadku, gdy wyłączanie lub ponowne uruchamianie trwa zbyt długo. To sprawia, że to polecenie jest szczególnie przydatne, gdy serwer nie jest całkowicie zawieszony, a PID 1 nadal odpowiada.
Jeśli usługa zatrzymuje się zbyt wolno
Sprawdź definicję jednostki i jej zachowanie podczas wyłączania:
sudo systemctl cat backup.service
sudo systemctl status backup.service
sudo journalctl -u backup.service -b
Sprawdź, czy usługa wykonuje akcję ExecStop=, czy jej proces obsługuje sygnał SIGTERM i czy oczekuje na zasoby pamięci masowej lub sieciowe. Baza danych, agent kopii zapasowej lub usługa oprogramowania pośredniczącego mogą potrzebować czasu na usunięcie danych, więc wcześniejsze zamknięcie usługi nie jest automatycznym rozwiązaniem.
Jeśli chodzi o montowanie lub system plików sieciowych
Poszukaj nieudanych operacji odmontowywania i zidentyfikuj źródło montowania:
findmnt
systemctl list-units --type=mount
sudo journalctl -b -1 | grep -Ei 'unmount|umount|mount|nfs|cifs'
W przypadku NFS lub CIFS sprawdź dostępność serwera, nieaktualne sesje i czy opcje montowania spełniają wymagania dotyczące wyłączania serwera. Jeśli zablokowana jednostka jest generowana z /etc/fstab, popraw konfigurację montowania zamiast stosować limit czasu specyficzny dla usługi do niezwiązanej jednostki.
Jeśli żądanie ponownego uruchomienia jest blokowane
Przed rozpoczęciem wyłączania możesz wyświetlić listę aktywnych inhibitorów systemd:
systemd-inhibit --list
Blokady typu „inhibitor” mogą blokować lub opóźniać żądania zamknięcia aplikacji, gdy wykonuje ona zadania, których nie powinna przerywać. Są one najbardziej przydatne, gdy samo żądanie ponownego uruchomienia jest opóźnione przed wejściem systemu w ostateczną sekwencję zamykania. Zapoznaj się z podręcznikiem systemd-inhibit .
Jeśli zawieszenie nastąpi po wyłączeniu usług
Zawieszenie się systemu na późniejszym etapie wymaga osobnego zbadania. Systemd uruchamia pliki wykonywalne na /usr/lib/systemd/system-shutdown/krótko przed ostatecznym ponownym uruchomieniem lub wyłączeniem zasilania i czeka na ich zakończenie. Jeśli dziennik i konsola pokazują, że zwykłe usługi są już zatrzymane, a problem występuje na etapie końcowego wyłączania systemu, należy sprawdzić ten katalog i wszelkie zainstalowane przez dostawcę haki. To zachowanie opisano w dokumentacji usługi wyłączania systemu systemd .
Krok 4: Napraw komponent, a następnie przetestuj normalne ponowne uruchomienie
Wróćmy do hipotetycznego scenariusza lab-sles01. Załóżmy, że logi pokazują, że backup.serviceignoruje on normalne zakończenie działania po zakończeniu procesu tworzenia kopii zapasowej. Pierwszym wyborem jest naprawienie usługi lub jej polecenia zatrzymania. Jeśli wiadomo, że usługa może bezpiecznie zakończyć działanie po określonym czasie, nadpisanie jednostkowe w systemied może ograniczyć czas oczekiwania.
Utwórz nadpisanie zamiast edytować jednostkę dostawcy w /usr/lib/systemd/system:
sudo systemctl edit backup.service
Na przykład:
[Service]
TimeoutStopSec=30s
Następnie przeładuj konfigurację jednostki systemd:
sudo systemctl daemon-reload
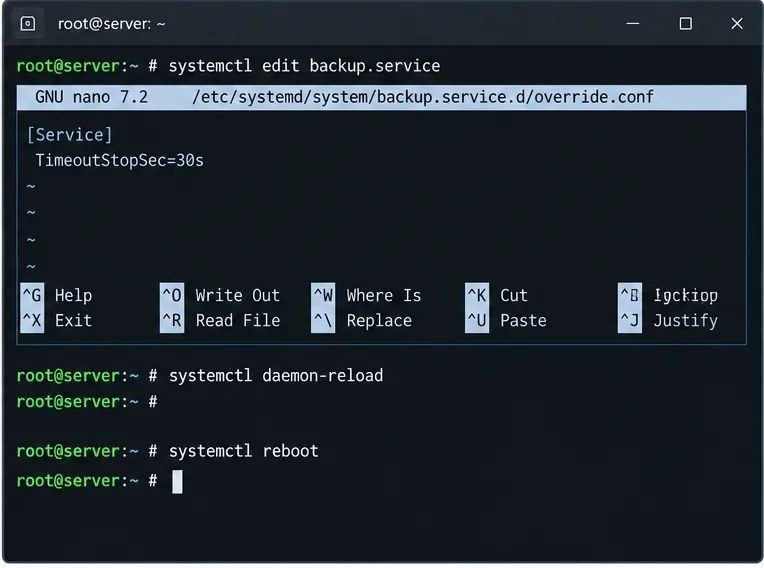
Przykład ilustrujący: limit czasu dla danej usługi jest stosowany dopiero po zidentyfikowaniu hipotetycznej usługi jako blokującej.
Nie kopiuj wartości 30 sekund bezmyślnie. Prawidłowy limit czasu zależy od tego, co usługa musi bezpiecznie zakończyć. Skrócenie go dla bazy danych, demona pamięci masowej, usługi klastrowej lub procesu tworzenia kopii zapasowej może przerwać prawidłowe czyszczenie. Limit czasu jest zabezpieczeniem, a nie substytutem naprawy uszkodzonej ExecStop=akcji lub aplikacji, która nie kończy się poprawnie.
Gdy będziesz zadowolony ze zmian, przetestuj normalny restart:
sudo systemctl reboot
Po powrocie urządzenia sprawdź jeszcze raz poprzednie uruchomienie i upewnij się, że urządzenie zatrzymało się prawidłowo, a nie po prostu zniknęło z konsoli.
Kiedy należy zastosować wymuszone ponowne uruchomienie?
Wymuszony restart to opcja odzyskiwania, a nie strategia rozwiązywania problemów. Dokumentacja systemu systemd podaje, że taki restart --forcepomija systemctl rebootnormalne zamykanie usług, ale nadal zamyka procesy i próbuje odmontować lub ponownie zamontować systemy plików w trybie tylko do odczytu. --forceDwukrotne podanie jest bardziej niebezpieczne, ponieważ może spowodować restart bez zamykania procesów lub odmontowywania systemów plików, co wiąże się z ryzykiem utraty danych.
Jeśli serwer jest już zablokowany i nie ma bezpieczniejszego sposobu na przywrócenie usługi, w ramach procedur operacyjnych uzasadnione może być wymuszone ponowne uruchomienie:
sudo systemctl reboot --force
Unikaj traktowania systemctl reboot --force --force, wirtualnego cyklu zasilania lub fizycznego resetu jako standardowej naprawy. Takie działania mogą usunąć potrzebne dowody i zagrozić zapisom w trakcie pracy. Dokumentacja systemu systemctl wyraźnie rozróżnia zachowania pojedynczego i podwójnego wymuszenia.
Co zrobić, jeśli każde ponowne uruchomienie komputera powoduje zawieszenie się systemu i nie można rozwiązać problemu w trybie normalnym?
Użyj konsoli konserwacyjnej i uruchom system w trybie ratunkowym. Dokumenty SUSE dotyczące dodawania systemd.unit=rescue.targetpoleceń do jądra z poziomu edytora GRUB. Tryb ratunkowy zapewnia sesję root z lokalnymi systemami plików i usługami podstawowymi, pozostawiając jednocześnie sieć nieaktywną, co może pomóc w wyłączeniu lub naprawieniu usługi lub konfiguracji montowania powodujących problem.
Oficjalną procedurę trybu ratunkowego można znaleźć w Podręczniku administratora systemu SLES 15 SP7 . W systemach, w których problem pojawia się dopiero po zmianie konkretnego pakietu, jądra, sterownika lub pamięci masowej, przed wprowadzeniem trwałych zmian limitu czasu należy również zapoznać się z historią konserwacji systemu SUSE.
Szybka tabela decyzyjna
| Co widzisz | Prawdopodobny obszar do inspekcji | Najlepsza następna akcja |
|---|
A stop job is running for xyz.service | Ścieżka wyłączenia usługi | Sprawdź systemctl status, plik jednostki i dziennik serwisowy |
| Powtarzające się komunikaty o odmontowywaniu lub zdalnym systemie plików | Montowanie, NFS, CIFS, przechowywanie | Sprawdź findmnt, zamontuj jednostki /etc/fstabi dostępność serwera |
| Żądanie ponownego uruchomienia zostało odrzucone lub opóźnione przed wyłączeniem | Inhibitor lub inna praca systemd | Biegnij systemd-inhibit --listisystemctl list-jobs |
| Usługi są zatrzymywane, ale ostateczne wyłączenie nigdy się nie kończy | Późne wyłączenie haka, jądro, sterownik, magazyn | Przejrzyj poprzedni dziennik rozruchu i/usr/lib/systemd/system-shutdown/ |
| Zwykły but uniemożliwia naprawę | Trwała konfiguracja lub awaria jednostki | But zsystemd.unit=rescue.target |
Podsumowanie
W przypadku serwera SUSE Linux zawieszającego się podczas wyłączania systemu systemd, trwałym rozwiązaniem jest zidentyfikowanie zadania, na które systemd czeka, i naprawienie tej jednostki lub jej zależności. Zapisz komunikat o wyłączeniu, sprawdź journalctl -b -1, użyj systemctl list-jobsi , systemctl statusaby wyizolować bloker, a dopiero potem zmień limit czasu dla usługi lub konfigurację montowania. Zachowaj metody wymuszonego restartu na wypadek sytuacji awaryjnych, a nie na potrzeby rutynowych operacji.


