Início
» ADMINISTRADOR DE REDE
»
Melhores práticas de monitoramento de rede: o que monitorar e quais ferramentas usar
Melhores práticas de monitoramento de rede: o que monitorar e quais ferramentas usar
O monitoramento eficaz da rede começa com um inventário verificado, métricas focadas no serviço e alertas acionáveis. Mapeie dispositivos e serviços críticos, estabeleça o desempenho normal e, em seguida, escolha uma plataforma que suporte sua infraestrutura e possa ser mantida por sua equipe. Isso ajuda a identificar problemas em desenvolvimento sem transformar cada pequena oscilação em uma página de alerta.
O que o monitoramento de rede deve lhe dizer
O monitoramento de rede rastreia se os dispositivos e serviços estão acessíveis e como eles se comportam ao longo do tempo. Geralmente, abrange o status de dispositivos e interfaces, tráfego, recursos do servidor e verificações de serviço. O registro de segurança tem uma função diferente: um NMS (Sistema de Gerenciamento de Rede) explica a disponibilidade e o desempenho, enquanto registros centralizados ou um SIEM (Sistema Integrado de Gerenciamento de Eventos e Informações) ajudam a investigar eventos como logins suspeitos e alterações de configuração. Muitas equipes usam ambos. O NIST define o monitoramento contínuo como uma consciência constante para a tomada de decisões de risco; revise a cobertura da rede conforme o ambiente muda.
Melhores práticas de monitoramento de rede
1. Crie um inventário antes de configurar alertas.
Liste roteadores, switches, firewalls, equipamentos sem fio, servidores críticos, links de nuvem e serviços voltados para o cliente. Para cada um, registre a localização, o proprietário, a prioridade comercial, o endereço de gerenciamento e as dependências. Use a descoberta para iniciar o inventário e, em seguida, verifique-o e adicione os dispositivos que não puderem ser encontrados automaticamente. Agrupe por site ou serviço. Atualize a lista após as alterações para que a cobertura permaneça completa.
Um exemplo de visualização de topologia relaciona o estado do dispositivo às dependências a montante e a jusante.
2. Monitore os sinais que explicam o impacto no usuário.
Comece com um conjunto compacto de métricas vinculadas a serviços críticos:
Disponibilidade: status do dispositivo e da interface, além de verificações de serviços essenciais como DNS, aplicativos da web, e-mail ou acesso VPN.
Qualidade do percurso: latência, perda de pacotes e jitter, onde a transmissão de voz ou vídeo em tempo real depende disso.
Tráfego e capacidade: utilização da interface, taxa de transferência, erros e descartes. Mantenha um histórico para que você possa distinguir um pico momentâneo de um problema recorrente de capacidade.
Estado de saúde do dispositivo: informações sobre CPU, memória, temperatura, energia ou status da ventoinha, quando o equipamento disponibiliza essas leituras.
Sistemas de suporte: armazenamento do servidor e integridade do serviço quando uma interrupção do aplicativo pode ser causada fora da camada de rede.
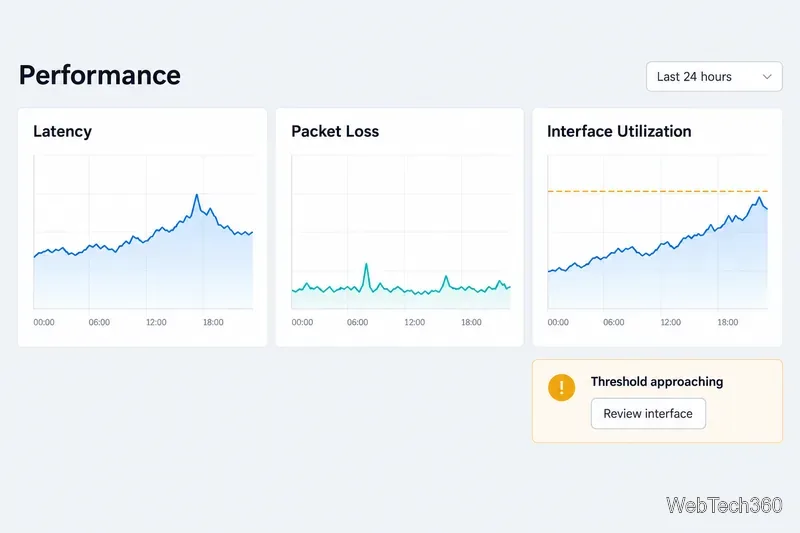
Defina valores de referência por local e serviço, em vez de usar um limite universal. Compare o comportamento atual com os períodos de pico normais e observe se há pressão constante ou mudanças repentinas.
Um exemplo de painel de desempenho ajuda a separar a variação normal da pressão sustentada em um link.
3. Torne os alertas acionáveis e reduza as duplicatas.
Alerta sobre condições que exigem ação: interrupções, falhas em verificações de serviço ou violações sustentadas de limites. Use uma regra de atraso ou recuperação para filtrar oscilações transitórias. Inclua o dispositivo ou interface, o serviço ou site afetado, o horário da primeira detecção, os valores observados e esperados e um plano de execução. Direcione os alertas para um responsável e defina a escalação.
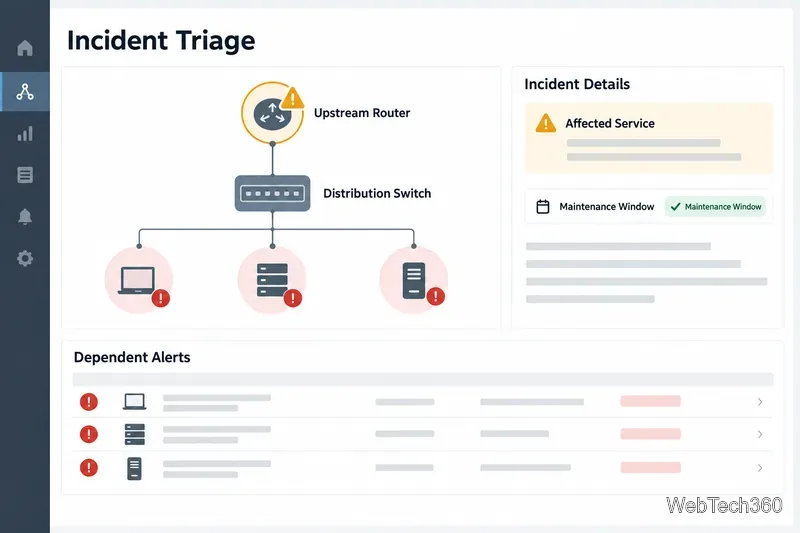
Agrupe alertas de fluxos subsequentes quando uma falha em um fluxo anterior os justificar; agende janelas de manutenção para trabalhos planejados. Isso ajuda as equipes de resposta a encontrar as causas prováveis mais rapidamente. Revise as regras de supressão após alterações na topologia para que falhas independentes permaneçam visíveis.
Um exemplo de visualização de incidente mostra como alertas dependentes podem direcionar os responsáveis pela resposta para o primeiro link com falha.
4. Proteja o sistema de monitoramento.
O monitoramento de credenciais e logs pode revelar informações sensíveis da infraestrutura. Restrinja o tráfego de gerenciamento, utilize contas somente leitura sempre que possível, conceda acesso baseado em funções e proteja o servidor de monitoramento e os backups. Dê preferência ao SNMPv3 quando compatível, com configurações de autenticação e privacidade adequadas; o Modelo de Segurança Baseado no Usuário do SNMPv3 define esses serviços de segurança. Siga as diretrizes da CISA para proteção de logs e nunca exponha as interfaces de gerenciamento diretamente à internet pública.
5. Testar a cobertura, alertas e recuperação
Confirme se as sondagens alcançam os dispositivos a partir de locais relevantes, se as credenciais funcionam e se o histórico é mantido para solução de problemas e planejamento de capacidade. Teste os alertas com seus destinatários; documente os proprietários e os cronogramas de manutenção. Analise dispositivos obsoletos, lacunas e regras ruidosas após alterações na rede. Mantenha um plano de recuperação testado para a plataforma de monitoramento.
Três ferramentas de monitoramento de rede para avaliação
Esses produtos atendem às necessidades mais comuns. A adequação depende do seu ambiente, modelo de implantação, licenciamento e habilidades disponíveis. Verifique os planos e o suporte a dispositivos com cada fornecedor.
Ferramenta
Onde isso pode se encaixar
Verificar durante a avaliação
Monitor de desempenho de rede SolarWinds
Ambientes com múltiplos fornecedores que necessitam de métricas de dispositivos, mapas, alertas, relatórios ou solução de problemas de roteamento. O fornecedor lista disponibilidade, latência, perda de pacotes, utilização e integridade do dispositivo.
Verifique a compatibilidade com dispositivos e protocolos, a implantação, a retenção e os módulos necessários. Consulte o SolarWinds NPM .
Monitor de rede Paessler PRTG
Equipes monitoram dispositivos, tráfego, servidores e serviços com mapas, painéis e notificações. O PRTG representa os valores monitorados como sensores.
Calcule as necessidades de sensores e sondas para o seu plano de cobertura. Consulte o Paessler PRTG .
ManageEngine OpManager
Organizações que buscam descoberta e monitoramento de desempenho em dispositivos de rede e servidores. A documentação descreve o suporte a SNMP, CLI e WMI.
Verifique o acesso ao protocolo, modelos, controles de função, complementos e gerenciamento de sites remotos. Consulte o OpManager .
Escolha com um pequeno piloto
Faça um teste piloto em um site representativo, um serviço crítico e uma combinação de dispositivos. Teste a descoberta, a precisão das métricas, os alertas, o gerenciamento de manutenção, os relatórios, as permissões e a recuperação. Pergunte aos usuários do painel de controle qual contexto está faltando. Um breve teste piloto mostra se a plataforma se adapta melhor à sua rede do que uma lista de verificação de recursos.