修復客戶端瀏覽器上 Jitsi Meet 的 CPU 使用率過高問題。

透過檢查視訊圖塊、相機效果、瀏覽器圖形和主機設定來診斷 Jitsi Meet 瀏覽器 CPU 峰值並降低客戶端負載。
當 Jitsi 會議開始出現卡頓時,管理員可能會收到關於音訊斷斷續續或視訊卡頓的投訴,但卻無法快速判斷是橋接器過載、無法連接,還是僅僅因為流量過大。 Jitsi Videobridge (JVB) 可以公開運作指標,供 Prometheus 收集並由 Grafana 顯示。本指南將逐步介紹實際的設定流程,從本地端點檢查開始,最終產生一個可供驗證的儀表板。
範例場景:假設一個小型組織在 Linux 主機上執行一個 JVB,並在同一台主機上執行 Prometheus 和 Grafana。這只是一個範例,並非實際部署或測試的報告。如果您的服務運行在不同的容器或伺服器上,請替換為它們可存取的內部位址,並保持相同的網路限制。
目前的 JVB 專案文件描述了橋接器私有 HTTP 介面上的一個內建 Prometheus/OpenMetrics 端點/metrics。它列出了諸如活躍會議數、端點數、傳入和傳出位元率、資料包速率以及橋接器壓力等統計資料。 Prometheus 的描述並不一定包含 JVB 其他報告格式提供的所有統計信息,因此請將您已安裝版本提供的端點視為權威來源。參考配置目前啟用了 Prometheus REST 資源並將私有 HTTP 介面綁定到回環位址;文件中記錄的預設私有 HTTP 連接埠為 8080。舊版軟體包和部署模板可能有所不同。
Prometheus 抓取並儲存時間序列資料。 Grafana 連接到 Prometheus 作為資料來源,並查詢這些儲存的序列。對於這種直接的 JVB 指標路徑,無需單獨的 Jitsi 匯出器。請參閱 Jitsi 的統計資料和 Prometheus 端點文件、其私有 HTTP 介面配置以及參考配置。這些上游檔案可能會變更;在套用範例值之前,請檢查您自己的橋接器上安裝的設定和版本。
在 JVB 機器上,首先要確定目前活動的配置。常見的 Debian 或 Ubuntu 軟體包使用 `/etc/config/config.js` /etc/jitsi/videobridge/jvb.conf,但 Jitsi 指出,實際的檔案路徑取決於傳遞給橋接程序的路徑。容器部署可能會掛載產生的配置。不要假設範例檔案就是運行中的服務讀取的檔案。
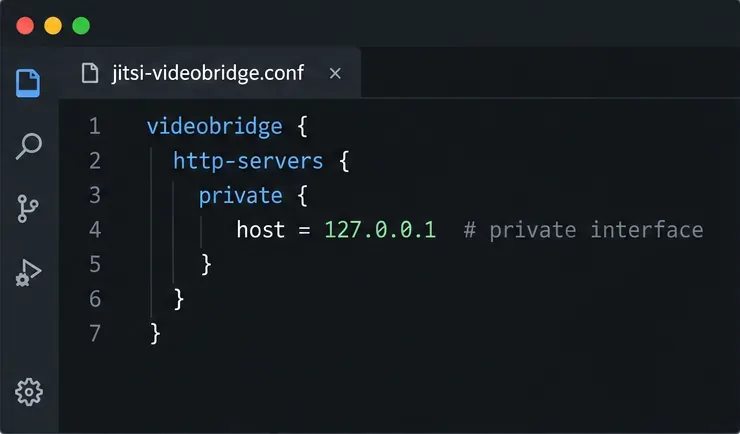
使用範例中的預設連接埠和環回綁定,在 JVB 主機上執行以下命令:
curl -fsS http://127.0.0.1:8080/metrics | head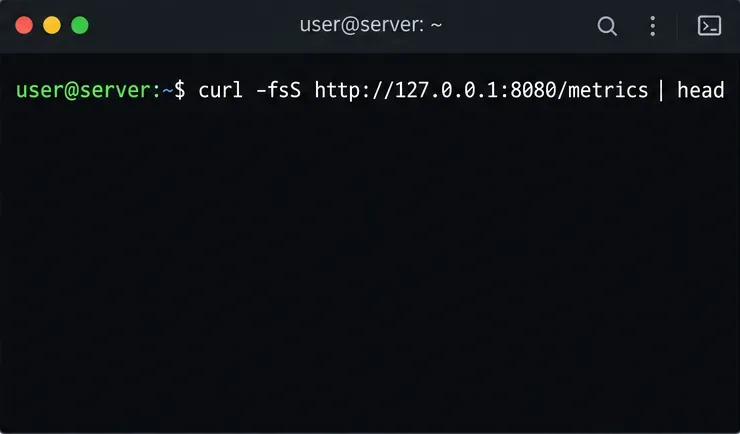
/metrics在配置 Prometheus 之前,請檢查本地端點。成功的回應是包含 Prometheus 指標族的純文本,通常帶有 `&`# HELP和 `& # TYPE` 行,後面跟著範例。圖示僅顯示命令,並不代表伺服器正在回應。連接被拒絕通常意味著 JVB 已停止運行,正在監聽其他位址或端口,或已安裝的配置停用了該 HTTP 監聽器。 HTTP 404 表示伺服器已回應,但該路由在該版本或 API 配置中不可用。請檢查 JVB 日誌和已安裝版本的配置,而不是僅僅為了讓 Prometheus 路徑正常工作而啟用無關的 Colibri 控制 API。
您可以使用以下命令直接查看指標名稱和類型:
curl -fsS http://127.0.0.1:8080/metrics | grep -E '^(# HELP|# TYPE)' | head -n 40JVB 文件指出,可用的 Prometheus 指標並非其 JSON 統計資料的完整反映。它還指出,會議規模的直方圖僅以 Prometheus 格式提供。在撰寫 PromQL 查詢或匯入使用特定名稱的儀表板之前,請檢查您安裝的版本實際傳回的內容。
當 Prometheus 與 JVB 運作在同一主機上時,請保持私有介面開啟127.0.0.1。這樣可以避免打開另一個網路監聽器。在假設的同主機配置中,127.0.0.1:8080Prometheus 可以直接存取目標。
如果 Prometheus 運行在其他位置,JVB 的預設回環綁定將不接受來自該位置的連線。您可以將私有監聽器配置為綁定到 Prometheus 可存取的內部接口,然後限制防火牆或容器網絡,使只有 Prometheus 主機才能連接到該私有連接埠。請勿將連接埠 8080 或 8443 暴露給公用網際網路:Jitsi 明確指出此介面為私有介面,並聲明其端點不用於公用存取。如果環境需要傳輸加密,則配置了金鑰庫後,私有介面支援 TLS;或者,使用嚴格控制的內部 TLS 代理程式。避免複製0.0.0.0未附帶存取限制的廣泛公共綁定。
變更監聽器設定後,請使用部署支援的設定機制,並僅在版本需要時重新啟動或重新載入 JVB。重啟可能會中斷單橋部署上的調用,因此請合理安排重啟時間。在 Docker 中,請編輯用於產生該配置的持久性主機端配置或環境,而不是臨時容器檔案。curl在繼續操作之前,請先從 Prometheus 伺服器驗證監聽器。
在 Prometheus 設定檔中新增抓取任務。以同主機範例為例,相關部分如下:
scrape_configs:
  - job_name: jitsi-videobridge
    metrics_path: /metrics
    static_configs:
      - targets:
          - 127.0.0.1:8080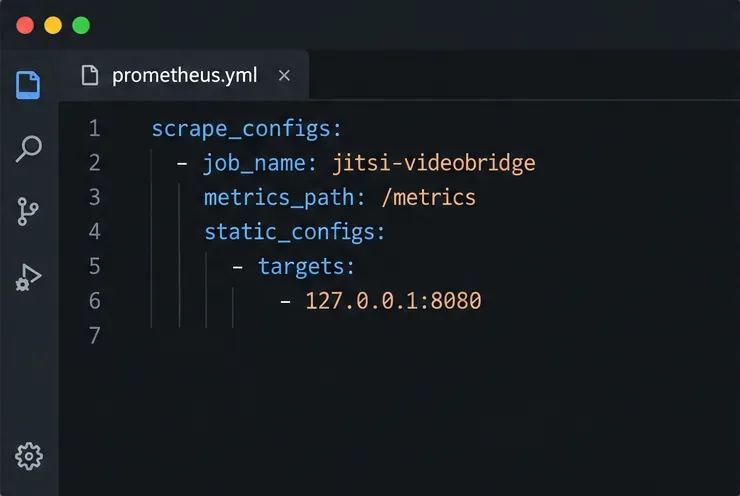
Prometheus 配置scrape_configs支援小型固定部署的靜態目標。如果 JVB 位於不同的容器中,127.0.0.1則指向 Prometheus 容器本身;在共用的私人 Docker 網路上,則應使用 JVB 服務名稱和連接埠。對於遠端主機,請使用其私人 DNS 名稱或位址,並縮小防火牆規則的範圍。 Prometheus配置參考文件詳細說明了抓取作業、目標和間隔設定。
在套用變更之前,請使用安裝包中自帶的 Prometheus 工具驗證整個檔案:
promtool check config /etc/prometheus/prometheus.yml如果驗證成功,請使用為您的服務配置的方法重新載入 Prometheus;如果未啟用重新載入,則重新啟動 Prometheus。不要僅憑有效的 YAML 檔案就斷定驗證成功;即使語法正確的目標仍然可能無法存取。
在 Grafana 中,新增內建的 Prometheus 資料來源,並輸入 Grafana 本身可以存取的 URL。http://localhost:9090如果 Grafana 直接運行在主機上,則此localhostURL 指的是 Grafana 容器本身,而不是主機或 Prometheus 容器;在共享網路上,請使用 Prometheus 服務名稱。儲存並測試資料來源。 Grafana 的Prometheus 資料來源指南介紹了連接設置,其資料來源文件解釋了 Grafana 如何查詢指標後端。
開啟 Explore,選擇 Prometheus,然後運行up{job="jitsi-videobridge"}。這是 Prometheus 抓取健康狀況檢查,而非 Jitsi 指標。值為 1 表示 Prometheus 已成功抓取目前評估的目標;值為 0 表示已配置的目標抓取失敗。如果查詢未傳回任何序列,請確認作業名稱、設定是否已重新載入、目標是否已發現以及所選時間範圍是否正確。

up系列工具檢查抓取健康狀況,然後再查詢 JVB 特定指標。一旦up系統運作正常,請使用 Grafana Explore 的指標瀏覽器或 Prometheus 的表達式瀏覽器來尋找您的版本公開的 JVB 系列。首先,提出一些簡單的操作問題:
請使用您自己的/metrics端點列印的指標名稱和單位。 Jitsi 的統計資料參考文件在其支援的統計資料清單中描述了諸如conferences`< metric name="concurrent_counter">` endpoints、bit_rate_download` bit_rate_upload... 和 `< stress_levelmetric name="concurrent_counter">` 之類的範例,但它也提醒您,並非所有統計資料目前都以 Prometheus 格式公開。在確認您的版本中存在 Prometheus 系列之前,請勿將這些名稱貼到查詢中。對於累計計數器,請使用 PromQL 函數,例如 `<metric name=" rate()concurrent_counter">` 或 `<metric name="concurrent_counter">`;對於瞬時指標(例如當前會議計數),請直接繪製採樣值。在標記面板時,請保留文件中記錄的單位,因為位元速率欄位和資料包速率使用不同的單位。
建立一個包含幾個時間序列面板的儀表板,使用清晰的單位,並將時間範圍設定為包含最近抓取的資料。避免將缺少的序列視為零:沒有資料可能表示拼字錯誤、指標不受支援或抓取失敗。對於告警,首先設定目標可用性,然後在觀察到自身部署的正常流量後再添加閾值。統一的「高壓力」閾值可能會產生誤導,因為容量取決於主機、介質組合和配置。
請依照從最簡單到最具體的順序執行以下步驟:
http://127.0.0.1:8080/metrics並確認回應包含指標文字。jitsi-videobridge目標是否正常運行,如果目標已關閉,則檢查其最後一次抓取錯誤。up{job="jitsi-videobridge"}傳回 1,然後查詢從即時端點複製的一個 JVB 指標名稱。如果端點在本機運作正常,但 Prometheus 會報告連線錯誤,請重新檢查綁定位址、連接埠、防火牆和容器網路。如果目標已啟動但 JVB 查詢結果為空,請檢查匯出的確切名稱、所選時間範圍,以及該統計資料是否存在於 Prometheus 輸出中。如果儀表板顯示數據但會議品質仍受到影響,指標有助於縮小調查範圍;但指標本身並不能確定參與者的本地 Wi-Fi、瀏覽器或最後一公里網路問題。
此配置遵循 2026 年 10 月 6 日更新的 Jitsi、Prometheus 和 Grafana 上游文件。由於 Jitsi 的參考配置和 Grafana 的介面會不斷更新,請將範例與您正在使用的確切版本的文件和文件進行比較。
透過檢查視訊圖塊、相機效果、瀏覽器圖形和主機設定來診斷 Jitsi Meet 瀏覽器 CPU 峰值並降低客戶端負載。
使用 Jitsi Videobridge 內建的 Prometheus 端點追蹤其運作狀況、會議負載和流量,然後在 Grafana 中探索和繪製資料圖表。
為 Jitsi Meet Docker 配置自訂網域,包括 DNS、PUBLIC_URL、HTTPS、Let's Encrypt、防火牆連接埠、NAT 設定和端對端驗證。
透過檢查正確的 URL 和連接埠、代理程式路由、服務狀態、已部署的憑證和日誌,修復 SSL 續訂後 Zimbra 管理控制台的 404 錯誤。
透過檢查活動的 PHP SAPI、大小限制、註解和重新驗證設置,了解如何診斷和修復 Nextcloud 的 PHP OPcache 配置警告。
透過檢查備份、伺服器版本、SQL 模式、字元集、模式狀態和日誌,追蹤 MySQL 或 MariaDB 升級後 Kopano 資料庫遷移失敗的問題。
透過安全傳輸、使用者和群組篩選器、登入屬性以及經過測試的部署,將 Nextcloud 連接到 LDAP 或 Active Directory。
透過設定 UnifiedPush、Android 權限、電池設定和可靠的驗證測試,修復已移除 Google 的手機上的 Element Android 通知問題。
使用官方的 occ 指令清除 Nextcloud 的資料庫索引缺少警告。請先備份,預覽更改,執行修復,然後驗證結果。
透過將 OIDC 連接到 Synapse、設定確切的回呼 URL、映射使用者聲明和測試登出來設定 Element Web 的 Keycloak SSO。






