如何安全地清除 Zimbra 稽核日誌以釋放磁碟空間
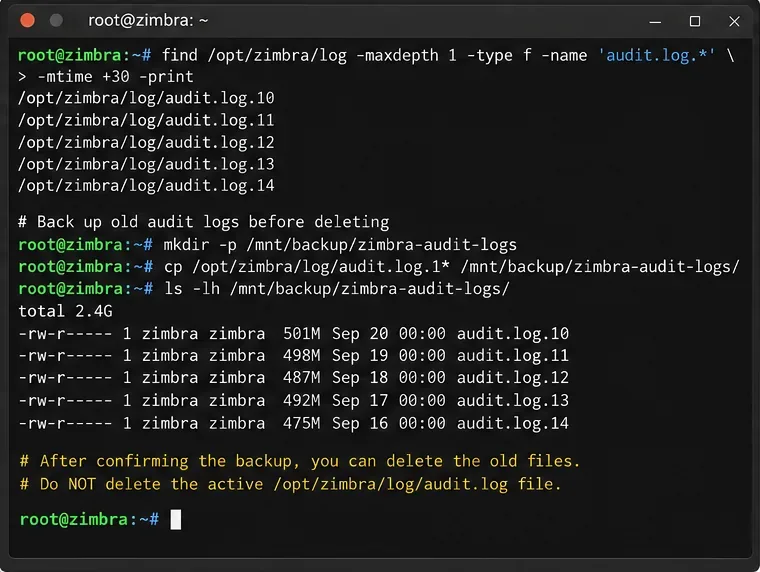
了解如何識別、歸檔、壓縮和刪除舊的 Zimbra 稽核日誌,何時避免截斷 audit.log,以及如何驗證磁碟空間和日誌記錄是否正確復原。
截至 2026 年 10 月 6 日,Matrix Synapse 的最新穩定版本為 1.162.0,發佈於 2026 年 9 月 29 日。如果您的 homeserver 在客戶端同步期間記憶體不足,升級到目前支援的版本是一個明智的初步嘗試,但持久的解決方案通常是透過操作層面的調整,而不是透過某個特定的設定。 Synapse 會有意地將最近的房間資料和元資料保留在記憶體中,以加快常用請求的速度。官方管理員文件警告說,過度減少快取實際上會因為積壓大量慢速請求而加劇記憶體壓力。
本指南將引導新管理員安全地完成以下操作:了解「同步」的含義,確認進程確實達到了記憶體限制,減少不必要的快取壓力,必要時隔離異常大的初始同步流量,並監控結果。目標並非只是縮小駐留資料集的大小,而是在保持主伺服器回應的同時,防止記憶體溢位崩潰。
Matrix 用戶端會重複呼叫用戶端伺服器 API/_matrix/client/v3/sync來接收新事件,例如訊息、房間狀態、帳戶資料、線上狀態資訊和裝置更新。正常的同步過程通常包含一個since令牌,因此 Synapse 只需返回上一次同步點之後的變更。
初始同步有所不同。它是設備或會話的首次同步,沒有先前的since令牌。 Synapse 官方工作流程文件指出,這些請求可能會消耗大量資源。在規模較大的家庭伺服器上,Synapse 支援將初始同步與正在進行的同步分開路由,這樣少數耗費資源的首次同步就不會影響其他使用者的存取。
在進行任何變更之前,請先查閱目前的Synapse 管理員常見問題、設定參考和官方員工指南。您可用的特定選項取決於 Synapse 版本和部署模型。
homeserver.yaml依照正常的備份程序備份工作程序設定檔、反向代理程式設定和 PostgreSQL 資料庫。不要一開始就修改快取值。首先要確定是哪個 Synapse 進程正在消耗內存,以及它是被作業系統終止的還是由於容器限製而被終止的。
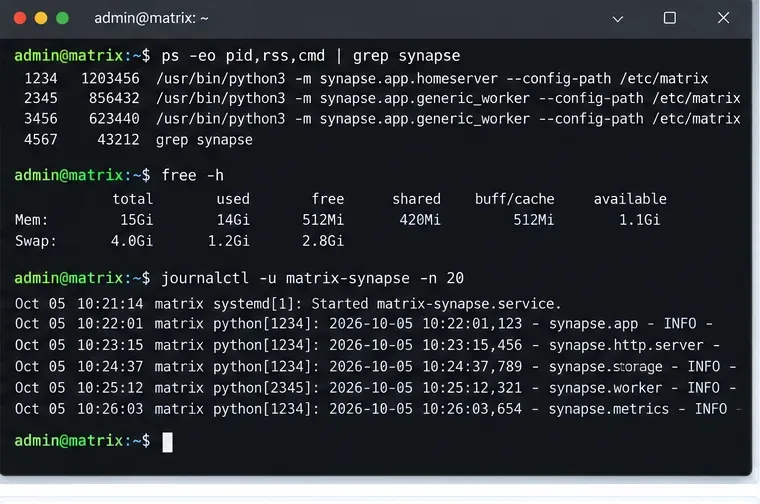
在 Linux 主機上,可以使用以下命令快速查看初始視圖:
ps -eo pid,rss,cmd | grep synapse
free -h
journalctl -u matrix-synapse -n 200
如果您使用 Docker、Podman、Kubernetes 或其他調度器,也請檢查容器或 Pod 的記憶體限制。即使主機有幾 GB 的可用內存,如果 Synapse 進程被限制在較小的 cgroup 內存限制內,仍然可能導致 Synapse 進程終止。
尋找可重複的模式。記憶體佔用是否僅在特定使用者登入新裝置時才會增加?還是全天都在緩慢成長?是否存在某個通用工作進程佔用增加而主進程保持穩定的情況?這些觀察結果有助於區分初始同步峰值與一般快取成長或請求積壓。
Synapse 將資料快取在 RAM 中,這樣就無需重複計算或載入相同的資訊。 Synapse 擁有多個緩存,外加一個事件緩存。配置參考文件目前記錄了以下快取策略:預設值為caches.global_factor0.5,event_cache_size全域因子生效前的預設值為 10K,快取過期時間基於時間,sync_response_cache_duration預設值為 2 分鐘。
一個看似簡單的解決方法是將全域快取因子設定得盡可能低。但切勿盲目地這樣做。 Synapse 管理員常見問題明確警告,快取過小會讓原本就慢的系統變得更慢,導致請求堆積,最終記憶體使用量因積壓而非快取條目而激增。

如果效能分析顯示快取記憶體確實是主要消耗者,且請求吞吐量保持良好,則應嘗試適度減少快取內存,而不是大幅減少。例如:
event_cache_size: 10K

caches:
  global_factor: 0.25
  expire_caches: true
  cache_entry_ttl: 30m
sync_response_cache_duration: 0s這是一個故障排除範例,並非適用於所有伺服器的建議值。將其設為sync_response_cache_duration零會停用已完成/sync回應的快取。當需要保留大量同步回應時,這可以節省內存,但可能會增加重新連接客戶端的工作。請在實際工作負載下進行測試。
Synapse 也提供快取自動調優功能,包括 `--cache-auto-tuning` max_cache_memory_usage、`--cache -auto-tuning`target_cache_memory_usage和 ` --cache-auto-tuning` min_cache_ttl。官方文件指出,此功能需要jemalloc(一種替代記憶體分配器),並且必須提供所有三種設定。請勿僅啟用一個或兩個值;文件警告稱,配置不完整可能會導致系統不穩定。
同步過程中的記憶體問題並非總是由快取資料量過大所引起的。速度慢的資料庫可能會同時處理大量請求,而每個正在進行的請求都會消耗記憶體。這就是為什麼減小快取大小反而會加劇儲存速度慢的問題。
對於生產環境,請遵循Synapse PostgreSQL官方指南。檢查資料庫 CPU 使用率、儲存延遲、連線飽和度、長時間運行的查詢,以及 PostgreSQL 伺服器本身是否正在使用交換空間。如果同步延遲和駐留記憶體同時增加,請在再次減少快取之前調查積壓問題。
如果您最近遷移到了大型公共房間、加入了規模更大的社區,或者添加了許多活躍用戶,那麼工作負載可能已經超過了先前配置的處理能力。在這種情況下,資料庫調優和工作進程隔離通常比減少單一快取的少量負載更為重要。
Synapse 可以作為單一的單體應用程式運行,即只有一個主伺服器進程;也可以將工作拆分成多個工作進程,這些工作進程是共享同一個 PostgreSQL 資料庫的額外 Synapse 進程。工作進程模式適用於需要獨立擴充各個工作負載的大型部署。
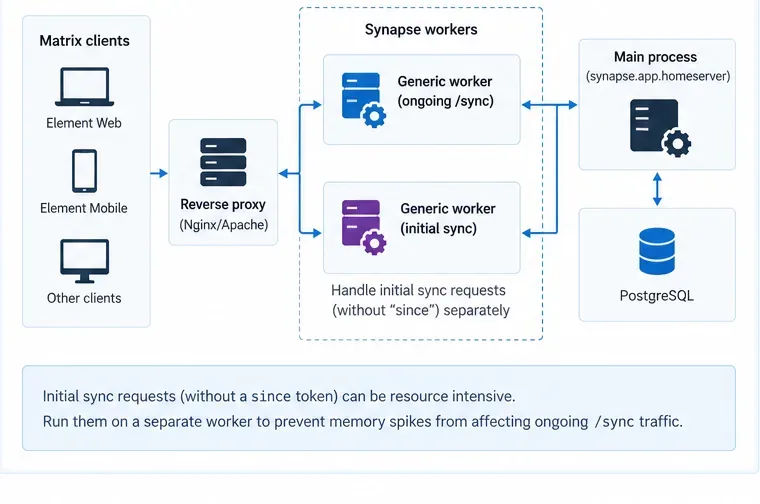
工作進程文件指出,通用工作進程可以處理/sync和/initialSync。它還建議考慮單獨處理不帶since參數的同步請求,因為這些初始同步請求可能會非常消耗資源。
實用型建築設計是:
/sync請求會傳送給一個或多個通用工作進程。請勿將 Synapse 複製監聽器暴露在公共網際網路上。目前工作進程文件警告稱,除非配置了複製金鑰,否則複製流量將未加密且未經身份驗證。
對於小型家用伺服器來說,新增工作節點並非明智之舉。 Synapse 官方指南建議小型執行個體採用單體模式。只有當您確信特定工作負載需要隔離或橫向擴展時,才應考慮新增工作節點。
Synapse 允許重新載入快取因子SIGHUP。配置參考文件給出了以下範例:
kill -HUP PID_OF_SYNAPSE_PROCESS如果打包的 systemd 服務支持,systemctl reload matrix-synapse也可以執行相同的操作。在工作進程部署中,官方文件指出必須更新相關的工作進程配置,且每個工作進程都必須單獨接收重新載入訊號。
每次更改後,都要給伺服器足夠的時間恢復到正常的流量模式。同時觀察駐留記憶體、請求延遲、資料庫負載和活躍工作進程的健康狀況。如果記憶體使用量下降而同步延遲翻倍,則表示修復並不成功。
對於一次性事件之外的任何情況,請啟用 Synapse 指標並使用 Prometheus 收集資料。官方監控指南文件enable_metrics: true和專用的內部指標監聽器都應包含在內。指標端點應保留在內部介面上,或在反向代理上進行保護;不應不必要地暴露該端點。
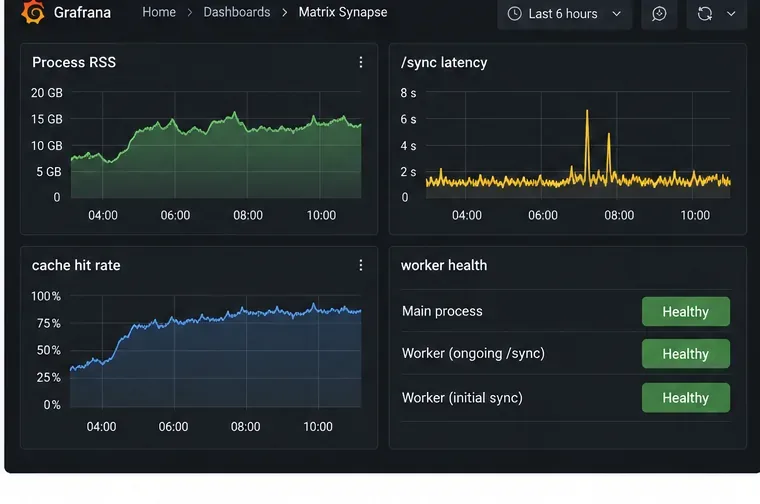
請使用Synapse Prometheus 官方監控指南了解目前的監聽器語法。在工作進程部署中,請單獨監控每個工作進程,因為工作進程的指標不會自動匯總到主進程中。
較小的快取雖然每個條目佔用的記憶體較少,但會增加資料庫和運算工作量。如果這些額外的工作導致未完成的請求排隊,總記憶體佔用反而會增加而不是減少。因此,應逐步減小快取大小,並始終監控延遲。
使用令牌進行的持續同步since和不使用令牌的初始同步具有截然不同的資源佔用情況。在擴展整個伺服器之前,請在診斷過程中將它們區分開來。
Synapse 工作流程共用一個 PostgreSQL 資料庫。工作流程文件指出,SQLite 僅用於演示或測試用途,並非基於工作進程的生產部署的基礎。
少量交換可以防止進程突然終止,但大量交換會顯著降低同步速度,並可能造成相同的積壓回授循環。應將交換視為應對短期流量高峰的保護措施,而不是容量規劃。
如果同時減少快取、更改工作進程路由、修改 PostgreSQL 設定並增加容器限制,您將無法確定是哪項變更解決了問題。因此,請每次只進行一項可控更改,並比較相同的指標。
| 你所觀察到的 | 可能的下一步行動 |
|---|---|
| 當使用者在新裝置上登入時,記憶體使用量會激增。 | 確定初始同步步驟,並考慮在大規模部署中將其隔離在工作進程上。 |
| 記憶體佔用穩定上升,同時快取命中率高,延遲正常。 | 謹慎地降低快取容量並重新測試。 |
| 記憶體延遲和同步延遲同時上升 | 在進一步縮小快取之前,請先調查資料庫或儲存積壓情況。 |
| 只有一名工人達到了極限 | 調整該工作進程的記憶體預算或擴展該工作進程組,而不是擴展整個伺服器。 |
| 主機有空閒內存,但 Synapse 進程被終止了。 | 檢查容器、cgroup、systemd 或 Kubernetes 的記憶體限制。 |
Synapse 刻意追求高記憶體佔用,因為快取是其效能策略的一部分。因此,解決同步相關的記憶體不足 (OOM) 故障的正確方法是找到平衡:移除不必要的快取保留,消除資料庫或要求積壓,並隔離異常工作負載,同時避免影響維持正常同步速度的快取。這種方法比僅僅將最高的 RSS 值視為問題本身要可靠得多。
有關當前版本信息,請參閱Element Synapse 官方版本頁面。
了解如何識別、歸檔、壓縮和刪除舊的 Zimbra 稽核日誌,何時避免截斷 audit.log,以及如何驗證磁碟空間和日誌記錄是否正確復原。
透過檢查伺服器狀態、伺服器套接字、Unix 套接字權限、遠端監聽器和受控交付測試來排查 Kopano dagent 儲存伺服器連線故障。
透過識別事務鎖、將鎖定儲存遷移到 Redis、檢查叢集並安全地重新測試來修復 ownCloud 檔案鎖定逾時錯誤。
透過檢查記憶體壓力、仔細調整快取、隔離初始同步以及監控工作進程來排查 Matrix Synapse 在 /sync 期間的 OOM 問題。
使用主金鑰模式、APCu、Redis 或 Valkey 鎖定,安全地啟用 Nextcloud 伺服器端加密,並採取可最大限度減少效能影響的穩定推廣措施。
透過檢查成員資格、權限等級、目標使用者等級和 Synapse 伺服器管理員復原選項(例如 make_room_admin)來修復 Matrix M_FORBIDDEN 房間管理員錯誤。
Zimbra 網頁信箱接受您的登入要求,但頁面顯示空白?請將瀏覽器問題與郵箱或代理故障區分開來,檢查正確的日誌,並安全地驗證復原方法。
找到 Jitsi Meet 服務卡在重新啟動狀態的問題,讀取致命日誌,並修復常見的 Docker 問題,例如缺少密碼、掛載錯誤和設定不相容等。
了解 Jitsi Meet 帳戶身份驗證與會議室密碼有何不同,配置傳統的安全性網域方法,並安全地驗證存取控制。
修正 ownCloud 後台作業未執行的問題,方法是切換到 Cron 模式並使用 systemd 定時器調度 occ system:cron,然後驗證計時器和日誌。