Wenn ein SUSE Linux-Server beim Neustart mit einer systemd-Shutdown-Meldung hängen bleibt, sollte man nicht zunächst annehmen, dass der Neustartbefehl selbst fehlerhaft ist. In den meisten Fällen wartet systemd auf den Abschluss einer Unit, eines Mounts, eines Prozesses oder eines Shutdown-Hooks. Die sicherste Lösung besteht daher darin, den genauen, noch laufenden Prozess zu identifizieren, die Ursache für sein Nichtbeenden zu untersuchen und diese Komponente zu korrigieren, anstatt die Shutdown-Timeouts global zu verkürzen.
Diese Anleitung verwendet durchgehend ein hypothetisches Beispiel : Ein Server namens „server“ lab-sles01führt SUSE Linux Enterprise Server aus und bleibt beim Neustart mit einer Meldung ähnlich der folgenden hängen A stop job is running for backup.service: [Meldung einfügen]. Das Beispiel dient lediglich der Veranschaulichung der Diagnosemethode; es handelt sich weder um einen Bericht über einen realen Test noch um eine Behauptung, dass eine bestimmte SUSE-Version einen Fehler in einem Dienst namens „server“ aufweist backup.service.
Die Vier-Schritte-Lösung in Kürze
| Schritt | Was zu tun | Was Sie lernen möchten |
|---|
| 1 | Protokollieren Sie die genaue Abschaltmeldung. | Welche Einheit oder Phase blockiert den Fortschritt? |
| 2 | Lesen Sie das vorherige Boot-Protokoll. | Ob der Stopp aufgrund eines Timeouts abgebrochen wurde, ein Unmount-Vorgang fehlgeschlagen ist oder das Herunterfahren einen späteren Zeitpunkt erreicht hat |
| 3 | Überprüfen Sie die Blockierungseinheit und die laufenden Aufträge. | Ob eine Dienstleistung, eine Halterung, ein Inhibitor oder eine Abhängigkeit verantwortlich ist |
| 4 | Beheben Sie die Ursache und testen Sie erneut. | Ob ein normaler Vorgang systemctl rebootnun ohne Verzögerung abgeschlossen wird |
Schritt 1: Genau protokollieren, wo das Herunterfahren stoppt
Beobachten Sie während eines geplanten Neustarts die lokale Konsole, die Konsole der virtuellen Maschine, die BMC/IPMI-Konsole oder die Hypervisor-Konsole. Eine Zeile mit dem Namen einer Einheit ist wesentlich aussagekräftiger als eine allgemeine Beschreibung wie „systemd ist eingefroren“. lab-sles01Angenommen, die Konsole zeigt an, dass backup.servicesystemd noch im Stoppvorgang ist, während andere Einheiten bereits heruntergefahren wurden.
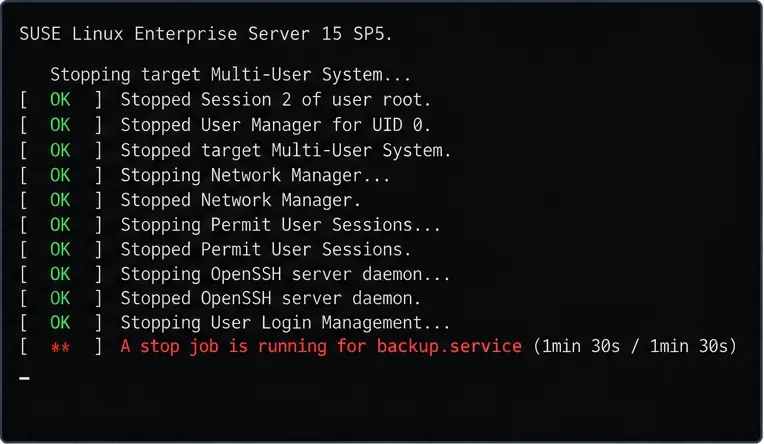
Beispiel zur Veranschaulichung: Die Shutdown-Konsole identifiziert backup.servicedie Unit, auf die systemd noch wartet.
Wird in der Konsole stattdessen eine .mountEinheit, ein Netzwerkdateisystem, ein Gerät oder ein anderer Dienst genannt, sollte dieser Name verwendet werden, anstatt ein allgemeines Dienst-Timeout anzuwenden. Die unten in der Konsole angezeigte Einheit ist ein Hinweis, aber nicht automatisch die Ursache: Sie kann selbst auf einen untergeordneten Prozess, Speicher, Netzwerk-E/A oder eine andere Abhängigkeit warten.
Die aktuelle systemd-Anleitung von SUSE weist darauf hin, dass ein langer Neustart oder Stromausfall durch einen nicht beendeten Dienst verursacht werden kann und empfiehlt, die systemd-Jobs zu überprüfen. Siehe SUSE Linux Enterprise Server 16.0: Einführung in die Grundlagen von systemd .
Schritt 2: Verwenden Sie das vorherige Boot-Journal, nachdem der Server zurückgekehrt ist
Überprüfen Sie nach dem Neustart des Rechners den soeben erfolgten Shutdown. SUSE protokolliert die Boot-Offsets im Journal: „boot“ 0ist der aktuelle Bootvorgang, „ -1is“ der vorherige usw. Beginnen Sie mit:
sudo journalctl --list-boots
sudo journalctl -b -1
Bei einer großen Zeitschrift kann die umgekehrte Reihenfolge die letzten Beiträge schneller sichtbar machen:
sudo journalctl -b -1 -r

Beispiel zur Veranschaulichung: Das Protokoll des vorherigen Systemstarts zeigt, dass der hypothetische Backup-Dienst SIGTERM empfängt und später eine Zeitüberschreitung auftritt.
Suchen Sie nach Formulierungen wie Stopping„“ stop job, timed out„“, „“ Failed with result, „“, „ Unmounting“, Dependency failed„“ oder nach Meldungen des verdächtigen Dienstes selbst. Sobald Sie den Namen der Einheit kennen, können Sie die Suche eingrenzen:
sudo journalctl -b -1 -u backup.service
SUSE beschreibt journalctl -b -1die Analyse des vorherigen Systemstarts in seiner Journaldokumentation zu SLES 15 SP7 . Falls journalctl --list-bootsdiese keine Informationen zum vorherigen Systemstart enthält, sollten Sie keine voreiligen Schlüsse aus der fehlenden Historie ziehen. Überprüfen Sie stattdessen die Konfiguration des journald-Speichers und verwenden Sie für die nächste Reproduktion die Konsolen- oder Remote-Protokollierung.
Schritt 3: Ermitteln Sie, ob es sich bei dem Blockierer um einen Dienst, eine Bereitstellung, einen Inhibitor oder einen späten Herunterfahr-Hook handelt.
Wenn Sie das Problem während eines Wartungsfensters reproduzieren können, halten Sie eine zweite Administrationskonsole bereit. Führen Sie vor dem Verbindungsabbruch folgenden Befehl aus:
sudo systemctl list-jobs
sudo systemctl status backup.service
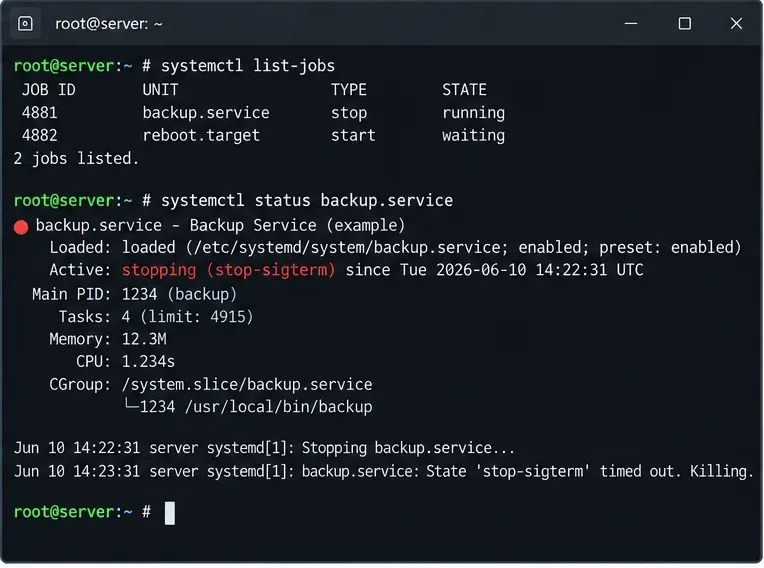
Beispiel zur Veranschaulichung: backup.serviceEin Stopp-Job läuft, während das Neustart-Ziel darauf wartet, ausgeführt zu werden.
Die systemd-Debugging-Anleitung erklärt, dass Prozesse, die als „“ angezeigt werden, runningabgeschlossen sein müssen, bevor abhängige Prozesse, die als „“ angezeigt werden, waitingfortgesetzt werden können. SUSE empfiehlt dies auch systemctl list-jobs, wenn das Herunterfahren oder der Neustart zu lange dauert. Daher ist dieser Befehl besonders nützlich, wenn der Server nicht vollständig eingefroren ist und Prozess-ID 1 (PID 1) noch reagiert.
Wenn ein Dienst zu langsam stoppt
Überprüfen Sie die Unit-Definition und ihr Abschaltverhalten:
sudo systemctl cat backup.service
sudo systemctl status backup.service
sudo journalctl -u backup.service -b
Prüfen Sie, ob der Dienst eine ExecStop=Aktion ausführt, ob sein Prozess SIGTERM-Signale verarbeitet und ob er auf Speicher- oder Netzwerkressourcen wartet. Ein Datenbank-, Backup- oder Middleware-Dienst benötigt unter Umständen Zeit, um Daten zu speichern. Ihn vorzeitig zu beenden, behebt das Problem daher nicht automatisch.
Wenn ein Mount oder ein Netzwerkdateisystem beteiligt ist
Suchen Sie nach fehlgeschlagenen Aushängevorgängen und identifizieren Sie die Einhängequelle:
findmnt
systemctl list-units --type=mount
sudo journalctl -b -1 | grep -Ei 'unmount|umount|mount|nfs|cifs'
Bei NFS oder CIFS sollten Sie die Servererreichbarkeit, veraltete Sitzungen und die Einhaltung der Server-Herunterfahranforderungen durch die Mount-Optionen prüfen. Falls die blockierte Einheit von einer anderen Quelle stammt /etc/fstab, korrigieren Sie die Mount-Konfiguration, anstatt ein dienstspezifisches Timeout auf eine nicht zugehörige Einheit anzuwenden.
Wenn die Neustartanforderung unterdrückt wird
Vor dem Herunterfahren können Sie die aktiven Systemd-Inhibitoren auflisten:
systemd-inhibit --list
Inhibitor-Sperren können Herunterfahranforderungen blockieren oder verzögern, während eine Anwendung Aufgaben ausführt, die nicht unterbrochen werden sollten. Sie sind besonders relevant, wenn die Neustartanforderung selbst verzögert wird, bevor das System in die endgültige Herunterfahrsequenz eingetreten ist. Siehe das Handbuch zu systemd-inhibit .
Wenn der Hänger auftritt, nachdem die Dienste bereits ausgefallen sind
Ein später auftretender Hänger erfordert eine gesonderte Untersuchung. systemd führt /usr/lib/systemd/system-shutdown/kurz vor dem endgültigen Neustart oder Herunterfahren ausführbare Dateien aus und wartet deren Beendigung. Wenn Journal und Konsole anzeigen, dass reguläre Dienste bereits beendet sind und der Hänger erst beim endgültigen Herunterfahren auftritt, überprüfen Sie dieses Verzeichnis und alle vom Hersteller installierten Hooks. Die Dokumentation des systemd-Shutdown-Dienstes beschreibt dieses Verhalten.
Schritt 4: Reparieren Sie die Komponente und testen Sie anschließend einen normalen Neustart.
Kehren wir zum hypothetischen Fall zurück lab-sles01. Angenommen, die Protokolle zeigen, dass backup.serviceder Dienst die normale Beendigung ignoriert, nachdem sein Sicherungsprozess bereits abgeschlossen ist. Die erste Möglichkeit besteht darin, den Dienst oder seinen Stoppbefehl zu korrigieren. Wenn bekannt ist, dass der Dienst nach einer begrenzten Zeitspanne sicher beendet werden kann, kann eine systemd-Überschreibung pro Einheit die Wartezeit von systemd begrenzen.
Erstellen Sie eine Überschreibung, anstatt eine Lieferanteneinheit zu bearbeiten unter /usr/lib/systemd/system:
sudo systemctl edit backup.service
Zum Beispiel:
[Service]
TimeoutStopSec=30s
Laden Sie anschließend die Unit-Konfiguration von systemd neu:
sudo systemctl daemon-reload
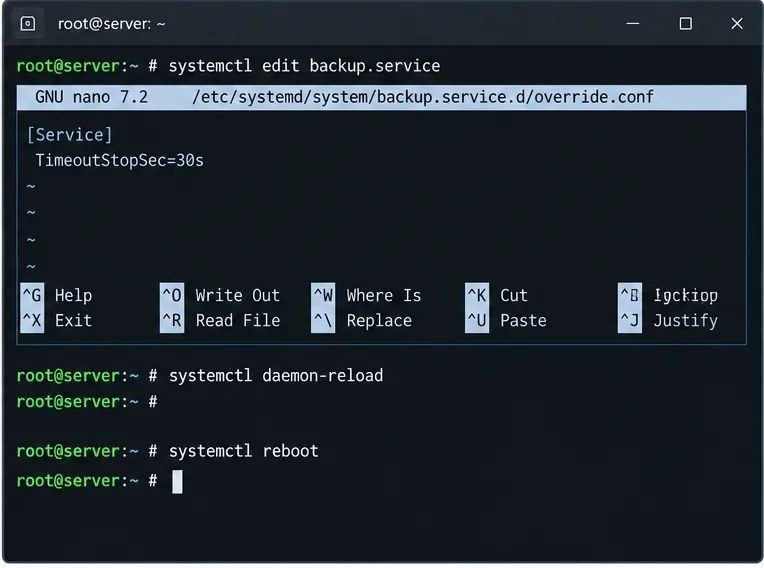
Beispiel zur Veranschaulichung: Ein Timeout pro Dienst wird erst dann angewendet, wenn der hypothetische Dienst als Blockierer identifiziert wurde.
Übernehmen Sie den Wert von 30 Sekunden nicht einfach unreflektiert. Das richtige Timeout hängt davon ab, welche Prozesse der jeweilige Dienst sicher abschließen muss. Eine Verkürzung des Timeouts für Datenbanken, Speicherdienste, Cluster-Dienste oder Backup-Prozesse kann die ordnungsgemäße Bereinigung beeinträchtigen. Ein Timeout dient als Schutzmechanismus und ersetzt nicht die Behebung eines Fehlers ExecStop=oder einer Anwendung, die nicht ordnungsgemäß beendet wird.
Wenn Sie mit der Änderung zufrieden sind, testen Sie einen normalen Neustart:
sudo systemctl reboot
Nachdem das Gerät wieder läuft, überprüfen Sie den vorherigen Startvorgang erneut und vergewissern Sie sich, dass das Gerät sauber gestoppt wurde und nicht einfach von der Konsole verschwunden ist.
Wann sollte man einen erzwungenen Neustart durchführen?
Ein erzwungener Neustart ist eine Wiederherstellungsoption, keine Strategie zur Fehlerbehebung. Die systemd-Dokumentation besagt, dass ein Neustart zwar das normale Herunterfahren des Dienstes --forceüberspringt systemctl reboot, aber dennoch Prozesse beendet und versucht, Dateisysteme schreibgeschützt auszuhängen oder wieder einzuhängen. Die --forcezweimalige Angabe des Befehls ist gefährlicher, da ein Neustart erfolgen kann, ohne Prozesse zu beenden oder Dateisysteme auszuhängen, was zu Datenverlust führen kann.
Wenn der Server bereits blockiert ist und es keine sicherere Möglichkeit gibt, den Betrieb wiederherzustellen, kann ein erzwungener Neustart gemäß Ihren Betriebsabläufen gerechtfertigt sein:
sudo systemctl reboot --force
Behandeln Sie systemctl reboot --force --forceeinen virtuellen Neustart oder einen physischen Neustart nicht als normale Lösung. Solche Aktionen können die benötigten Beweise entfernen und laufende Schreibvorgänge gefährden. Die Dokumentation von systemctl unterscheidet explizit zwischen dem einfachen und dem doppelten erzwungenen Verhalten.
Was passiert, wenn jeder Neustart zum Absturz führt und eine Fehlerbehebung im normalen Modus nicht möglich ist?
Verwenden Sie eine Wartungskonsole und starten Sie im Rettungsmodus. SUSE dokumentiert das Hinzufügen systemd.unit=rescue.targetvon Befehlen zur Kernel-Befehlszeile über den GRUB-Editor. Der Rettungsmodus stellt eine Root-Sitzung mit lokalen Dateisystemen und Kerndiensten bereit, während die Netzwerkverbindung deaktiviert bleibt. Dies kann Ihnen helfen, den fehlerhaften Dienst oder die fehlerhafte Mount-Konfiguration zu deaktivieren oder zu reparieren.
Die offizielle Vorgehensweise im Rettungsmodus finden Sie im SLES 15 SP7-Administrationshandbuch . Bei Systemen, bei denen das Problem erst nach einer bestimmten Paket-, Kernel-, Treiber- oder Speicheränderung auftritt, sollten Sie außerdem die entsprechende SUSE-Wartungshistorie überprüfen, bevor Sie dauerhafte Timeout-Änderungen vornehmen.
Schnellentscheidungstabelle
| Was Sie sehen | Wahrscheinlicher Inspektionsbereich | Beste nächste Maßnahme |
|---|
A stop job is running for xyz.service | Pfad zum Herunterfahren des Dienstes | Prüfen Sie systemctl statusdie Gerätedatei und das Servicejournal. |
| Wiederholte Meldungen zum Aushängen oder zum Remote-Dateisystem | Mount, NFS, CIFS, Speicher | Überprüfen Sie findmntdie Mount-Einheiten /etc/fstabund die Servererreichbarkeit. |
| Neustartanforderung wird abgelehnt oder vor dem Herunterfahren verzögert. | Inhibitor oder eine andere systemd-Aufgabe | Lauf systemd-inhibit --listundsystemctl list-jobs |
| Die Dienste werden gestoppt, aber die endgültige Abschaltung wird nie abgeschlossen. | Späte Abschaltvorrichtung, Kernel, Treiber, Speicher | Überprüfen Sie das Protokoll des vorherigen Systemstarts und/usr/lib/systemd/system-shutdown/ |
| Ein normaler Stiefel macht eine Reparatur unmöglich | Persistenter Konfigurations- oder Geräteausfall | Booten mitsystemd.unit=rescue.target |
Fazit
Wenn ein SUSE Linux-Server beim Herunterfahren von systemd hängen bleibt, besteht die dauerhafte Lösung darin, den Prozess zu identifizieren, auf den systemd wartet, und die entsprechende Unit oder deren Abhängigkeit zu korrigieren. Protokollieren Sie die Herunterfahrmeldung, untersuchen Sie die Systemd-Konfiguration und journalctl -b -1verwenden Sie die entsprechenden Befehle, um die blockierende Komponente zu isolieren. Ändern Sie erst dann die Timeout- oder Mount-Konfiguration einzelner Dienste. Verwenden Sie Methoden zum erzwungenen Neustart nur für Wiederherstellungssituationen und nicht für den regulären Betrieb.systemctl list-jobssystemctl status



