Inicio
» ADMINISTRADOR DE RED
»
Cómo solucionar el problema de falta de memoria en Matrix Synapse durante la sincronización
Cómo solucionar el problema de falta de memoria en Matrix Synapse durante la sincronización
A fecha de 6 de octubre de 2026, la última versión estable de Matrix Synapse es la 1.162.0, publicada el 29 de septiembre de 2026. Si su servidor doméstico se queda sin memoria durante la sincronización de clientes, actualizar a una versión compatible actual es una primera comprobación sensata, pero la solución definitiva suele ser operativa, no una configuración mágica. Synapse mantiene intencionadamente en memoria los datos y metadatos recientes de las salas para agilizar las solicitudes comunes, y la documentación oficial del administrador advierte de que reducir las cachés de forma demasiado agresiva puede empeorar la presión sobre la memoria al crear una acumulación de solicitudes lentas.
Esta guía describe el proceso que un administrador principiante puede seguir con seguridad: comprender qué significa "sincronizar", confirmar que el proceso realmente alcanza el límite de memoria, reducir la presión innecesaria sobre la caché, separar el tráfico de sincronización inicial inusualmente intenso cuando sea necesario y supervisar el resultado. El objetivo no es simplemente reducir el tamaño del conjunto residente, sino evitar fallos por falta de memoria y, al mismo tiempo, mantener la capacidad de respuesta del servidor principal.
Qué significa “sincronización” en Matrix Synapse
Un cliente de Matrix llama repetidamente a la API Cliente-Servidor /_matrix/client/v3/syncpara recibir nuevos eventos, como mensajes, estado de la sala, datos de la cuenta, información de presencia y actualizaciones de dispositivos. Una sincronización continua normal suele incluir un sincetoken, por lo que Synapse solo necesita devolver los cambios posteriores al punto de sincronización anterior.
La sincronización inicial es diferente. Se trata de la primera sincronización de un dispositivo o sesión y no cuenta con un sincetoken previo. La documentación oficial de Synapse describe estas solicitudes como potencialmente muy intensivas en recursos. En servidores domésticos de mayor tamaño, Synapse permite enrutar la sincronización inicial por separado de la sincronización continua, de modo que unas pocas sincronizaciones iniciales costosas no afecten al resto del sistema.
Anota tu versión de Synapse y el método de instalación.
Realice una copia de seguridad homeserver.yamlde los archivos de configuración del trabajador, la configuración del proxy inverso y la base de datos PostgreSQL según su procedimiento de copia de seguridad habitual.
Indique si Synapse se ejecuta como un único proceso, en contenedores o como un proceso principal más procesos secundarios.
Averigüe el límite de memoria real. Un contenedor, una unidad systemd, un pod de Kubernetes o una máquina virtual pueden tener un límite inferior al del servidor físico.
Confirme que PostgreSQL se está utilizando en producción. La documentación de instalación actual de Synapse indica que SQLite es para pruebas y que su rendimiento es deficiente en cargas de trabajo de producción, especialmente en entornos con gran cantidad de equipos.
Paso 1: Confirmar que el agotamiento de la memoria es el verdadero fallo.
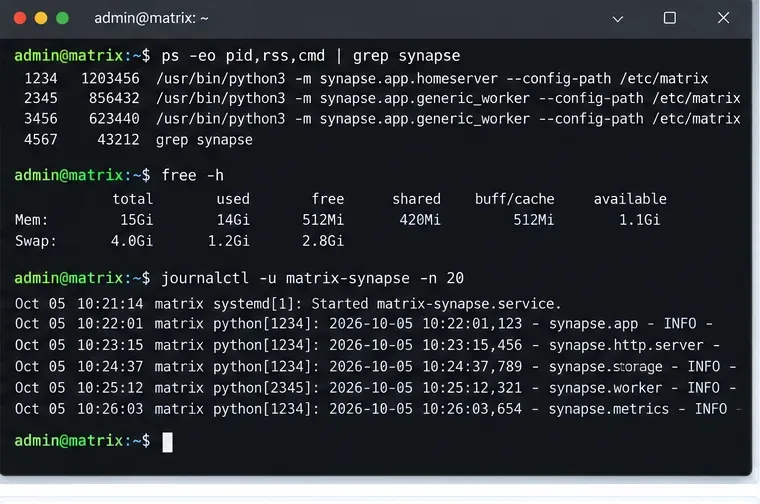
No empiece por modificar los valores de la caché. Primero, identifique qué proceso de Synapse está consumiendo memoria y si el sistema operativo lo está finalizando o si se debe a un límite del contenedor.
Comience con el RSS del proceso, la memoria disponible, la presión de intercambio y los registros recientes del servicio Synapse para saber si el problema es un verdadero agotamiento de la memoria o una falla de sincronización diferente.
En un sistema Linux, comandos como los siguientes proporcionan una primera impresión rápida:
Si utiliza Docker, Podman, Kubernetes u otro planificador, revise también el límite de memoria del contenedor o pod. Un host con varios gigabytes libres aún puede detener Synapse si el proceso está restringido a un límite de cgroup mucho menor.
Busque un patrón repetible. ¿Aumenta el uso de memoria solo cuando un usuario específico inicia sesión en un nuevo dispositivo? ¿O aumenta gradualmente durante todo el día? ¿Aumenta el uso de memoria de un proceso genérico mientras el proceso principal se mantiene estable? Estas observaciones permiten distinguir un pico de sincronización inicial del crecimiento general de la caché o de la acumulación de solicitudes.
Paso 2: Compruebe la configuración de la caché antes de reducirla.
La caché almacena datos en la memoria RAM de Synapse para evitar tener que recalcular o recargar la misma información repetidamente. Synapse cuenta con varias cachés, además de una caché de eventos. La documentación de configuración actual establece un valor predeterminado caches.global_factorde 0,5, un event_cache_sizevalor predeterminado de 10 KB antes de aplicar el factor global, una caducidad de caché basada en el tiempo y un sync_response_cache_durationvalor predeterminado de 2 minutos.
La solución tentadora es establecer el factor global al valor más bajo posible. No lo haga a ciegas. Las preguntas frecuentes del administrador de Synapse advierten explícitamente que una caché demasiado pequeña puede ralentizar aún más un sistema lento, permitiendo que las solicitudes se acumulen y provocando un aumento desmesurado del uso de memoria debido a la cola de solicitudes pendientes en lugar de a las entradas de la caché.
Realice cambios en la caché con cautela y mida el resultado; el ejemplo ilustra dónde se encuentran las configuraciones relevantes, en lugar de un valor de producción universal.
Si el análisis de rendimiento muestra que la memoria caché es realmente el principal consumidor y el rendimiento de las solicitudes se mantiene estable, intente una reducción moderada en lugar de una drástica. Por ejemplo:
Este es un ejemplo para solucionar problemas, no un valor recomendado para todos los servidores. Si se establece sync_response_cache_durationen cero, se desactiva el almacenamiento en caché de /synclas respuestas completadas. Esto puede ahorrar memoria cuando se retienen muchas respuestas de sincronización, pero puede aumentar el trabajo de los clientes que se reconectan. Pruébelo con su carga de trabajo real.
Synapse también proporciona autoajuste de caché con max_cache_memory_usage, target_cache_memory_usage, y min_cache_ttl. La documentación oficial indica que esta función requiere jemalloc , un asignador de memoria alternativo, y que se deben proporcionar las tres configuraciones. No habilite solo uno o dos valores; la documentación advierte que una configuración incompleta puede provocar un comportamiento inestable.
Paso 3: Asegúrese de que la base de datos no esté creando una lista de espera de solicitudes.
Los problemas de memoria durante la sincronización no siempre se deben a la cantidad de datos en caché. Una base de datos lenta puede mantener muchas solicitudes activas simultáneamente, y cada solicitud en curso consume memoria. Por eso, reducir el tamaño de la caché puede ser contraproducente en un sistema de almacenamiento que ya es lento.
Para entornos de producción, siga la guía oficial de Synapse PostgreSQL . Verifique el uso de CPU de la base de datos, la latencia de almacenamiento, la saturación de la conexión, las consultas de larga duración y si el propio servidor PostgreSQL está utilizando la memoria virtual (swap). Si la latencia de sincronización aumenta al mismo tiempo que la memoria residente, investigue la acumulación de datos pendientes antes de volver a reducir las cachés.
Si recientemente se mudó a salas públicas grandes, se integró a comunidades mucho más grandes o agregó muchos usuarios activos, es posible que la carga de trabajo simplemente haya superado la capacidad de una configuración que antes funcionaba. En ese caso, la optimización de la base de datos y el aislamiento de los procesos suelen ser más importantes que reducir ligeramente el uso de una caché.
Paso 4: Aislar la sincronización inicial en servidores domésticos más grandes.
Synapse puede ejecutarse como un único proceso monolítico , es decir, un único proceso principal en el servidor, o bien puede dividir la carga de trabajo en procesos secundarios , que son procesos adicionales de Synapse que comparten la misma base de datos PostgreSQL. El modelo de procesos secundarios está pensado para instalaciones de mayor tamaño que necesitan escalar las cargas de trabajo individuales de forma independiente.
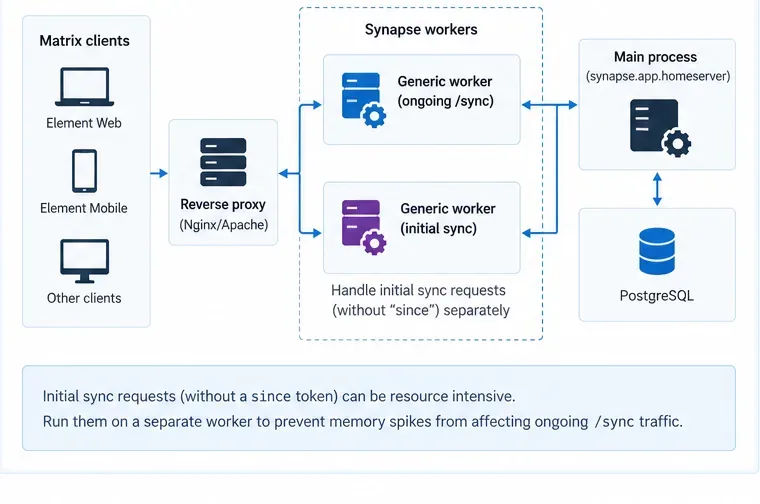
En implementaciones de mayor tamaño basadas en PostgreSQL, se recomienda enrutar la costosa sincronización inicial por separado de la sincronización continua, de modo que el primer inicio de sesión no consuma el mismo grupo de procesos que las actualizaciones normales de los clientes.
La documentación del trabajador indica que un trabajador genérico puede manejar /syncy /initialSync. También recomienda considerar un manejo separado para las solicitudes de sincronización sin un sinceparámetro porque estas solicitudes de sincronización inicial pueden consumir muchos recursos.
Una arquitectura práctica es:
El proxy inverso recibe el tráfico de los clientes de Matrix.
Las solicitudes en curso /syncse dirigen a uno o más trabajadores genéricos.
Las solicitudes de sincronización iniciales se envían a un grupo de trabajadores genéricos independiente.
El proceso principal continúa gestionando las responsabilidades que no han sido delegadas.
Todos los procesos de Synapse comparten PostgreSQL.
No exponga el receptor de replicación de Synapse a Internet. La documentación actual del proceso advierte que el tráfico de replicación no está cifrado ni autenticado a menos que se configure una clave secreta de replicación.
Agregar workers no es la mejor opción para un servidor doméstico pequeño. La propia guía de Synapse recomienda el modo monolítico para instancias pequeñas. Agregue workers cuando tenga evidencia de que una carga de trabajo específica requiere aislamiento o escalado horizontal.
Paso 5: Recargue los factores de caché de forma segura y observe el resultado.
Synapse permite recargar los factores de caché con SIGHUP. La referencia de configuración proporciona este ejemplo:
kill -HUP PID_OF_SYNAPSE_PROCESS
Si el servicio systemd incluido lo admite, systemctl reload matrix-synapsepuede realizar la misma operación. En una implementación de trabajadores, la documentación oficial indica que se debe actualizar la configuración del trabajador correspondiente y que cada trabajador debe recibir la señal de recarga individualmente.
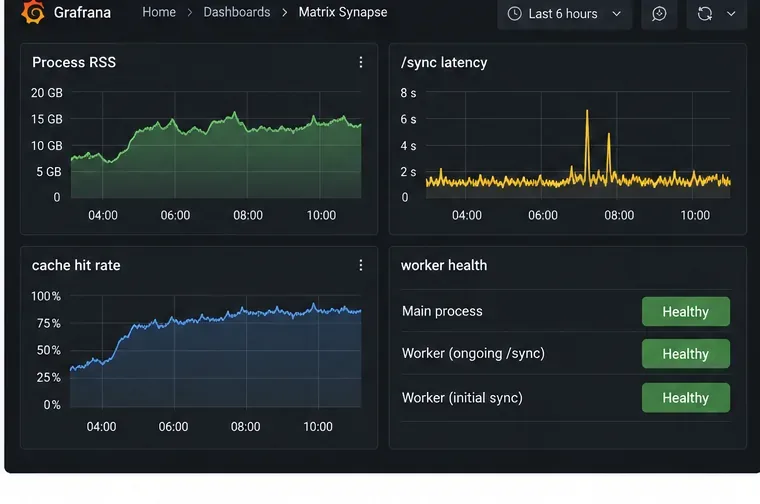
Tras cada cambio, deje que el servidor tenga tiempo suficiente para estabilizar su tráfico. Monitoree simultáneamente la memoria residente, la latencia de las solicitudes, la carga de la base de datos y el estado de los procesos activos. Un gráfico de memoria que disminuye mientras la latencia de sincronización se duplica no indica una solución exitosa.
Paso 6: Habilitar las métricas de Prometheus para un diagnóstico repetible.
Para cualquier incidente que vaya más allá de un caso aislado, active las métricas de Synapse y recopílelas con Prometheus. La guía oficial de monitorización documenta enable_metrics: trueun receptor de métricas interno dedicado. Mantenga el punto final de métricas en una interfaz interna o protéjalo en el proxy inverso; no debe exponerse innecesariamente.
Monitorea la memoria y sincroniza la latencia simultáneamente. El resultado útil es una memoria estable con un tiempo de respuesta aceptable, no el valor RSS más bajo posible.
Para conocer la sintaxis actual del listener , consulte la guía oficial de monitorización de Synapse Prometheus . En las implementaciones de trabajadores, supervise cada trabajador por separado, ya que las métricas de los trabajadores no se agregan automáticamente al proceso principal.
Errores comunes que se deben evitar
Disminuir SYNAPSE_CACHE_FACTOR hasta que el servidor se vuelva más lento.
Una caché más pequeña consume menos memoria por entrada, pero aumenta la carga de trabajo de la base de datos y los cálculos. Si este trabajo adicional genera una cola de solicitudes incompletas, el consumo total de memoria puede aumentar en lugar de disminuir. Reduzca este factor gradualmente y supervise siempre la latencia.
Suponiendo que cada solicitud /sync cuesta lo mismo
Una sincronización continua con un sincetoken y una sincronización inicial sin él tienen perfiles de recursos muy diferentes. Sepárelos en su diagnóstico antes de escalar todo el servidor.
Utilizar trabajadores mientras aún se usa SQLite
Los nodos de Synapse comparten una base de datos PostgreSQL. La documentación del nodo indica que SQLite es para uso de demostración o prueba y no es la base para una implementación de producción basada en nodos.
Utilizar el intercambio como solución principal
Una pequeña cantidad de intercambio de memoria puede evitar la interrupción abrupta de un proceso, pero un intercambio excesivo ralentiza drásticamente la sincronización y puede generar el mismo ciclo de retroalimentación de retrasos. Considere el intercambio de memoria como una protección contra picos puntuales, no como una planificación de capacidad.
Cambiar varias configuraciones de memoria a la vez
Si reduces simultáneamente las cachés, modificas el enrutamiento de los procesos, cambias la configuración de PostgreSQL y aumentas el límite de contenedores, no sabrás qué cambio solucionó el problema. Realiza un cambio controlado a la vez y compara las mismas métricas.
Un camino práctico para la toma de decisiones
Lo que observas
Posible próxima acción
El consumo de memoria aumenta cuando los usuarios inician sesión en dispositivos nuevos.
Identifique la sincronización inicial y considere aislarla en un proceso de trabajo para implementaciones de mayor envergadura.
La memoria aumenta de forma constante mientras que la tasa de aciertos de la caché es alta y la latencia es normal.
Reduzca la capacidad de la caché de forma conservadora y vuelva a realizar la prueba.
La latencia de memoria y de sincronización aumenta simultáneamente.
Investigue la acumulación de solicitudes en la base de datos o en el almacenamiento antes de reducir aún más las cachés.
Solo un trabajador alcanza su límite
Ajuste el presupuesto de memoria de ese trabajador o aumente el tamaño de ese grupo de trabajadores en lugar de todo el servidor principal.
El host tiene RAM libre pero Synapse está detenido.
Inspeccione los límites de memoria de contenedores, cgroups, systemd o Kubernetes.
Lista de verificación final
Utilice una versión de Synapse compatible vigente; la versión 1.162.0 es la última versión estable a fecha de 6 de octubre de 2026.
Utilice PostgreSQL para producción.
Confirma qué proceso está consumiendo realmente RSS y qué límite de memoria se le aplica.
Distinga la sincronización incremental normal de la sincronización inicial.
Mantén habilitada la caducidad de la caché y ajusta los factores de caché gradualmente.
No habilite el ajuste automático de caché a menos que se esté utilizando jemalloc y se hayan configurado todos los valores necesarios.
Para implementaciones de mayor envergadura, aísle la sincronización inicial o añada trabajadores de sincronización genéricos cuando las mediciones lo justifiquen.
Tras cada cambio, supervise la memoria y la latencia simultáneamente.
Synapse consume mucha memoria deliberadamente porque el almacenamiento en caché forma parte de su estrategia de rendimiento. Por lo tanto, la solución correcta para los fallos de memoria insuficiente relacionados con la sincronización reside en un equilibrio: eliminar la retención innecesaria de caché, eliminar la acumulación de solicitudes o de la base de datos, y aislar las cargas de trabajo excepcionales sin agotar las cachés que mantienen la sincronización normal rápida. Este enfoque es más fiable que considerar el valor RSS más alto como el único problema.