Si un servidor SUSE Linux parece quedarse bloqueado durante el reinicio al recibir un mensaje de apagado de systemd, la primera suposición más útil no es que el comando de reinicio esté defectuoso. En la mayoría de los casos, systemd está esperando a que finalice una unidad, un montaje, un proceso o un gancho de apagado. Por lo tanto, la solución más segura consiste en identificar la tarea exacta que aún se está ejecutando, analizar por qué no se detiene y corregir ese componente en lugar de reducir globalmente los tiempos de espera de apagado.
Esta guía utiliza un ejemplo hipotético : un servidor llamado lab-sles01ejecuta SUSE Linux Enterprise Server y se detiene durante el reinicio con un mensaje similar a A stop job is running for backup.service. El ejemplo es solo una ilustración del método de diagnóstico; no es un informe de una prueba real ni una afirmación de que una versión particular de SUSE tenga un defecto en un servicio llamado backup.service.
La solución en cuatro pasos, en resumen.
| Paso | ¿Qué hacer? | Lo que estás intentando aprender |
|---|
| 1 | Registre el mensaje de apagado exacto. | ¿Qué unidad o etapa está bloqueando el progreso? |
| 2 | Revisa el diario de arranque anterior | Ya sea que la parada haya expirado, que haya fallado el desmontaje o que el apagado haya llegado a una etapa posterior. |
| 3 | Inspeccione la unidad de bloqueo y los trabajos en vivo. | Ya sea que un servicio, un soporte, un inhibidor o una dependencia sean los responsables |
| 4 | Solucione la causa raíz y vuelva a realizar la prueba. | Si una normalidad systemctl rebootahora se completa sin demora |
Paso 1: Registre exactamente dónde se detiene el apagado.
Observe la consola local, la consola de la máquina virtual, la consola BMC/IPMI o la consola del hipervisor durante un reinicio programado. Una línea que nombre una unidad es mucho más útil que una descripción general como "systemd se congeló". Para el caso hipotético lab-sles01, supongamos que la consola muestra que backup.serviceaún se está deteniendo mientras que otras unidades ya se han apagado.
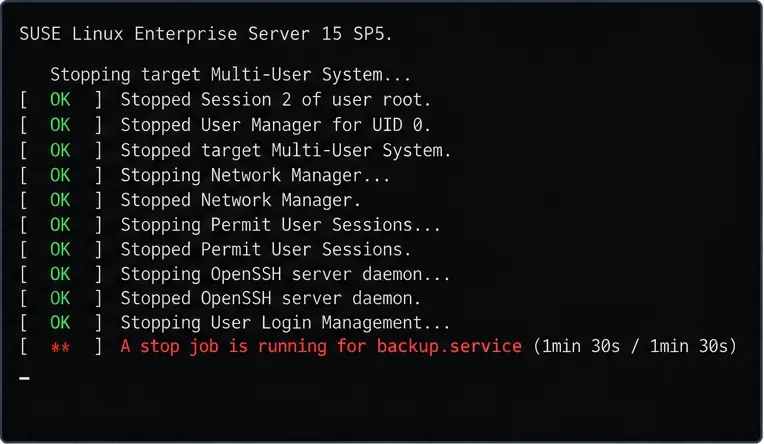
Ejemplo ilustrativo: la consola de apagado identifica backup.servicecomo la unidad que systemd todavía está esperando.
Si la consola nombra una .mountunidad, un sistema de archivos de red, un dispositivo u otro servicio, siga ese nombre en lugar de aplicar un tiempo de espera genérico para el servicio. La unidad que se muestra en la parte inferior de la consola es una pista, no necesariamente la causa raíz: podría estar esperando a un proceso hijo, almacenamiento, E/S de red u otra dependencia.
La guía actual de systemd de SUSE indica que un reinicio prolongado o un apagado puede deberse a un servicio que no finaliza y recomienda revisar los trabajos de systemd. Consulte SUSE Linux Enterprise Server 16.0: Introducción a los conceptos básicos de systemd .
Paso 2: Utilice el registro de arranque anterior después de que el servidor regrese.
Después de que la máquina vuelva a arrancar, inspeccione el apagado que acaba de ocurrir. SUSE documenta los desplazamientos de arranque en el registro: boot 0es el arranque actual, -1es el arranque anterior, y así sucesivamente. Comience con:
sudo journalctl --list-boots
sudo journalctl -b -1
Para una revista extensa, el orden inverso puede hacer que los últimos mensajes aparezcan más rápidamente:
sudo journalctl -b -1 -r

Ejemplo ilustrativo: el registro de arranque anterior muestra que el servicio de copia de seguridad hipotético recibe SIGTERM y posteriormente se agota el tiempo de espera.
Busque frases como Stopping, stop job, timed out, Failed with result, Unmounting, Dependency failed, o mensajes del propio servicio sospechoso. Puede acotar la búsqueda una vez que conozca el nombre de la unidad:
sudo journalctl -b -1 -u backup.service
SUSE documenta journalctl -b -1el análisis de arranques anteriores en su documentación de registro de SLES 15 SP7 . Si journalctl --list-bootsno contiene el arranque anterior, no saque conclusiones a partir de la falta de historial; compruebe cómo está configurado el almacenamiento de journald y utilice la consola o el registro remoto para la siguiente reproducción.
Paso 3: Identifique si el bloqueador es un servicio, un montaje, un inhibidor o un gancho de apagado tardío.
Si puede reproducir el problema en una ventana de mantenimiento, mantenga disponible una segunda consola administrativa. Antes de que se pierda la conectividad, ejecute:
sudo systemctl list-jobs
sudo systemctl status backup.service
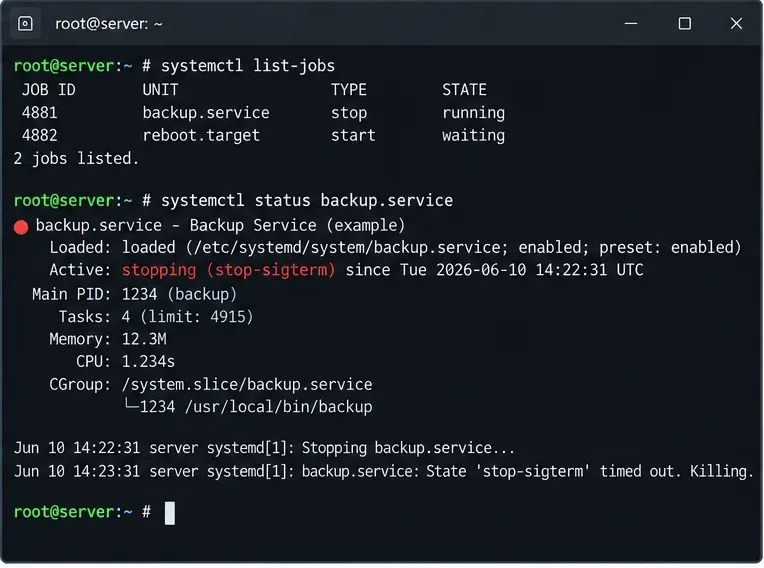
Ejemplo ilustrativo: backup.servicetiene una tarea de parada en ejecución mientras el objetivo de reinicio espera detrás de ella.
La guía de depuración de systemd explica que los trabajos mostrados como runningdeben finalizar antes de que los trabajos dependientes mostrados como waitingpuedan continuar. SUSE también recomienda systemctl list-jobscuando el apagado o el reinicio tardan demasiado. Esto hace que este comando sea particularmente útil cuando el servidor no está completamente bloqueado y el PID 1 aún responde.
Si un servicio se detiene demasiado lento
Inspeccione la definición de la unidad y su comportamiento de apagado:
sudo systemctl cat backup.service
sudo systemctl status backup.service
sudo journalctl -u backup.service -b
Compruebe si el servicio tiene alguna ExecStop=acción pendiente, si su proceso gestiona la señal SIGTERM y si está esperando recursos de almacenamiento o de red. Una base de datos, un agente de copia de seguridad o un servicio de middleware pueden necesitar tiempo para vaciar los datos, por lo que finalizarlo antes de tiempo no soluciona automáticamente el problema.
Si se trata de un montaje o un sistema de archivos de red.
Busque operaciones de desmontaje fallidas e identifique el origen del montaje:
findmnt
systemctl list-units --type=mount
sudo journalctl -b -1 | grep -Ei 'unmount|umount|mount|nfs|cifs'
Para NFS o CIFS, investigue la accesibilidad del servidor, las sesiones obsoletas y si las opciones de montaje se ajustan a los requisitos de apagado del servidor. Si la unidad bloqueada se genera a partir de /etc/fstab, corrija la configuración de montaje en lugar de aplicar un tiempo de espera específico del servicio a una unidad no relacionada.
Si se está inhibiendo la solicitud de reinicio
Antes de que comience el apagado, puede enumerar los inhibidores de systemd activos:
systemd-inhibit --list
Los bloqueos de inhibición pueden bloquear o retrasar las solicitudes de apagado mientras una aplicación está realizando tareas que no deberían interrumpirse. Son especialmente relevantes cuando la solicitud de reinicio se retrasa antes de que el sistema haya entrado en la secuencia de apagado final. Consulte el manual de systemd-inhibit .
Si el bloqueo se produce después de que los servicios ya estén caídos
Un bloqueo en una etapa posterior requiere una investigación diferente. systemd ejecuta programas /usr/lib/systemd/system-shutdown/poco antes del reinicio o apagado final y espera a que terminen. Si el registro y la consola muestran que los servicios habituales ya están detenidos y el bloqueo ocurre en la etapa final de apagado, revise ese directorio y cualquier gancho instalado por el proveedor. La documentación del servicio de apagado de systemd describe este comportamiento.
Paso 4: Repare el componente y luego pruebe un reinicio normal.
Volvamos al ejemplo hipotético lab-sles01. Supongamos que los registros muestran que backup.servicese ignora la terminación normal después de que el proceso de copia de seguridad ya ha finalizado. La primera opción es corregir el servicio o su comando de detención. Si se sabe que el servicio puede terminar de forma segura después de un período determinado, una anulación de systemd por unidad puede limitar el tiempo de espera de systemd.
Cree una anulación en lugar de editar una unidad de proveedor en /usr/lib/systemd/system:
sudo systemctl edit backup.service
Por ejemplo:
[Service]
TimeoutStopSec=30s
A continuación, recargue la configuración de la unidad systemd:
sudo systemctl daemon-reload
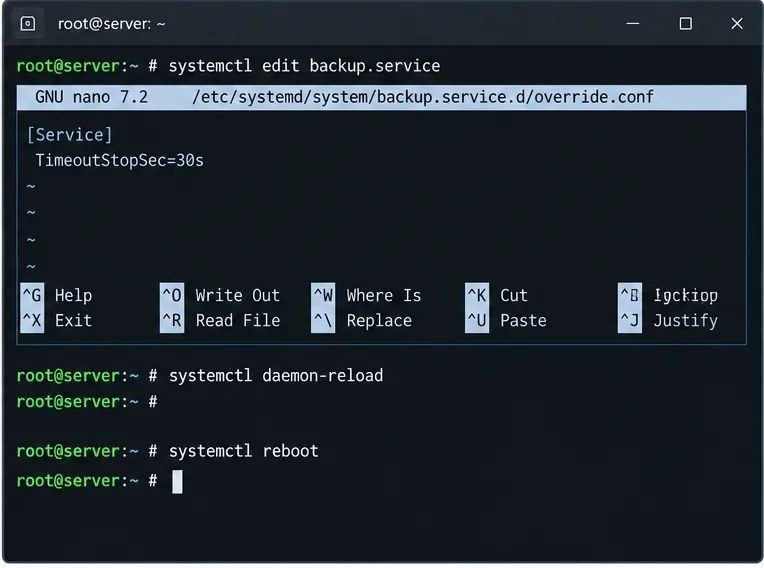
Ejemplo ilustrativo: el tiempo de espera por servicio se aplica solo después de que el servicio hipotético haya sido identificado como el causante del bloqueo.
No copie el valor de 30 segundos sin más. El tiempo de espera adecuado depende de lo que el servicio real deba finalizar de forma segura. Reducirlo para una base de datos, un demonio de almacenamiento, un servicio en clúster o un proceso de copia de seguridad puede interrumpir una limpieza legítima. Un tiempo de espera es una medida de seguridad, no un sustituto para corregir una ExecStop=acción defectuosa o una aplicación que no finaliza correctamente.
Cuando esté satisfecho con el cambio, pruebe a reiniciar el sistema normalmente:
sudo systemctl reboot
Una vez que la máquina se reinicie, revise nuevamente el arranque anterior y confirme que la unidad se detuvo correctamente en lugar de simplemente desaparecer de la consola.
¿Cuándo se debe realizar un reinicio forzado?
Un reinicio forzado es una opción de recuperación, no una estrategia de solución de problemas. La documentación oficial de systemd indica que si se realiza --forcecon el systemctl rebootcomando `settings`, se omite el apagado normal del servicio, pero aun así se terminan los procesos y se intenta desmontar o volver a montar los sistemas de archivos en modo de solo lectura. Realizar el reinicio --forcedos veces es más peligroso, ya que puede reiniciarse sin terminar los procesos ni desmontar los sistemas de archivos, con el consiguiente riesgo de pérdida de datos.
Si el servidor ya está bloqueado y no hay una forma más segura de recuperar el servicio, un reinicio forzado podría estar justificado según sus procedimientos operativos:
sudo systemctl reboot --force
Evite tratar systemctl reboot --force --forceun reinicio virtual o físico como una solución normal. Estas acciones pueden eliminar la evidencia necesaria y poner en peligro las escrituras en curso. La documentación de systemctl distingue explícitamente entre los comportamientos de reinicio simple y doble.
¿Qué ocurre si el sistema se bloquea cada vez que se reinicia y no se puede solucionar el problema en modo normal?
Utilice una consola de mantenimiento e inicie en modo de rescate. SUSE documenta cómo agregar comandos systemd.unit=rescue.targeta la línea de comandos del kernel desde el editor GRUB. El modo de rescate proporciona una sesión de root con acceso a los sistemas de archivos locales y los servicios principales, mientras que la red permanece inactiva, lo que puede ayudarle a deshabilitar o reparar el servicio o la configuración de montaje problemáticos.
Consulte la Guía de administración de SLES 15 SP7 para obtener el procedimiento oficial de modo de recuperación. En sistemas donde el problema aparece solo después de un cambio específico de paquete, kernel, controlador o almacenamiento, revise también el historial de mantenimiento de SUSE correspondiente antes de realizar cambios permanentes en el tiempo de espera.
Tabla de decisiones rápidas
| Lo que ves | Área probable para inspeccionar | Mejor siguiente paso |
|---|
A stop job is running for xyz.service | Ruta de cierre del servicio | Comprobación systemctl status, archivo de unidad y registro de servicio |
| Mensajes repetidos de desmontaje o de sistema de archivos remoto | Montaje, NFS, CIFS, almacenamiento | Comprobar findmnt, montar unidades /etc/fstaby la accesibilidad del servidor. |
| La solicitud de reinicio es rechazada o se retrasa antes del apagado. | Inhibidor u otra tarea de systemd | Corre systemd-inhibit --listysystemctl list-jobs |
| Los servicios se interrumpen, pero el cierre definitivo nunca se completa. | Gancho de apagado tardío, núcleo, controlador, almacenamiento | Revise el diario de arranque anterior y/usr/lib/systemd/system-shutdown/ |
| El arranque normal hace imposible la reparación. | Fallo persistente de la configuración o de la unidad | Bota consystemd.unit=rescue.target |
En resumen
Para un servidor SUSE Linux que se bloquea al apagar systemd, la solución definitiva consiste en identificar la tarea que systemd está esperando y corregir esa unidad o su dependencia. Registre el mensaje de apagado, inspeccione journalctl -b -1, utilice systemctl list-jobsy systemctl statuspara aislar el problema, y solo entonces cambie un tiempo de espera por servicio o una configuración de montaje. Reserve los métodos de reinicio forzado para situaciones de recuperación, no para operaciones rutinarias.

