Inicio
» WINDOWS
»
Cómo comprobar el estado del disco duro en Windows Server
Cómo comprobar el estado del disco duro en Windows Server
Para comprobar el estado del disco duro en Windows Server, inicie una sesión de PowerShell con privilegios de administrador y revise el estado del disco físico. A continuación, inspeccione los contadores de confiabilidad y, cuando el hardware los exponga, los datos SMART. Utilice esta herramienta chkdskpor separado para los errores del sistema de archivos; no se trata de una prueba de estado del hardware.
La Administración de discos ayuda a identificar discos, particiones y volúmenes. Un volumen marcado como "Correcto" no confirma que su unidad física haya superado las pruebas de diagnóstico SMART. Consulte la descripción general de la Administración de discos de Microsoft .
Antes de comprobar un disco de servidor
Si escucha chasquidos o ruidos extraños, observa errores de E/S repetidos o nota una ralentización repentina, verifique que una copia de seguridad reciente sea utilizable antes de realizar reparaciones o pruebas prolongadas. Anote el modelo de la unidad, el número de serie, la bahía y los volúmenes dependientes para poder identificar el dispositivo correcto.
Los controladores RAID, las HBA, las máquinas virtuales y algunos controladores pueden ocultar discos físicos o datos SMART. Una máquina virtual puede ver solo un disco virtual. Verifique la utilidad de administración del servidor o controlador, o el host del hipervisor, junto con Windows. La guía de solución de problemas de almacenamiento de Microsoft para Windows Server recomienda verificar los controladores y el firmware de almacenamiento con el proveedor del hardware.
1. Revisar el estado del disco físico en PowerShell.
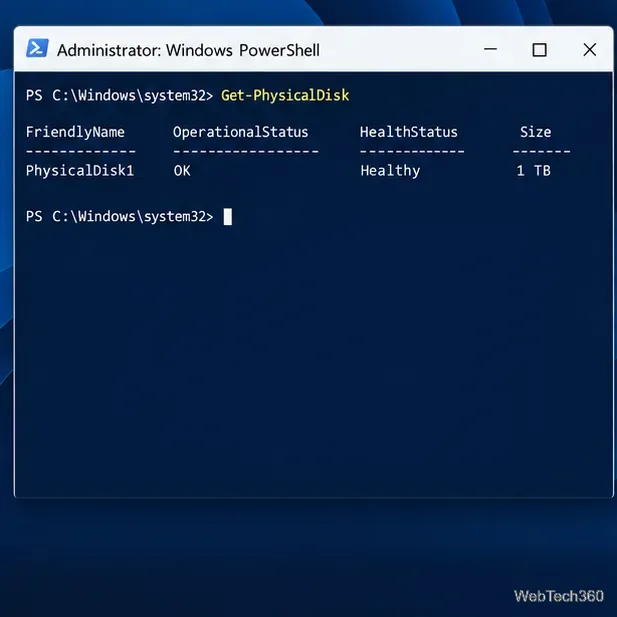
Abra PowerShell como administrador y ejecute este comando de solo lectura:
Get-PhysicalDisk muestra los objetos de disco visibles para los proveedores de administración de almacenamiento disponibles. Haga coincidir el modelo o el número de serie con la unidad que desea inspeccionar. HealthStatusPuede ser Healthy, Warning, Unhealthy, o Unknown; OperationalStatusinforma su estado operativo actual. Estas señales informadas por el proveedor no garantizan que una unidad no vaya a fallar. Investigue las advertencias, los discos faltantes o los estados inesperados, especialmente en un conjunto RAID o un grupo de Espacios de almacenamiento.
Los resultados y valores reales varían según el proveedor de almacenamiento.
2. Lea los contadores de confiabilidad.
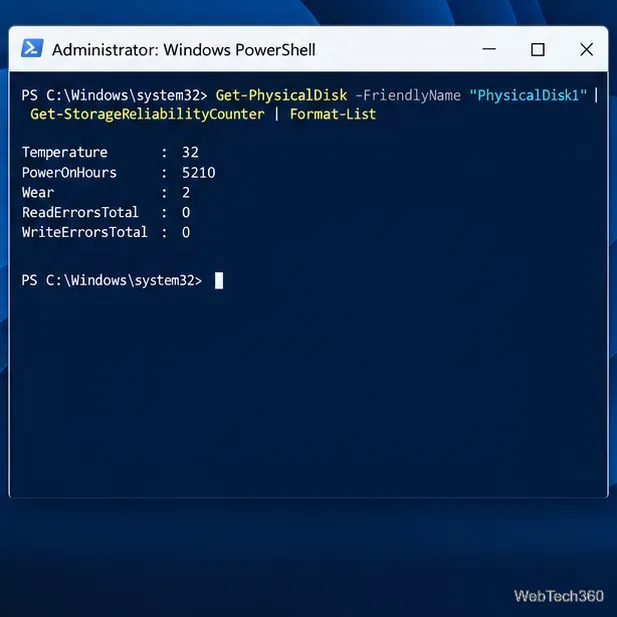
Sustituya PhysicalDisk8lo siguiente por el nombre descriptivo que aparece en su servidor:
El método Get-StorageReliabilityCounter puede devolver la temperatura, las horas de funcionamiento, el desgaste y los errores de lectura/escritura corregidos o no corregidos. Algunos campos pueden aparecer en blanco porque el dispositivo, el controlador o el controlador no los exponen; que estén en blanco no significa que no haya ningún problema.
Compare las tendencias con las recomendaciones del fabricante de la unidad o del servidor. No existe un límite universal de temperatura, desgaste o número de errores para todos los modelos. Si aparecen advertencias, aumentan los errores o falta una unidad esperada, proteja los datos e inspeccione los diagnósticos del proveedor o del controlador.
Los contadores disponibles y el formato dependen del dispositivo y del controlador.
3. Verifique los diagnósticos SMART y del controlador.
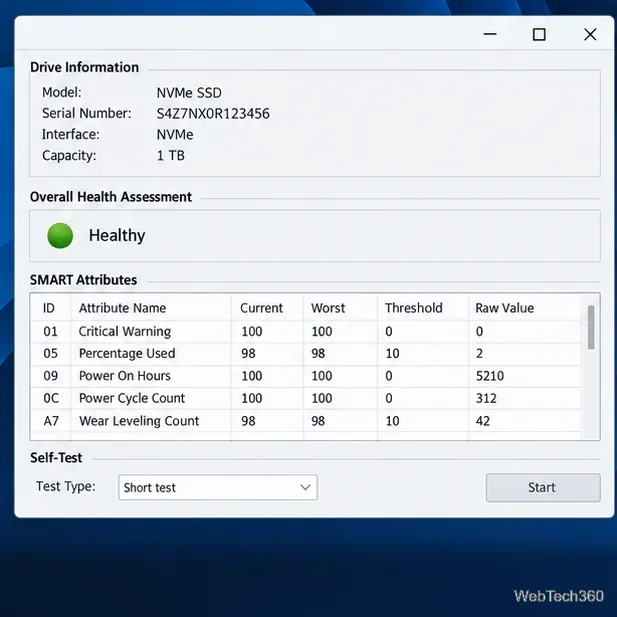
Para una vista gráfica SMART, descargue GSmartControl desde su página de descargas oficial . Se trata de una interfaz gráfica smartctlque muestra los atributos SMART y ofrece autodiagnósticos para las unidades compatibles. El proyecto incluye dispositivos SATA, PATA y NVMe, además de algunas unidades conectadas mediante puentes USB o controladores RAID. Confirme la compatibilidad con su edición de Windows Server y la política de software antes de instalarlo en un servidor de producción.
Seleccione la unidad deseada y revise su identidad, evaluación general y atributos. Un resultado positivo no garantiza que la unidad no falle. Si un controlador oculta datos SMART, utilice las herramientas de diagnóstico aprobadas por el proveedor del servidor o del controlador. Ejecute una autoprueba solo cuando sea apropiado para su hardware y ventana de mantenimiento.
Los campos y las pruebas SMART varían según la unidad; este no es un resultado de diagnóstico en tiempo real.
4. Compruebe el sistema de archivos NTFS con CHKDSK.
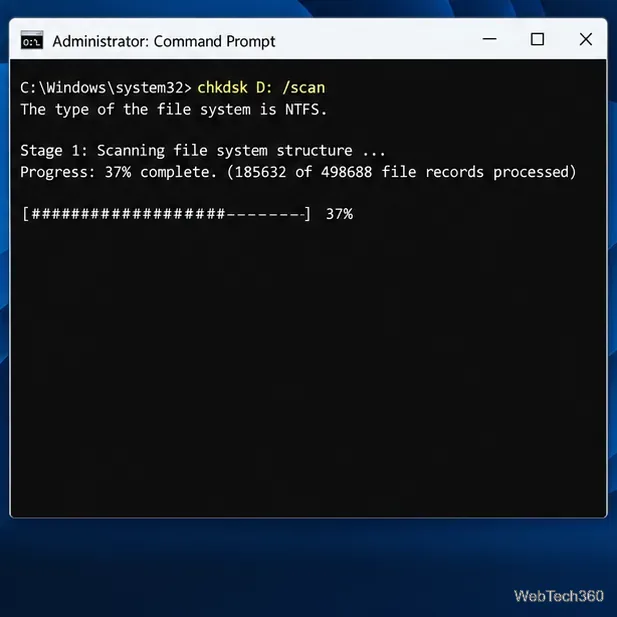
Para escanear un volumen NTFS local en línea, abra un símbolo del sistema como administrador y reemplace D:con la letra de volumen correcta:
chkdsk D: /scan
Microsoft documenta /scanesto como un análisis NTFS en línea. Comprueba la estructura del sistema de archivos y los metadatos, no el estado SMART ni el estado mecánico o electrónico de la unidad. Si encuentra corrupción, realice una copia de seguridad del volumen y planifique una reparación. Las opciones como /fy /rpueden requerir que el volumen se bloquee o se compruebe durante el reinicio; consulte la referencia del comando CHKDSK antes de programar reparaciones en un servidor de producción.
El progreso del escaneo que se muestra es un ejemplo; el resultado varía según el volumen.
Cómo actuar en función de los resultados
En buen estado o correcto: El proveedor no informa de ninguna advertencia actual. Realice copias de seguridad y monitorización periódicas; esto no garantiza la ausencia de fallos.
Advertencia, estado deficiente, error desconocido, errores crecientes o disco faltante: realice una copia de seguridad de los datos críticos e inspeccione los diagnósticos del proveedor/controlador y los eventos recientes del sistema. Verifique el estado de la matriz o de Storage Spaces antes de reemplazarla; no extraiga ni reinicie un disco agrupado sin seguir su procedimiento de reemplazo.
CHKDSK informa de un problema en el sistema de archivos: Planifique una reparación de volumen autorizada y compruebe el estado del hardware por separado. Los errores del sistema de archivos por sí solos no permiten identificar su causa.
Para un servidor de producción, compare el informe de Windows con la vista del proveedor o del controlador. Confirme las copias de seguridad y la redundancia antes de reemplazar una unidad y, a continuación, supervise el sistema tras la reparación o el reemplazo.