Home
» AMMINISTRAZIONE DI RETE
»
Procedure ottimali per il monitoraggio della rete: cosa monitorare e quali strumenti utilizzare
Procedure ottimali per il monitoraggio della rete: cosa monitorare e quali strumenti utilizzare
Un monitoraggio efficace della rete inizia con un inventario verificato, metriche incentrate sui servizi e avvisi concreti. Mappate i dispositivi e i servizi critici, stabilite le prestazioni normali e scegliete una piattaforma che supporti la vostra infrastruttura e che possa essere gestita dal vostro team. Questo aiuta a individuare i problemi in fase iniziale senza trasformare ogni breve fluttuazione in un problema.
Cosa dovrebbe rivelarti il monitoraggio della rete
Il monitoraggio della rete tiene traccia della raggiungibilità di dispositivi e servizi e delle loro prestazioni nel tempo. In genere, comprende lo stato di dispositivi e interfacce, il traffico, le risorse del server e i controlli dei servizi. La registrazione degli eventi di sicurezza ha una funzione diversa: un NMS (Network Management System) spiega la disponibilità e le prestazioni, mentre i log centralizzati o un SIEM (Security Information and Event Management) aiutano a indagare su eventi come accessi sospetti e modifiche alla configurazione. Molti team utilizzano entrambi. Il NIST (National Institute of Standards and Technology) definisce il monitoraggio continuo come una consapevolezza costante per le decisioni relative ai rischi; è importante rivedere la copertura di rete man mano che l'ambiente cambia.
Procedure ottimali per il monitoraggio della rete
1. Crea un inventario prima di impostare gli avvisi
Elenca router, switch, firewall, apparecchiature wireless, server critici, collegamenti cloud e servizi rivolti ai clienti. Per ciascuno, registra posizione, proprietario, priorità aziendale, indirizzo di gestione e dipendenze. Utilizza la funzione di rilevamento per inizializzare l'inventario, quindi verificalo e aggiungi i dispositivi che non vengono rilevati automaticamente. Raggruppa per sito o servizio. Aggiorna l'elenco dopo ogni modifica per garantire una copertura completa.
Una vista topologica di esempio collega lo stato del dispositivo alle dipendenze a monte e a valle.
2. Monitorare i segnali che spiegano l'impatto sull'utente
Iniziate con una serie compatta di misurazioni legate ai servizi critici:
Disponibilità: stato del dispositivo e dell'interfaccia, oltre a verifiche per servizi essenziali come DNS, applicazioni web, e-mail o accesso VPN.
Qualità del percorso: latenza, perdita di pacchetti e jitter, fattori importanti per la trasmissione di voce o video in tempo reale.
Traffico e capacità: utilizzo dell'interfaccia, throughput, errori e scarti. Conserva lo storico per poter distinguere un picco temporaneo da un problema di capacità ricorrente.
Stato di salute del dispositivo: CPU, memoria, temperatura, alimentazione o stato della ventola, laddove l'apparecchiatura renda disponibili tali informazioni.
Sistemi di supporto: archiviazione del server e stato di salute del servizio quando un'interruzione dell'applicazione potrebbe essere causata al di fuori del livello di rete.
Definisci parametri di riferimento per sito e servizio anziché utilizzare una soglia universale. Confronta il comportamento attuale con i normali periodi di maggiore affluenza e monitora eventuali picchi di domanda prolungati o cambiamenti improvvisi.
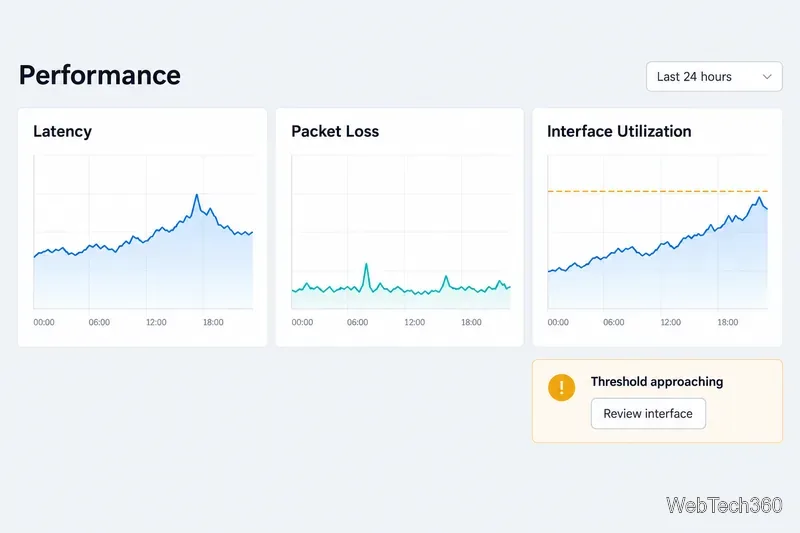
Un esempio di dashboard delle prestazioni aiuta a distinguere le variazioni normali dalla pressione prolungata su un collegamento.
3. Rendere gli avvisi utilizzabili e ridurre i duplicati
Ricevi avvisi in caso di condizioni che richiedono un intervento: interruzioni, controlli di servizio non superati o superamenti prolungati delle soglie. Utilizza una regola di ritardo o di ripristino per filtrare le anomalie temporanee. Includi il dispositivo o l'interfaccia, il servizio o il sito interessato, l'ora della prima rilevazione, i valori osservati e previsti e un manuale operativo. Inoltra gli avvisi a un responsabile e definisci la procedura di escalation.
Raggruppa gli avvisi a valle quando un guasto a monte li spiega; pianifica finestre di manutenzione per gli interventi programmati. Questo aiuta i responsabili a individuare più rapidamente le cause probabili. Rivedi le regole di soppressione dopo le modifiche alla topologia in modo che i guasti indipendenti rimangano visibili.
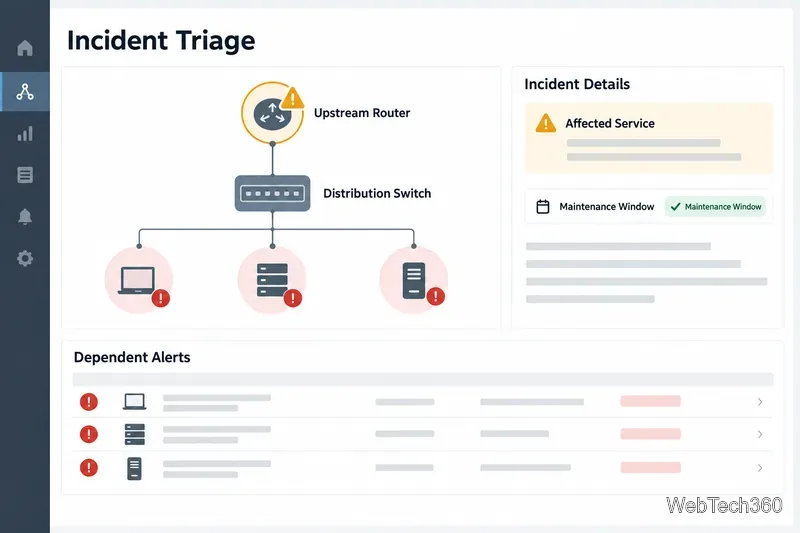
Una visualizzazione di esempio dell'incidente mostra come gli avvisi dipendenti possano indirizzare gli addetti alla risposta al primo collegamento non funzionante.
4. Proteggere il sistema di monitoraggio
Il monitoraggio delle credenziali e dei log può rivelare infrastrutture sensibili. Limita il traffico di gestione, utilizza account di sola lettura ove possibile, concedi l'accesso basato sui ruoli e proteggi il server di monitoraggio e i backup. Preferisci SNMPv3 quando supportato, con impostazioni di autenticazione e privacy compatibili; il modello di sicurezza basato sugli utenti di SNMPv3 definisce questi servizi di sicurezza. Segui le linee guida CISA per la protezione dei log e non esporre mai le interfacce di gestione direttamente a Internet.
5. Test di copertura, avvisi e ripristino
Verificare che le sonde raggiungano i dispositivi dalle posizioni pertinenti, che le credenziali funzionino e che la cronologia venga conservata per la risoluzione dei problemi e la pianificazione della capacità. Testare gli avvisi con i destinatari; documentare i responsabili e i programmi di manutenzione. Esaminare i dispositivi obsoleti, le lacune e le regole non pertinenti dopo le modifiche alla rete. Mantenere un piano di ripristino testato per la piattaforma di monitoraggio.
Tre strumenti di monitoraggio della rete da valutare
Questi prodotti coprono esigenze comuni. La loro idoneità dipende dall'ambiente, dal modello di implementazione, dalle licenze e dalle competenze disponibili. Verificate i piani tariffari e il supporto dei dispositivi con ciascun fornitore.
Strumento
Dove potrebbe adattarsi
Verifica durante la valutazione
Monitor delle prestazioni di rete SolarWinds
Ambienti multi-vendor che necessitano di metriche dei dispositivi, mappe, avvisi, report o risoluzione dei problemi di percorso. Il fornitore elenca disponibilità, latenza, perdita di pacchetti, utilizzo e stato di salute del dispositivo.
Verifica il supporto del dispositivo e del protocollo, l'implementazione, la conservazione e i moduli necessari. Consulta SolarWinds NPM .
Monitor di rete Paessler PRTG
I team monitorano dispositivi, traffico, server e servizi tramite mappe, dashboard e notifiche. PRTG rappresenta i valori monitorati come sensori.
Stimate il fabbisogno di sensori e sonde per il vostro piano di copertura. Consultate Paessler PRTG .
ManageEngine OpManager
Organizzazioni che necessitano di funzionalità di rilevamento e monitoraggio delle prestazioni su dispositivi di rete e server. La documentazione descrive il supporto per SNMP, CLI e WMI.
Verifica l'accesso al protocollo, i modelli, i controlli dei ruoli, i componenti aggiuntivi e la gestione dei siti remoti. Consulta OpManager .
Scegli con un piccolo pilota
Eseguite un test pilota su un sito rappresentativo, un servizio critico e un mix di dispositivi. Verificate il rilevamento, l'accuratezza delle metriche, gli avvisi, la gestione della manutenzione, i report, le autorizzazioni e il ripristino. Chiedete agli utenti del dashboard quali informazioni contestuali mancano. Un breve test pilota dimostra se la piattaforma si adatta meglio alla vostra rete rispetto a una semplice lista di funzionalità.