ownCloud oCISでユーザーのストレージクォータを設定する方法

ownCloud Infinite Scaleユーザーの個人スペースのクォータを設定する方法、プロジェクトスペースやグローバル制限と区別する方法、そして役割ごとに新規ユーザーにデフォルト値を割り当てる方法を学びましょう。
プロセスがCPU使用率100%近くに達した場合amavisd、単にそのプロセスを消滅させることが目的ではありません。効果的な解決策は、通常のメールフローを回復させ、処理遅延を軽減し、スパム対策とウイルス対策の機能を維持し、Postfixキューが肥大化するのを防ぐことです。
Zimbraでは、Amavisd-NewはMTAとコンテンツスキャナの間に位置します。Zimbraの最新のDaffodil管理者ガイドでは、Amavisd-NewはZimbra MTA、ClamAV、およびSpamAssassin間のインターフェースであると説明されています。つまり、CPUスパイクは、Amavis自体、SpamAssassinのルールやメッセージの内容、ウイルス対策スキャン、または利用可能なワーカーをすべて占有するバックログによって発生する可能性があります。Zimbra Daffodil管理者ガイドを参照してください。
成功の兆候は4つあります。AmavisのCPU使用率が持続可能なレベルまで低下し、保留キューとアクティブキューの増加が止まり、新しいメッセージが異常な遅延なく通過し、スパム対策/ウイルス対策サービスが正常に動作し続けることです。フィルタリングを無効にしただけでCPU使用率が低下した場合は、根本的な問題が解決されていないことを意味します。
まずはオペレーティングシステムレベルから始めましょう。メール配信が遅いからといって、Amavisが原因だと決めつけないでください。最も負荷の高いプロセスを確認し、1つ以上のamavisdワーカーが常にCPUコアをフルに消費しているかどうかを確認してください。
top -c

ps -eo pid,user,pcpu,pmem,etime,cmd --sort=-pcpu | head -20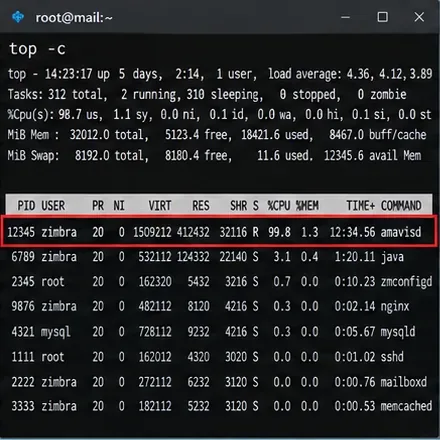
キャプション:Zimbraの設定を変更する前に確認すべき最初の条件として、amavisdがCPUを最も消費している状態を示すターミナル画面。
大きなメッセージや圧縮された添付ファイルをスキャンしている間は、一時的にCPU使用率が急上昇することがありますが、これは正常な動作です。メールの遅延やキューの深さが増加しているにもかかわらず、同じ症状が続く場合は、問題が継続していると判断してください。また、ロードアベレージ、空きメモリ、スワップアクティビティ、I/O待機時間も確認してください。CPU使用率が高く、スワップやストレージの競合が激しい場合は、Amavisのみの変更ではなく、ホストレベルでのより広範な調査が必要になる可能性があります。
Zimbraアカウントに切り替えて、サービスの状態を確認してください。Zimbraのドキュメントでは、zmcontrol status有効なサービスを確認するための標準的な方法として、以下の手順を使用しています。
su - zimbra
zmcontrol status
zmamavisdctl status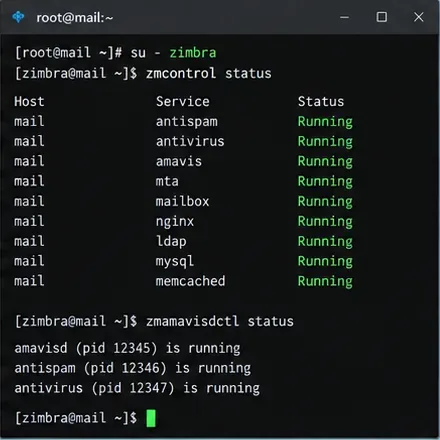
キャプション:トラブルシューティング開始前に、Zimbraサービスのステータスが表示され、Amavis、スパム対策、ウイルス対策、およびMTAコンポーネントが実行されていることが示されています。
この手順が重要なのは、「CPU使用率100%」と「サービス停止」は異なる障害モードだからです。Amavisが実行されていない場合は、起動エラーを調査してください。Amavisが実行されているもののCPUが飽和状態になっている場合は、キューとログの分析を続けてください。
キューの深さを確認することで、CPU使用率の高さが配信に影響を与えているかどうかがわかります。キューのカウントについてはZimbraのキュートラブルシューティング資料をzmqstat、メッセージの詳細についてはPostfixのキューコマンドを参照してください。これらのチェックは数分間隔で繰り返し実行してください。
sudo /opt/zimbra/libexec/zmqstat
postqueue -p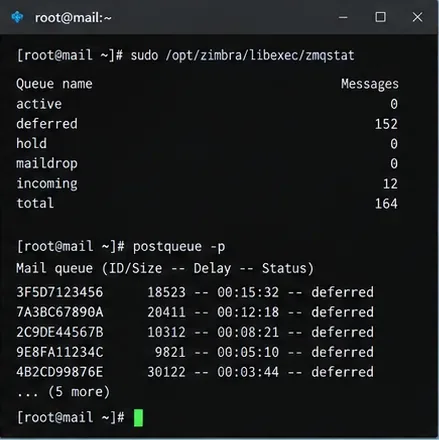
キャプション:キュー統計と遅延メッセージは、CPU使用率だけよりもメールフローへの影響をより正確に測定できる指標です。
単一の数値ではなく、方向性を見極めましょう。サンプルごとに待ち行列が増加するということは、スループットが到着率を下回っていることを意味します。変更後に待ち行列が着実に減少することは、その変更が実際に効果を発揮したことを示す最も有力な兆候の一つです。
複数のMTA(マルチMTA)構成で運用している場合は、影響を受けているMTAノードを具体的に確認してください。他のノードのキューにも同じボトルネックが発生しているとは限らないため、その点に注意してください。
AmavisとSpamAssassinのトラブルシューティングメッセージは に書き込まれます/var/log/zimbra.log。CPU使用率が急上昇した時間帯を検索し、メッセージID、プロセスID、スキャン期間を関連付けてください。
grep -iE 'amavis|spamassassin|clam' /var/log/zimbra.log | tail -n 200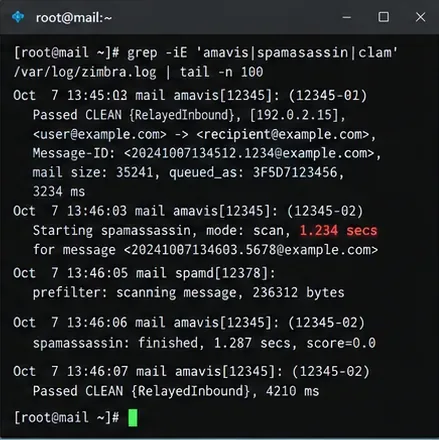
キャプション:AmavisとSpamAssassinのログ行を確認することで、個々のメッセージやスキャン段階に異常に時間がかかっているかどうかを知ることができます。
有用なパターンとしては、SpamAssassinによる長時間のスキャンが繰り返される、同じキューIDに対して再試行が繰り返される、ClamAVの通信エラーが発生する、解凍関連の障害が発生する、または少数のメッセージが繰り返しワーカーを消費する、といったことが挙げられます。Zimbraのトラブルシューティングドキュメントでは、スキャンの遅延によってメールフローが阻害される場合に、AmavisとSpamAssassinのデバッグログ記録を特に推奨しています。Zimbraのログ記録に関するトラブルシューティングリファレンスを参照してください。
Zimbraは、AmavisとSpamAssassinそれぞれに個別のログ記録制御機能を提供しています。Amavisのログレベルは0~5の範囲で、zimbraAmavisSALogLevelSpamAssassinは0または1を使用します。より詳細なデバッグが必要でない限り、最大レベルのログではなく、Amavisレベル2から始めることをお勧めします。
su - zimbra
zmprov mcf zimbraAmavisLogLevel 2
zmprov mcf zimbraAmavisSALogLevel 1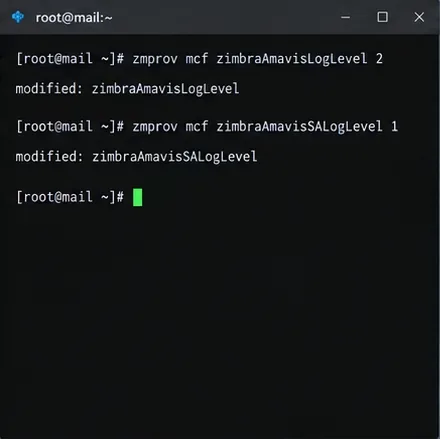
キャプション:一時的なログ記録の変更により、スキャンタイミングとSpamAssassinの動作をCPUスパイクと関連付けやすくなります。
問題の再現または観察は、有用なデータを取得できる程度に留めてください。ログレベルを高くするとディスクへの書き込みが増加し、ビジー状態のサーバーの動作が不安定になる可能性があります。調査後は、以前の設定値に戻してください。Zimbraのドキュメントによると、SpamAssassinのデフォルトのログレベルは0、Amavisのログレベルは通常低レベルです。
zmprov mcf zimbraAmavisSALogLevel 0
zmprov mcf zimbraAmavisLogLevel 1ログが常にSpamAssassinを指している場合は、ルール変更、カスタムルールの展開、またはルール更新の失敗後に問題が発生したかどうかを確認してください。不適切な正規表現や問題のあるルールは、特定のメッセージ本文で処理コストが高くなる可能性があります。
Zimbraの公式Amavisトラブルシューティング資料には、ZCS 8.8以降にバンドルされているSpamAssassinのアップデートコマンドが次のように記載されています。
su - zimbra
/opt/zimbra/common/bin/sa-update -D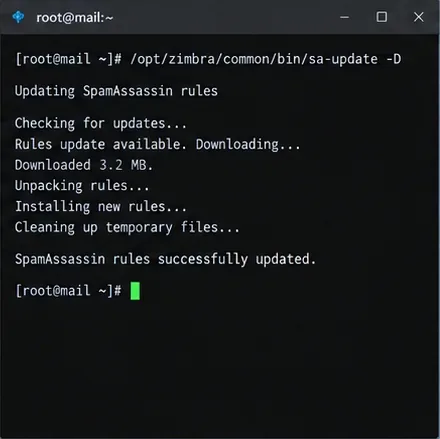
キャプション:ログや起動エラーでルールデータが古くなっているか破損していることが示された場合は、バンドルされているSpamAssassinのルールを更新するのが適切です。
CPU の問題を解決するための万能薬として扱わないでくださいsa-update。カスタム ルールを追加した直後にスパイクが発生した場合は、まずそのルールをテストしてください。Zimbra は最新のカスタム SpamAssassin ルールを に保存します/opt/zimbra/data/spamassassin/localrules/。管理されたメンテナンス ウィンドウで疑わしいカスタマイズのみを削除または無効にしてから、スキャン時間とキューの動作を比較してください。
Zimbraの公式Wikiには、新しいZCSリリースにおけるルールの自動更新とコンパイル設定についても記載されています。既存のサーバーで自動動作を有効にする前に、Zimbraのスパム対策戦略を確認してください。
再起動によってスタックしたワーカーを解放し、更新されたルールをロードできますが、診断結果を置き換えるのではなく、診断結果に基づいて実行する必要があります。より広範なMTAスタックに問題があることを示す証拠がない限り、まずはAmavisのみを再起動してください。
su - zimbra
zmamavisdctl restart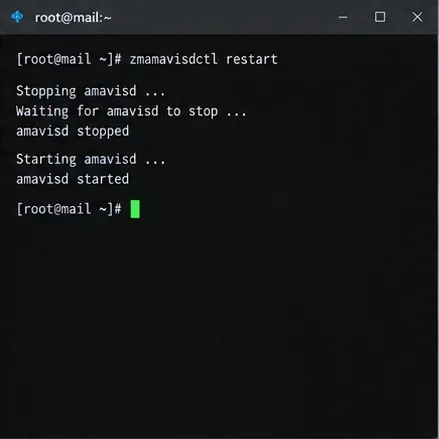
キャプション:Amavisを再起動すると、特定のルールや構成の変更後にサービスが再読み込みされ、Zimbraのすべてのサービスが不必要に再起動されることはありません。
CPU使用率がすぐに100%に戻る場合は、原因がまだ存在していることを示す有用な証拠となります。ログを確認し、同じメッセージ、スキャナ、またはルールが再び出現するかどうかを確認してください。サービスを繰り返し再起動すると、一時的に症状が軽減される可能性がありますが、キューが増加する可能性があります。
CPU使用率が一度低下したからといって、インシデントが解決したと判断してはいけません。プロセスの負荷、キューの方向、サービスの健全性を総合的に確認してください。
top -c
sudo /opt/zimbra/libexec/zmqstat
zmcontrol status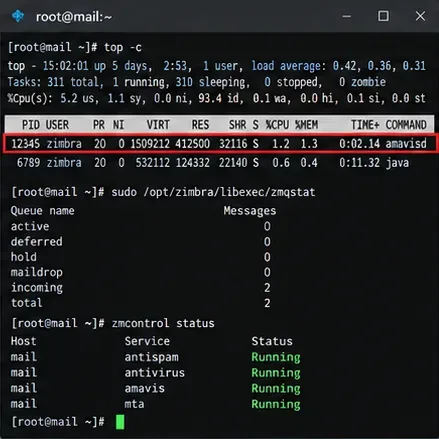
キャプション:CPU使用率、キューの深さ、Zimbraサービスのステータスがすべて同時に改善すると、回復力が向上します。
次に、影響を受けているMTA経由でテストメッセージを送信し、通常の遅延範囲内で配信されることを確認します。フィルタリングを通過するはずのメッセージについては、ヘッダーを調べて、Zimbra/Amavisのスパムおよびウイルススキャンに必要なフィールドを確認します。Zimbraは、これらのチェックが有効になっている場合X-Virus-Scanned、などのヘッダーを文書化しますX-Spam-Status。
| あなたが観察するもの | 次に最適な行動 | なぜ |
|---|---|---|
| 1つのメッセージが繰り返し長時間のスキャンを引き起こす | そのメッセージを安全に隔離または検査し、そのキューIDをログと関連付けます。 | ボトルネックは容量関連ではなく、コンテンツ固有のものである可能性がある。 |
| SpamAssassinのタイミングが支配的 | カスタムルール、ルール更新、デバッグ出力を確認する | 正規表現を多用したルールセットや破損したルールセットは、スコアリングコストが高くなる可能性がある。 |
| ClamAVのエラーやタイムアウトが多発している。 | ウイルス対策ソフトの状態を調査し、更新します。 | アマビスは単にスキャナーを待っているだけかもしれない |
| CPU使用率は高いが、キューはほぼゼロのままだ。 | 破壊的な変更を加える前に、より長く観察する | スループットとレイテンシが健全な状態であれば、高い利用率も許容範囲内である。 |
| 的を絞った修正後も行列は増え続ける | キャパシティ、メッセージパターン、またはサポートレベルの分析にエスカレーションする | サーバーが容量不足、攻撃を受けている、またはソフトウェア固有の欠陥に遭遇している可能性があります。 |
CPU使用率を下げるためだけに、スパム対策やウイルス対策のスキャン機能を恒久的に無効にしないでください。Zimbraは特定の信頼できる発信元トラフィックに対してバイパスポリシーをサポートしていますが、これはセキュリティモデルを変更するものであり、一般的なパフォーマンス調整ではなく、意図的なメールポリシーの決定事項であるべきです。ZimbraのSpamAssassin発信元バイパスに関するドキュメントには、バイパスが信頼できる内部ネットワークに関連付けられていることが明記されています。
また、Amavisのワーカー数をむやみに増やすことは避けてください。ワーカー数を増やすと並行処理能力は向上しますが、メモリ負荷も増大し、CPU競合が悪化する可能性があります。適切な値は、メッセージの種類、添付ファイルのサイズ、スキャナの動作、利用可能なコア数、メモリ容量、I/Oなどによって異なります。ワーカープールを大きくすれば処理速度が向上すると安易に考えるのではなく、変更内容をキューのスループットとレイテンシに基づいてテストしてください。
この手順は、Amavisが稼働しているもののCPU負荷が継続的に高い状態が続くという一般的なケースを想定して設計されています。製品の不具合、サーバーの侵害、不正なメッセージによるサービス拒否攻撃、外部スキャナを備えたマルチノードアーキテクチャなど、特定のバージョンにおけるZimbraのサポートガイダンスに代わるものではありません。
Zimbra のコミュニティ技術資料には、特殊なメッセージや SpamAssassin の動作によって Amavis ワーカーが長時間 CPU を占有してしまう事例が過去に報告されています。影響の程度はインストールされている Zimbra と SpamAssassin のバージョンによって異なるため、古いパッケージのアップグレード手順を安易に適用しないでください。まず、Zimbra のバージョンを記録しzmcontrol -v、サポートされているリリースおよびパッチレベルと比較し、最新のベンダーガイダンスに従ってアップグレードを行ってください。
ownCloud Infinite Scaleユーザーの個人スペースのクォータを設定する方法、プロジェクトスペースやグローバル制限と区別する方法、そして役割ごとに新規ユーザーにデフォルト値を割り当てる方法を学びましょう。
BigBlueButton FreeSWITCHのSIP登録タイムアウトを診断するには、サービスの状態、SIPおよびESLリスナー、NATアドレス、ファイアウォールルール、ログを確認します。
ownCloudモバイルアプリの接続拒否エラーを修正するには、サーバーURL、HTTPSポート、Webサーバー、ファイアウォール、プロキシ、TLS、および信頼済みドメインを確認してください。
Synapse 上で新しい Matrix アカウントを制御する方法を、公開登録の無効化から使用制限付きトークンの発行まで、設定例とチェック項目を含めて比較します。
Fix an ownCloud blank page by separating browser, PHP, app, permissions, upgrade, and proxy failures, then choose the least disruptive recovery path.
Zimbraの停止したNGINXプロキシを診断し、適切なログを読み取り、安全に再起動し、設定の欠落、無効なポート、証明書、および上流の障害に対する的を絞った修正を確認します。
危険な変更を加える前に、キュー、ログ、SpamAssassin、ClamAV、および回復の兆候を確認することで、Zimbra AmavisがCPU使用率100%になっている場合の診断と修復方法を学びましょう。
アカウントの詳細、認証情報、証明書、ネットワークパス、サーバーポリシーを確認し、安全な代替手段を比較することで、iPhone 上の Zimbra ActiveSync エラーのトラブルシューティングを行います。
ownCloud Infinite ScaleとNextcloud 28を、アーキテクチャ、パフォーマンス動作、RAM要件、キャッシング、スケーリング、および実際の導入におけるトレードオフの観点から比較します。
Nextcloudのトランザクションファイルロックに関する警告を修正するには、デプロイメントを確認し、RedisまたはKeyValueCacheを設定し、適切なサービスを再起動し、ファイル操作を検証してください。