Home
» NETWERKBEHEERDER
»
Beste praktijken voor netwerkmonitoring: wat te volgen en welke tools te gebruiken
Beste praktijken voor netwerkmonitoring: wat te volgen en welke tools te gebruiken
Effectieve netwerkmonitoring begint met een geverifieerde inventaris, servicegerichte meetwaarden en bruikbare waarschuwingen. Breng kritieke apparaten en services in kaart, bepaal de normale prestaties en kies vervolgens een platform dat uw infrastructuur ondersteunt en door uw team kan worden onderhouden. Dit helpt om zich ontwikkelende problemen te signaleren zonder dat elke kleine fluctuatie een groot probleem wordt.
Wat netwerkmonitoring u zou moeten vertellen
Netwerkmonitoring houdt bij of apparaten en services bereikbaar zijn en hoe ze in de loop van de tijd presteren. Het omvat doorgaans de status van apparaten en interfaces, verkeer, serverbronnen en servicecontroles. Beveiligingslogging heeft een andere functie: een NMS geeft inzicht in beschikbaarheid en prestaties, terwijl gecentraliseerde logboeken of een SIEM helpen bij het onderzoeken van gebeurtenissen zoals verdachte aanmeldingen en configuratiewijzigingen. Veel teams gebruiken beide. NIST omschrijft continue monitoring als voortdurende bewustwording voor risicobeslissingen; evalueer de netwerkdekking naarmate de omgeving verandert.
Best practices voor netwerkmonitoring
1. Stel een inventaris samen voordat u waarschuwingen instelt.
Maak een lijst van routers, switches, firewalls, draadloze apparatuur, kritieke servers, cloudverbindingen en klantgerichte services. Noteer voor elk apparaat de locatie, eigenaar, zakelijke prioriteit, beheeradres en afhankelijkheden. Gebruik de detectiefunctie om de inventaris te vullen, controleer deze vervolgens en voeg apparaten toe die niet automatisch worden gevonden. Groepeer per locatie of service. Werk de lijst bij na wijzigingen, zodat de dekking volledig blijft.
Een voorbeeld van een topologieweergave koppelt de apparaatstatus aan afhankelijkheden stroomopwaarts en stroomafwaarts.
2. Monitor signalen die de impact op de gebruiker verklaren.
Begin met een compacte set meetinstrumenten die gekoppeld zijn aan essentiële diensten:
Beschikbaarheid: status van het apparaat en de interface, plus controles voor essentiële services zoals DNS, webapplicaties, e-mail of VPN-toegang.
Padkwaliteit: latentie, pakketverlies en jitter, waar realtime spraak of video ervan afhankelijk is.
Verkeer en capaciteit: interfacegebruik, doorvoer, fouten en weggegooide berichten. Houd de historische gegevens bij, zodat u een korte piek kunt onderscheiden van een terugkerend capaciteitsprobleem.
Apparaatstatus: CPU-, geheugen-, temperatuur-, stroom- of ventilatorstatus, voor zover het apparaat deze gegevens weergeeft.
Ondersteunende systemen: serveropslag en servicestatus wanneer een applicatiestoring mogelijk buiten de netwerklaag wordt veroorzaakt.
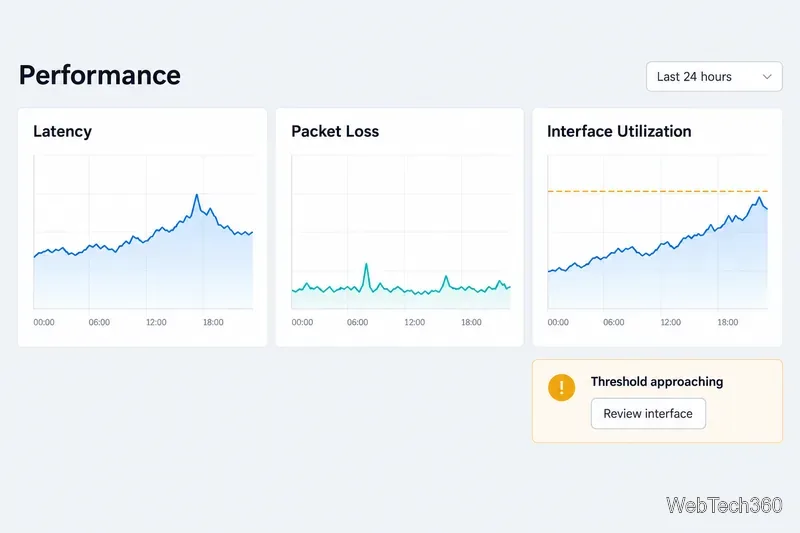
Stel basiswaarden vast per locatie en dienst in plaats van één universele drempelwaarde te gebruiken. Vergelijk het huidige gedrag met normale drukke perioden en let op aanhoudende druk of plotselinge veranderingen.
Een voorbeeld van een prestatiedashboard helpt om normale variaties te onderscheiden van aanhoudende druk op een verbinding.
3. Zorg voor bruikbare acties bij waarschuwingen en verminder duplicaten.
Geef een waarschuwing bij situaties die actie vereisen: storingen, mislukte servicecontroles of aanhoudende overschrijdingen van drempelwaarden. Gebruik een vertragings- of herstelregel om tijdelijke storingen te filteren. Voeg het apparaat of de interface, de getroffen service of locatie, het tijdstip van eerste waarneming, de waargenomen en verwachte waarden en een draaiboek toe. Stuur waarschuwingen door naar een verantwoordelijke en definieer de escalatieprocedure.
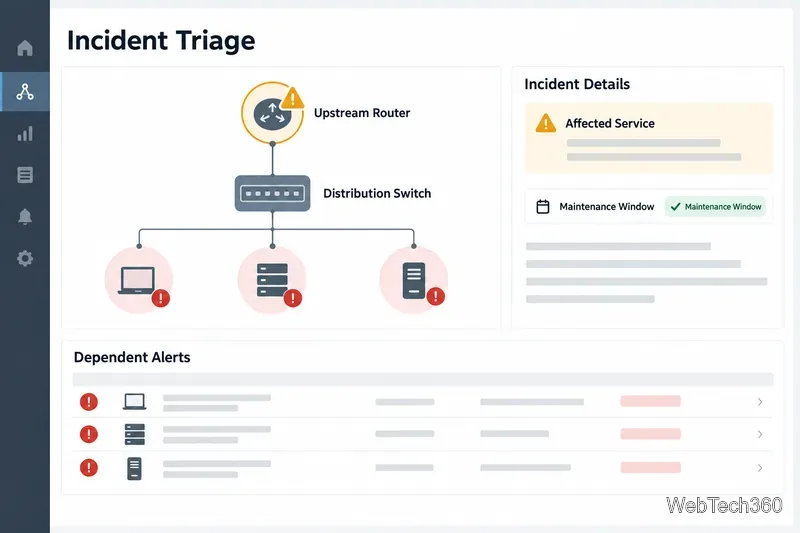
Groepeer downstream-waarschuwingen wanneer een upstream-storing deze verklaart; plan onderhoudsvensters in voor gepland werk. Dit helpt hulpverleners om de waarschijnlijke oorzaken sneller te vinden. Controleer de onderdrukkingsregels na topologiewijzigingen, zodat onafhankelijke storingen zichtbaar blijven.
Een voorbeeld van een incidentweergave laat zien hoe afhankelijke waarschuwingen hulpverleners kunnen wijzen op de eerste defecte schakel.
4. Bescherm het bewakingssysteem
Het inzien van inloggegevens en logboeken kan gevoelige infrastructuurgegevens aan het licht brengen. Beperk beheerverkeer, gebruik waar mogelijk alleen-lezen accounts, verleen toegang op basis van rollen en beveilig de monitoringserver en back-ups. Geef de voorkeur aan SNMPv3 indien ondersteund, met compatibele authenticatie- en privacyinstellingen; het SNMPv3 User-based Security Model definieert deze beveiligingsservices. Volg de CISA-richtlijnen voor het beschermen van logboeken en stel beheerinterfaces nooit rechtstreeks bloot aan het openbare internet.
5. Testdekking, waarschuwingen en herstel
Controleer of de probes de apparaten vanaf de juiste locaties bereiken, of de inloggegevens werken en of de geschiedenis wordt bewaard voor probleemoplossing en capaciteitsplanning. Test waarschuwingen met de ontvangers; documenteer de eigenaren en onderhoudsschema's. Controleer verouderde apparaten, hiaten en regels die onnodig veel data genereren na netwerkwijzigingen. Zorg voor een getest herstelplan voor het monitoringplatform.
Drie netwerkmonitoringtools om te evalueren
Deze producten voorzien in de meest voorkomende behoeften. De geschiktheid hangt af van uw omgeving, implementatiemodel, licenties en beschikbare vaardigheden. Controleer de abonnementen en apparaatondersteuning bij elke leverancier.
Hulpmiddel
Waar het past
Controleer tijdens de evaluatie.
SolarWinds Netwerkprestatiemonitor
Omgevingen met meerdere leveranciers die apparaatstatistieken, kaarten, waarschuwingen, rapportages of probleemoplossing voor netwerkpaden nodig hebben. De leverancier geeft gegevens over beschikbaarheid, latentie, pakketverlies, gebruik en apparaatstatus.
Controleer de ondersteuning voor apparaten en protocollen, de implementatie, het behoud van gegevens en de benodigde modules. Zie SolarWinds NPM .
Paessler PRTG netwerkmonitor
Teams monitoren apparaten, verkeer, servers en services met behulp van kaarten, dashboards en meldingen. PRTG representeert de gemonitorde waarden als sensoren.
Bepaal de benodigde sensoren en meetinstrumenten voor uw dekkingsplan. Zie Paessler PRTG .
ManageEngine OpManager
Organisaties die netwerkapparaten en servers willen ontdekken en hun prestaties willen monitoren. De documentatie beschrijft de ondersteuning voor SNMP, CLI en WMI.
Controleer de protocoltoegang, sjablonen, rolbeheer, add-ons en beheer van externe locaties. Zie OpManager .
Kies met een kleine piloot
Test een representatieve locatie, kritieke service en een mix van apparaten. Test de detectie, nauwkeurigheid van de statistieken, waarschuwingen, onderhoudsafhandeling, rapportage, machtigingen en herstel. Vraag dashboardgebruikers welke context ontbreekt. Een korte pilot laat zien of het platform beter bij uw netwerk past dan een checklist met functies.