Início
» ADMINISTRADOR DE REDE
»
Como configurar o armazenamento de objetos S3 para o ownCloud Infinite Scale
Como configurar o armazenamento de objetos S3 para o ownCloud Infinite Scale
O ownCloud Infinite Scale pode usar armazenamento de objetos compatível com S3 para blobs de arquivos, mantendo os metadados dos arquivos em um sistema de arquivos compatível com POSIX. Essa separação é o primeiro conceito a ser compreendido: o S3 não substitui diretamente todos os diretórios de dados locais. No s3nglayout compatível, o armazenamento de objetos contém o conteúdo binário do arquivo, enquanto os metadados permanecem no armazenamento POSIX, como um sistema de arquivos local ou NFS.
Este guia segue a documentação atual do ownCloud Infinite Scale Storage, disponível em outubro de 2026. Ele foi escrito para administradores que são novos no s3ngdriver e desejam uma configuração fácil de entender antes de adaptá-la ao Docker Compose, systemd, Kubernetes ou outro método de implantação.
O S3 é uma API de armazenamento de objetos originalmente introduzida pela Amazon. Um serviço compatível com S3 armazena dados como objetos dentro de um bucket e expõe operações por meio de APIs baseadas em HTTP. O ownCloud Infinite Scale usa o s3ngdriver de armazenamento para colocar blobs de arquivos em um bucket desse tipo.
O armazenamento POSIX refere-se a um sistema de arquivos que oferece o comportamento esperado pelo Infinite Scale para metadados. Com ele s3ng, os metadados não são movidos para o bucket do S3. O ownCloud documenta explicitamente que os blobs são enviados para o S3, enquanto os metadados permanecem no armazenamento POSIX.
Essa distinção evita um erro comum: apontar o Infinite Scale para um bucket e presumir que todo o estado do servidor agora reside lá. Não reside. Seu plano de backup e recuperação deve abranger tanto os metadados do lado POSIX quanto os blobs do lado S3.
Etapa 1: Prepare o bucket, o armazenamento de metadados, as credenciais e o caminho de rede.
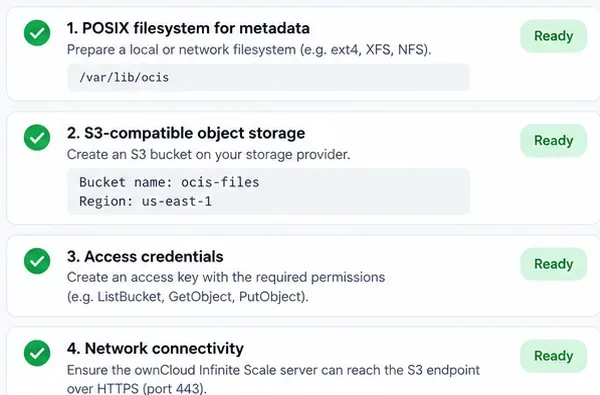
Antes de alterar a Escala Infinita, prepare quatro coisas:
Um bucket S3 dedicado.
Um caminho compatível com POSIX para s3ngmetadados. Para uma implementação com vários nós, o ownCloud recomenda considerar cuidadosamente o armazenamento compartilhado; o NFS é comumente usado quando várias instâncias do Infinite Scale precisam acessar o caminho de metadados.
Uma chave de acesso e uma chave secreta contendo apenas as permissões de bucket exigidas pelo Infinite Scale.
Acessibilidade de rede do host ou contêiner do Infinite Scale ao endpoint S3, normalmente via HTTPS.
Antes de editar a configuração do Infinite Scale, prepare o caminho dos metadados POSIX, o bucket S3, as credenciais e a conectividade de rede.
Não torne o bucket público. O Infinite Scale autentica o acesso ao bucket com credenciais; o acesso público não é necessário nem desejável. Além disso, evite reutilizar uma credencial de administrador genérica quando for possível criar uma identidade de serviço dedicada.
Se você usa o Amazon S3, o endpoint e a região seguem as convenções da AWS. Se você usa outro provedor compatível com o S3, confirme o formato do endpoint, o comportamento da região, os requisitos de TLS e a sintaxe da política na documentação desse provedor. O ownCloud alerta especificamente que comportamentos como detalhes de criptografia podem variar entre os provedores.
Passo 2: Habilite o driver s3ng e forneça as configurações de conexão S3.
A configuração principal de armazenamento é STORAGE_USERS_DRIVER=s3ng. O serviço Storage-Users é o componente do Infinite Scale responsável pelo armazenamento de arquivos do usuário. A configuração oficial também mantém o driver de armazenamento do sistema no ocisbackend normal.
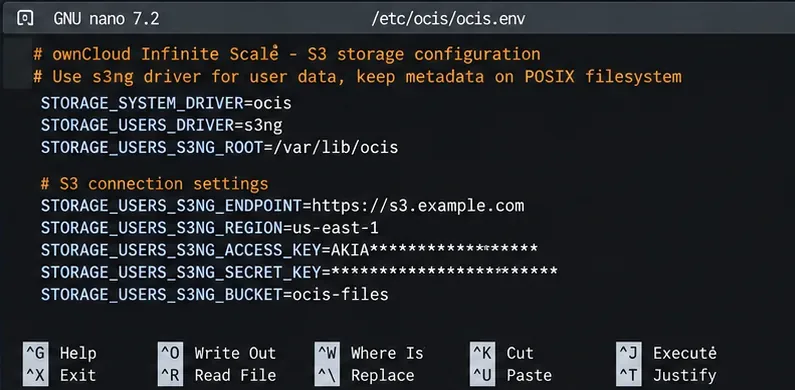
Um conjunto mínimo de variáveis de ambiente tem a seguinte aparência:
As variáveis de ambiente essenciais do s3ng conectam o serviço Storage-Users ao S3, preservando os metadados no armazenamento POSIX.
Os valores de exemplo são apenas marcadores. Use o endpoint, a região, o bucket e as credenciais fornecidas pelo seu provedor. Não inclua a chave secreta em um repositório Git público. Na orquestração de contêineres, prefira o mecanismo de gerenciamento de segredos da plataforma em vez de incorporar as credenciais diretamente em um arquivo Compose ou manifesto.
O método de implantação determina onde essas variáveis serão armazenadas. Uma implantação com Docker Compose pode colocá-las na environmentseção do serviço Infinite Scale ou carregá-las de um arquivo de ambiente. Uma implantação com systemd pode usar um arquivo de ambiente ou uma configuração de unidade. O Kubernetes geralmente as injeta por meio de um Secret e um Deployment ou StatefulSet. Os nomes das variáveis são a parte importante; a sintaxe ao redor depende da sua plataforma.
Etapa 3: Conceda ao bucket as permissões necessárias para o Infinite Scale.
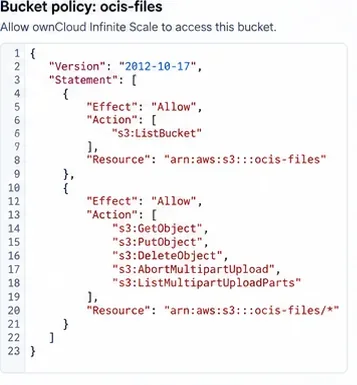
Uma política de bucket é uma regra de Gerenciamento de Identidade e Acesso (IAM) que controla quais ações uma identidade autenticada pode executar em um bucket e seus objetos. O ownCloud publica um padrão de política obrigatório para o s3ngdriver.
Substitua bucket-namena política a seguir pelo nome real do seu bucket:
A estrutura da política deve permitir a listagem de buckets, além das operações de upload de objetos e multipartes exigidas pelo driver s3ng. Utilize a política exata da documentação oficial para sua implementação.
Não resolva um erro de acesso negado concedendo permissões s3:*a todos os buckets da conta. Comece com as permissões documentadas para cada bucket e só adapte quando o seu provedor S3 exigir uma permissão equivalente específica.
Etapa 4: Reinicie o Infinite Scale e verifique o caminho de armazenamento.
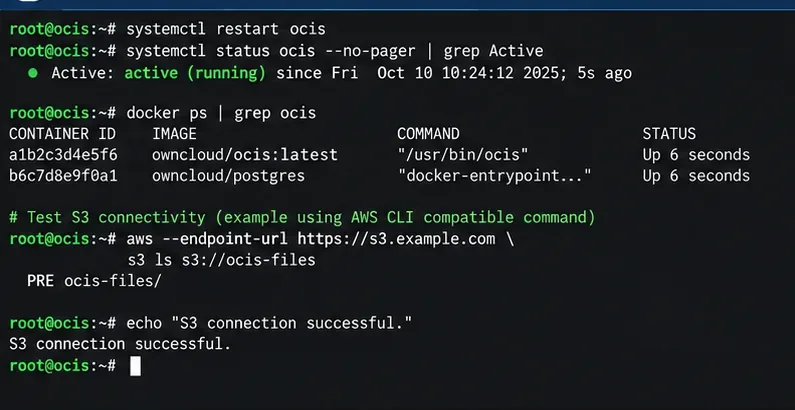
Aplique a configuração usando o procedimento de reinicialização normal para sua implantação. Por exemplo, uma instalação do systemd pode usar o procedimento padrão systemctl restart ocis, enquanto uma implantação do Compose recriaria ou reiniciaria os contêineres de serviço afetados. Verifique os logs imediatamente após a inicialização em busca de erros de autenticação, DNS, TLS, região ou permissões.
Após aplicar a configuração, reinicie os serviços relevantes do Infinite Scale e verifique se o host consegue acessar e autenticar no bucket desejado.
Listar os buckets usando a CLI do seu provedor S3 comprova que o host e as credenciais conseguem acessar o bucket, mas isso por si só não prova que o Infinite Scale está gravando os blobs corretamente. O melhor teste de ponta a ponta é iniciar o Infinite Scale, fazer o upload de um arquivo pequeno pela interface web do ownCloud, baixá-lo novamente e verificar os logs do serviço em busca de erros.
Se a sua versão do Infinite Scale instalada incluir o comando de manutenção do blobstore documentado pelo ownCloud, você também poderá usá-lo ocis storage-users blobstore check. O ownCloud descreve esse comando como uma operação de ida e volta de upload/download/exclusão no blobstore configurado. Consulte a documentação oficial de verificação do blobstore para obter a sintaxe específica da sua versão.
Não espere que os nomes de arquivo originais apareçam como objetos S3 normais.
Um dos equívocos mais comuns é navegar pelo bucket esperando encontrar uma árvore de pastas de usuário familiar, como a de um bucket Documents/report.pdf. O Infinite Scale trata o S3 como um armazenamento de blobs, não como um sistema de arquivos voltado para o usuário. O formato de chave documentado s3ngé baseado em IDs de espaço e IDs de blob, enquanto o namespace legível por humanos é reconstruído a partir de metadados.
Isso significa que você não deve renomear, reorganizar ou excluir objetos manualmente dentro do bucket apenas porque suas chaves parecem desconhecidas. Gerencie os arquivos do usuário por meio do ownCloud. A manipulação direta do bucket pode quebrar a relação entre metadados e blobs.
Envio de arquivos grandes: verifique o tamanho da peça multipartes antes da produção.
O S3 usa o upload multipart para dividir objetos grandes em partes. A documentação do ownCloud STORAGE_USERS_S3NG_PUT_OBJECT_PART_SIZEexplica como controlar o tamanho das partes. O valor padrão documentado é de 16 MiB quando nenhum valor explícito é fornecido.
O Amazon S3 permite no máximo 10.000 partes em um único upload multipart. Com um tamanho de parte de 16 MiB, isso corresponde a aproximadamente 160 GiB antes que o limite de contagem de partes se torne um problema. Se seus usuários costumam enviar arquivos grandes, calcule o tamanho de parte necessário antes da entrada em produção, em vez de esperar que uma transferência grande falhe.
A relação de compromisso é simples: partes maiores suportam arquivos máximos maiores com menos solicitações, mas também alteram as características de memória, buffer, repetição e transferência. O ownCloud também observa que os dados de arquivos recebidos precisam de armazenamento temporário enquanto são armazenados em buffer, portanto, o planejamento de capacidade deve incluir mais do que apenas o bucket remoto.
Problemas comuns e o que verificar primeiro
Sintoma
Área provável
Primeiro verifique
Acesso negado
Política de credenciais ou de acesso restrito
Confirme a chave de acesso, a chave secreta, o ARN do bucket e as ações necessárias.
Balde não encontrado
Nome do bucket, endpoint ou região
Verifique o nome exato do bucket e a combinação de endpoint/região específica do provedor.
Erro de TLS ou certificado
Confiança HTTPS
Confirme se o certificado do endpoint é válido e confiável dentro do host/container do Infinite Scale.
Arquivos pequenos funcionam, mas arquivos muito grandes falham.
Dimensionamento multipartes
Verifique STORAGE_USERS_S3NG_PUT_OBJECT_PART_SIZEos limites de transações múltiplas do seu provedor.
Os arquivos desaparecem após a restauração apenas do S3.
Cópia de segurança incompleta
Restaurar metadados POSIX e blobs S3 como um conjunto de dados consistente.
Faça backup de blobs S3 e metadados POSIX juntos.
Com s3ngo S3, o bucket representa apenas metade do estado de armazenamento. A documentação de backup do ownCloud afirma que uma configuração distribuída do S3 deve incluir configuração, dados do sistema, metadados e blobs. A documentação de restauração também exige que esses conjuntos de dados sejam restaurados de forma consistente.
Para um serviço de produção, documente a montagem de metadados, o bucket, as credenciais ou função, os arquivos de configuração e o procedimento de backup no mesmo manual de procedimentos. Teste a recuperação antes de confiar no projeto. As referências oficiais relevantes são o guia de backup do ownCloud e as considerações sobre restauração .
Ponto de partida recomendado
Para uma primeira implementação, mantenha o design simples: use um bucket S3 dedicado para blobs, um caminho de metadados POSIX persistente, uma identidade de serviço dedicada com as permissões de bucket documentadas, HTTPS para o endpoint de armazenamento de objetos e as configurações multipart padrão, a menos que os tamanhos de arquivo esperados exijam uma alteração.
Após a configuração, valide três camadas separadamente: acesso à rede e às credenciais do bucket, inicialização do Infinite Scale sem erros de armazenamento e um upload/download real através do ownCloud. Assim que essas verificações forem aprovadas, passe para o monitoramento, backups, regras de ciclo de vida e otimização de desempenho. Essa sequência facilita muito a solução de problemas, pois cada teste responde a uma pergunta diferente, em vez de tratar "S3 funciona" como um resultado único e definitivo.