A Matrix Synapse homeserver can look healthy for days and then suddenly leave PostgreSQL consuming most of the machine's available RAM. The usual symptoms are familiar: swap starts growing, client syncs slow down, federation jobs queue up, and an otherwise modest server becomes difficult to administer. The important first step is not to assume that PostgreSQL has a leak. High memory use can come from several independent sources, including the shared buffer cache, per-query work memory, many database backends, maintenance workers, and inefficient queries caused by stale statistics or table churn.
Synapse's own documentation recommends PostgreSQL for production and exposes database connection-pool controls such as cp_min and cp_max. PostgreSQL, meanwhile, warns that settings such as work_mem can be used by multiple operations inside one query and by many sessions at the same time. That combination is why a setting that looks harmless in isolation can become expensive during a busy period. The safest fix is to measure first, reduce unnecessary concurrency second, then tune memory and maintenance behavior only where the evidence points.
Step 1: Confirm that PostgreSQL is really the memory pressure source
Start at the operating-system level. On Linux, compare total memory, available memory, swap, and the largest processes:
free -h
ps aux --sort=-%mem | head -n 15
Do not judge the server from a single process line. PostgreSQL uses shared memory as well as private memory in backend processes, so the useful question is whether the host is actually under pressure: low available memory, growing swap, OOM kills, or sustained latency. Record the numbers during a quiet period and again during a busy period. That baseline makes later changes measurable instead of guesswork.
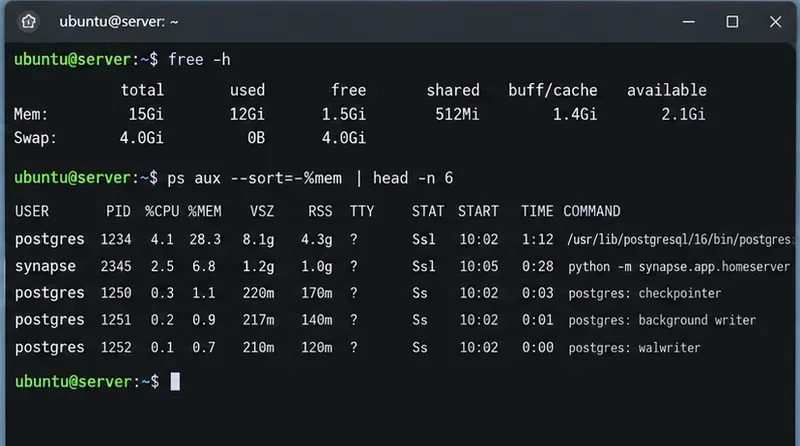
Caption: A first-pass memory check compares host-level available RAM with the PostgreSQL and Synapse processes before any configuration is changed.
Next, inspect the PostgreSQL settings most likely to affect memory:
SHOW shared_buffers;
SHOW work_mem;
SHOW maintenance_work_mem;
SHOW autovacuum_work_mem;
SHOW max_connections;
The PostgreSQL resource-consumption documentation describes the key distinction. shared_buffers is a server-wide shared cache. By contrast, work_mem is a limit for individual sort or hash operations before they spill to temporary files; a complex query can have several such operations, and many sessions can run them concurrently. PostgreSQL currently documents 4 MB as the default work_mem value and notes that total use may be many times that value.
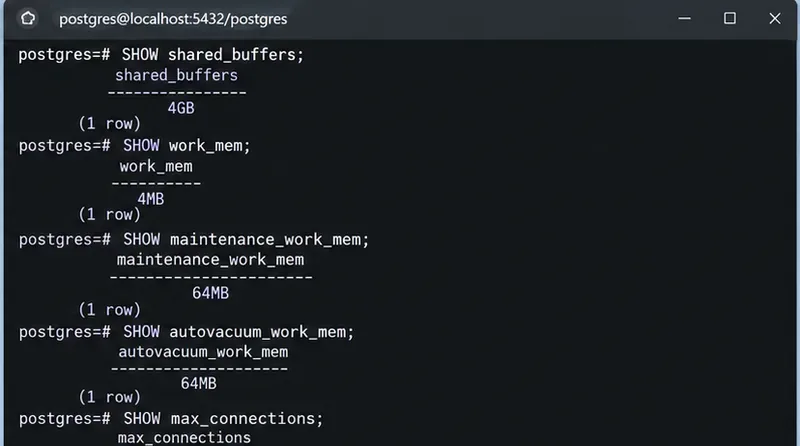
Caption: Read the active PostgreSQL memory-related settings before changing them; the dangerous value is often the combination of settings and concurrency rather than one number alone.
Step 2: Count Synapse database connections and find active work
Um pool de conexões grande não consome memória automaticamente work_mempara cada conexão, pois cada backend do PostgreSQL tem seu próprio processo e memória privada, e mais consultas simultâneas criam mais oportunidades para alocações de memória por operação. Verifique quantas conexões estão realmente abertas e em que estado elas se encontram:
SELECT state,
       usename,
       application_name,
       count(*) AS connections
FROM pg_stat_activity
GROUP BY state, usename, application_name
ORDER BY connections DESC;
Em seguida, inspecione as consultas ativas de longa duração:
SELECT pid,
       usename,
       state,
       now() - query_start AS running_for,
       wait_event_type,
       wait_event,
       left(query, 180) AS query
FROM pg_stat_activity
WHERE state <> 'idle'
ORDER BY query_start;
A documentação oficialpg_stat_activity explica os campos de sessão e atividade. Um grande número de sessões ociosas é diferente de um pequeno número de consultas ativas dispendiosas, portanto, a solução também deve ser diferente. Se o problema for a quantidade de conexões, ajuste o tamanho do pool de endereços. Se o problema for causado por algumas consultas que consomem muita memória, reduzir o tamanho do pool pode apenas mascarar o sintoma.
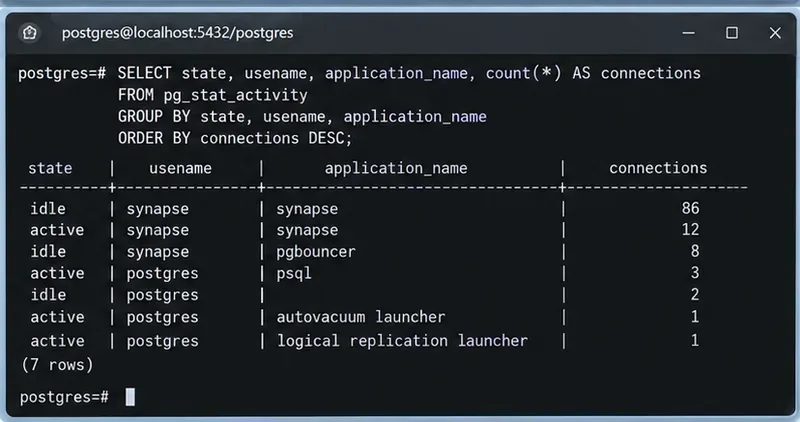
Legenda: O agrupamento pg_stat_activityfacilita a distinção entre vários backends ociosos e um conjunto menor de sessões de banco de dados ativas.
Etapa 3: Dimensionar corretamente o pool de conexões do Synapse PostgreSQL
O Synapse repassa a maioria dos argumentos do banco de dados para o PostgreSQL, enquanto utiliza opções que começam com `--no-share` cp_para seu pool de conexões Twisted. O guia atual do Synapse para PostgreSQL mostra um exemplo com `--no-share` cp_min: 5e ` cp_max: 10--no-share`. Considere esses valores como exemplos, não como um alvo universal.
Verifique o databasebloco em homeserver.yaml:
database:
  name: psycopg2
  args:
    user: synapse_user
    password: "your-secret"
    dbname: synapse
    host: 127.0.0.1
    cp_min: 5
    cp_max: 10
Se você aumentou o número de conexões Synapse cp_maxde forma agressiva anteriormente e pg_stat_activityobservou um grande número de conexões ociosas na maior parte do tempo, reduza-o gradualmente e monitore a latência das requisições. Em uma implementação do Synapse baseada em workers, lembre-se de que a demanda do banco de dados provém de múltiplos processos do Synapse; portanto, avalie o número total de conexões, e não o de um worker isoladamente. O manual de configuração do Synapse confirma que cp_as opções configuram o pool de conexões.
Após editar a configuração, reinicie o(s) processo(s) do Synapse afetado(s) de acordo com o seu método de implantação e, em seguida, execute a consulta de contagem de conexões novamente. Não reduza o pool até que as solicitações comecem a ser enfileiradas apenas para economizar alguns megabytes. Um pool muito pequeno pode transformar a concorrência do banco de dados em latência do aplicativo.
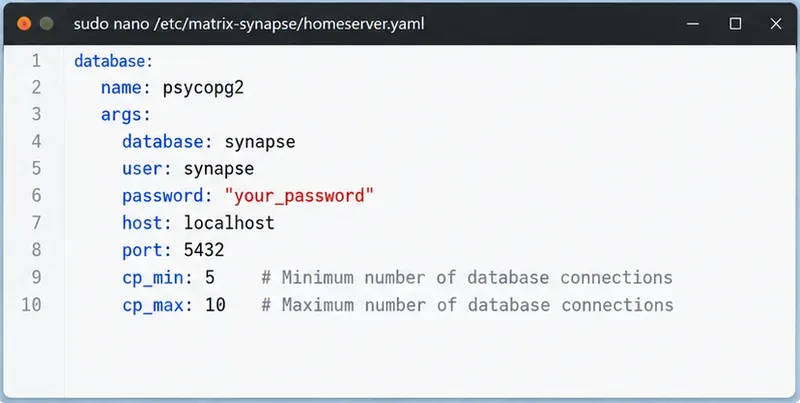
Legenda: O Synapse expõe cp_mina cp_maxconfiguração do banco de dados PostgreSQL, permitindo que os administradores limitem a concorrência desnecessária no backend.
Passo 4: Ajuste a memória do PostgreSQL de forma conservadora.
Assim que o número de conexões estiver em um nível razoável, revise as configurações de memória do PostgreSQL considerando a quantidade de RAM realmente disponível para o banco de dados. O PostgreSQL recomenda que, em um servidor de banco de dados dedicado com pelo menos 1 GB de RAM, cerca de 25% da memória do sistema seja um ponto de partida adequado shared_buffers. Essa recomendação se aplica especificamente a um servidor de banco de dados dedicado. Se o Synapse, o proxy reverso, o Redis, o sistema de monitoramento e o PostgreSQL compartilharem uma única máquina virtual (VM) pequena, o PostgreSQL não terá acesso a toda a máquina, portanto, faça o planejamento de memória de acordo.
A configuração que provavelmente mais surpreenderá os administradores é `max_request_name` work_mem. Evite multiplicar `max_request_name` work_mempor ` max_connectionsmax_request_name` e tratar isso como uma reserva rígida; o PostgreSQL não pré-aloca memória dessa forma. Em vez disso, pense em termos de operações de consulta simultâneas. Uma única consulta pode usar vários nós de classificação ou hash, e as operações de hash podem usar um múltiplo de `max_request_name` work_mem. Se você definir `max_request_name` work_mempara um número muito grande globalmente porque um relatório estava lento, um pico de uso de memória durante uma federação ou um período com muitas sincronizações pode produzir um pico de memória muito maior do que o esperado.
Uma prática sensata é manter o valor global conservador e aumentá-lo apenas para uma sessão administrativa específica, quando uma consulta conhecida se beneficiar de mais memória. Antes de alterar os valores, preserve sua configuração existente e observe quais parâmetros exigem a reinicialização do PostgreSQL. shared_buffersPor exemplo, `--server-start` é uma configuração de inicialização do servidor. As alterações devem ser agendadas para que você possa comparar o comportamento da memória, da latência e dos arquivos temporários antes e depois da reinicialização.
Verifique também o PostgreSQL maintenance_work_meme autovacuum_work_memo PostgreSQL observa que os processos de autovacuum podem alocar memória de manutenção simultaneamente. Se autovacuum_work_memo comportamento herdado do autovacuum for mantido, um valor excepcionalmente grande de maintenance_work_mem`max_main_memory` pode tornar a execução simultânea de vários processos de autovacuum custosa. Não desabilite o autovacuum para economizar RAM; isso geralmente resulta em um problema de memória a curto prazo, mas também em inchaço de tabelas, estatísticas desatualizadas e pior desempenho.
Etapa 5: Verifique o funcionamento do vácuo e, em seguida, confirme a correção sob carga real.
O Synapse grava e atualiza grandes quantidades de dados de eventos e estados. O PostgreSQL precisa de limpeza rotineira (vacuum) para recuperar tuplas inativas para reutilização e para manter as estatísticas do planejador atualizadas. O guia de limpeza rotineira do PostgreSQL recomenda o uso do autovacuum na maioria das instalações.
Procure por tabelas com muitas tuplas mortas estimadas ou registros de manutenção desatualizados:
SELECT relname,
       n_live_tup,
       n_dead_tup,
       last_autovacuum,
       last_autoanalyze
FROM pg_stat_user_tables
ORDER BY n_dead_tup DESC
LIMIT 20;
Se uma tabela específica claramente precisa de atenção, um verificador VACUUM (ANALYZE)manual de tabelas geralmente é a primeira ferramenta a ser considerada:
VACUUM (ANALYZE) your_table_name;
Evite usar o VACUUM diretamente VACUUM FULL. A documentação oficial do VACUUM explica que o VACUUM regular VACUUMpode ser executado em conjunto com leituras e gravações normais, enquanto VACUUM FULLo VACUUM reescreve a tabela e bloqueia o ACCESS EXCLUSIVEdisco. Use o VACUUM somente quando a recuperação de espaço em disco justificar a interrupção planejada.
Como saber se a mudança realmente funcionou
Verifique o resultado com o mesmo tipo de carga de trabalho que causou o problema. Uma correção bem-sucedida não significa simplesmente que "o Postgres usa menos RAM imediatamente". Os caches do banco de dados devem usar memória. Em vez disso, procure por memória disponível estável, crescimento inesperado mínimo ou inexistente do swap, ausência de eventos de falta de memória (OOM), uma contagem de conexões que corresponda à concorrência esperada e tempos de resposta aceitáveis do Synapse.
- Execute o comando
free -he a lista de processos no mesmo nível de tráfego usado para sua linha de base.
- Repita a
pg_stat_activityconsulta de conexão e confirme se a contagem de backends ociosos diminuiu após a alteração do pool do Synapse.
- Monitore a latência de consulta e sincronização após a redução
cp_max; reverta a alteração se o tempo de espera do banco de dados aumentar consideravelmente.
- Verifique
pg_stat_user_tablesperiodicamente se o aspirador automático está realmente passando pelas mesas mais utilizadas.
- Se você reduziu o valor
work_mem, monitore se as operações de classificação grandes agora estão sendo executadas excessivamente em arquivos temporários antes de reduzi-lo ainda mais.
Se o PostgreSQL continuar a crescer até que o host utilize muita memória virtual após essas verificações, capture a lista de consultas ativas durante o pico e investigue a carga de trabalho em vez de reduzir repetidamente os limites globais de memória. Em versões compatíveis do PostgreSQL, pg_backend_memory_contextsé possível inspecionar os contextos de memória do backend atual; a documentação da visão do sistema do PostgreSQL descreve a visão e suas permissões. Isso é mais útil para uma investigação focada no banco de dados do que presumir que toda implementação do Synapse com alta demanda de memória tenha a mesma causa.
Resumindo
Para o Matrix Synapse no PostgreSQL, o alto consumo de memória do banco de dados é melhor corrigido em camadas: comprove que o host está sob pressão real de memória, conte as sessões do banco de dados, dimensione corretamente o pool do Synapse, mantenha o uso de memória por operação do PostgreSQL conservador e assegure-se de que o autovacuum esteja funcionando corretamente. O objetivo não é a menor pegada de memória possível no PostgreSQL. O objetivo é um uso de memória previsível, sem transformar o cache e a concorrência normais do banco de dados em swap evitável, eventos de falta de memória (OOM) ou clientes Matrix lentos.









