How to Fix Matrix Synapse Running Out of Memory During Sync
As of October 6, 2026, the latest stable Matrix Synapse release is 1.162.0, published on September 29, 2026. If your homeserver is running out of memory during client synchronization, upgrading to a current supported release is a sensible first check, but the durable fix is usually operational rather than a single magic setting. Synapse intentionally keeps recent room data and metadata in memory to make common requests faster, and the official administrator documentation warns that reducing caches too aggressively can actually make memory pressure worse by creating a backlog of slow requests.
This guide follows the path a new administrator can use safely: understand what “sync” means, confirm that the process is really hitting a memory limit, reduce avoidable cache pressure, separate unusually heavy initial-sync traffic when needed, and monitor the result. The goal is not simply to make the resident set size smaller. The goal is to stop out-of-memory crashes while keeping the homeserver responsive.
What “sync” means in Matrix Synapse
A Matrix client repeatedly calls the Client-Server API /_matrix/client/v3/sync to receive new events such as messages, room state, account data, presence information, and device updates. A normal ongoing sync usually includes a since token so Synapse only needs to return changes after the previous synchronization point.
An initial sync is different. It is the first synchronization for a device or session and does not have a previous since token. The official Synapse worker documentation describes these requests as potentially very resource intensive. On larger homeservers, Synapse supports routing initial sync separately from ongoing sync so a few expensive first-time synchronizations do not disrupt everybody else.
Record your Synapse version and installation method.
Back up homeserver.yaml, worker configuration files, reverse-proxy configuration, and the PostgreSQL database according to your normal backup procedure.
Note whether Synapse runs as one process, in containers, or as a main process plus workers.
Find the actual memory limit. A container, systemd unit, Kubernetes pod, or VM may have a lower limit than the physical server.
Confirm that PostgreSQL is in use for production. Current Synapse installation documentation says SQLite is for testing and performs poorly for production workloads, especially around large rooms.
Step 1: Confirm that memory exhaustion is the real failure
Do not start by changing cache values. First identify which Synapse process is consuming memory and whether it is killed by the operating system or by a container limit.
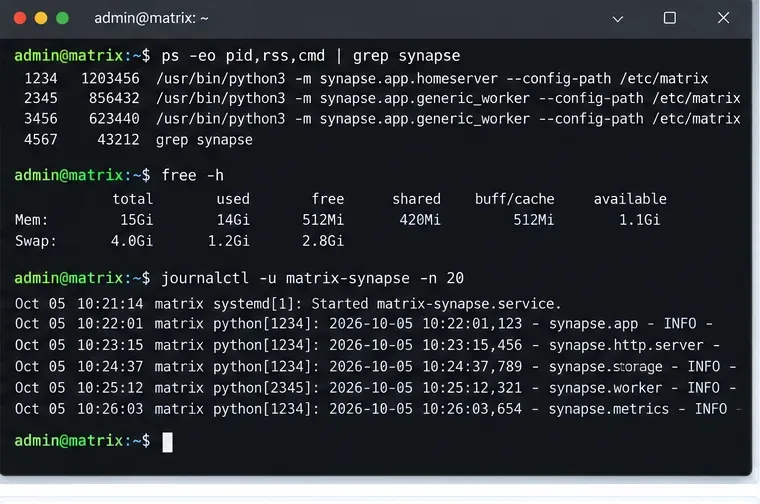
Start with process RSS, available memory, swap pressure, and recent Synapse service logs so you know whether the problem is true memory exhaustion or a different sync failure.
On a Linux host, commands such as the following provide a quick first view:
If you use Docker, Podman, Kubernetes, or another scheduler, inspect the container or pod memory limit as well. A host with several gigabytes free can still kill Synapse if the process is restricted to a much smaller cgroup limit.
Look for a repeatable pattern. Does memory climb only when a specific user signs in on a new device? Does it increase gradually all day? Does one generic worker grow while the main process stays stable? Those observations distinguish an initial-sync spike from general cache growth or request backlog.
Step 2: Check the cache settings before lowering them
A cache is data Synapse keeps in RAM so it does not need to recompute or reload the same information repeatedly. Synapse has many caches, plus an event cache. The configuration reference currently documents a default caches.global_factor of 0.5, an event_cache_size default of 10K before the global factor is applied, time-based cache expiry, and a sync_response_cache_duration default of 2 minutes.
The tempting fix is to set the global factor as low as possible. Do not do that blindly. The Synapse administrator FAQ explicitly warns that too small a cache can make a slow system even slower, allowing requests to pile up and causing memory use to explode from backlog instead of cache entries.
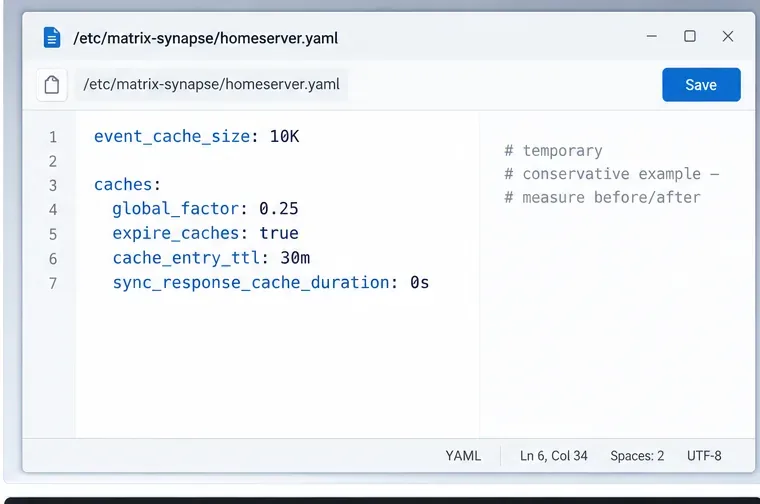
Make cache changes conservatively and measure the result; the example illustrates where the relevant settings live rather than a universal production value.
If profiling shows that cache memory is genuinely the dominant consumer and request throughput remains healthy, try a modest reduction rather than a drastic one. For example:
This is a troubleshooting example, not a recommended value for every server. Setting sync_response_cache_duration to zero disables caching of completed /sync responses. That can save memory when many sync responses are being retained, but it may make reconnecting clients do more work. Test it under your actual workload.
Synapse also provides cache autotuning with max_cache_memory_usage, target_cache_memory_usage, and min_cache_ttl. The official documentation says this feature requires jemalloc, an alternative memory allocator, and all three settings must be supplied. Do not enable only one or two values; the documentation warns that incomplete configuration can cause unstable behavior.
Step 3: Make sure the database is not creating a request backlog
Problemas de memória durante a sincronização nem sempre são causados pela quantidade de dados em cache. Um banco de dados lento pode manter muitas solicitações ativas simultaneamente, e cada solicitação em andamento consome memória. É por isso que reduzir o tamanho do cache pode ser contraproducente em um armazenamento que já é lento.
Para produção, siga o guia oficial do Synapse PostgreSQL . Verifique o uso da CPU do banco de dados, a latência de armazenamento, a saturação de conexões, as consultas de longa duração e se o próprio servidor PostgreSQL está usando swap. Se a latência de sincronização aumentar ao mesmo tempo que a memória residente, investigue o backlog antes de reduzir os caches novamente.
Se você migrou recentemente para salas públicas grandes, federou-se em comunidades muito maiores ou adicionou muitos usuários ativos, a carga de trabalho pode simplesmente ter ultrapassado a configuração que funcionava anteriormente. Nesse caso, o ajuste do banco de dados e o isolamento de nós de trabalho geralmente são mais importantes do que reduzir um pouco o tamanho de um único cache.
Etapa 4: Isolar a sincronização inicial em servidores domésticos maiores
O Synapse pode ser executado como um único processo monolítico , ou seja, um único processo principal de servidor doméstico, ou pode dividir o trabalho em processos auxiliares (workers) , que são processos adicionais do Synapse compartilhando o mesmo banco de dados PostgreSQL. O modelo de processos auxiliares é destinado a instalações maiores que precisam escalar cargas de trabalho individuais de forma independente.
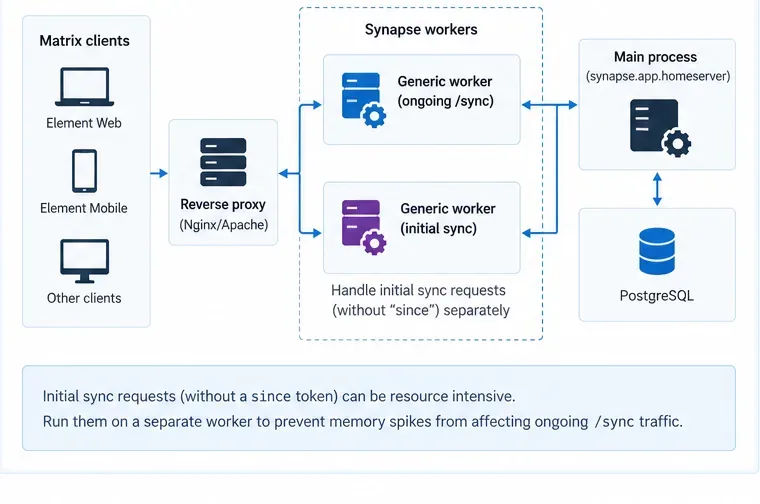
Em implantações maiores com suporte a PostgreSQL, direcione a sincronização inicial, que costuma ser custosa, separadamente da sincronização contínua, para que o primeiro login não consuma o mesmo pool de workers que as atualizações normais do cliente.
A documentação do worker afirma que um worker genérico pode lidar com solicitações de sincronização /synce de sincronização /initialSync. Também recomenda considerar o tratamento separado para solicitações de sincronização sem sinceparâmetro, pois essas solicitações de sincronização inicial podem consumir muitos recursos.
Uma arquitetura prática é:
O proxy reverso recebe o tráfego do cliente Matrix.
As solicitações em andamento /syncsão encaminhadas para um ou mais trabalhadores genéricos.
As solicitações de sincronização iniciais são encaminhadas para um grupo de trabalhadores genéricos separado.
O processo principal continua a lidar com as responsabilidades que não foram delegadas.
Todos os processos do Synapse compartilham o PostgreSQL.
Não exponha o listener de replicação do Synapse à internet pública. A documentação atual do worker alerta que o tráfego de replicação não é criptografado nem autenticado, a menos que um segredo de replicação seja configurado.
Para um servidor doméstico pequeno, adicionar workers não é a melhor opção inicial. As próprias diretrizes da Synapse recomendam o modo monolítico para instâncias menores. Adicione workers somente quando houver evidências de que uma determinada carga de trabalho precisa de isolamento ou escalonamento horizontal.
Passo 5: Recarregue os fatores de cache com segurança e observe o resultado.
O Synapse permite que os fatores de cache sejam recarregados com SIGHUP. A referência de configuração fornece este exemplo:
kill -HUP PID_OF_SYNAPSE_PROCESS
Se o serviço systemd incluído suportar, systemctl reload matrix-synapsepoderá executar a mesma operação. Em uma implantação com vários nós workers, a documentação oficial indica que a configuração relevante de cada worker deve ser atualizada e que cada worker deve receber o sinal de recarregamento individualmente.
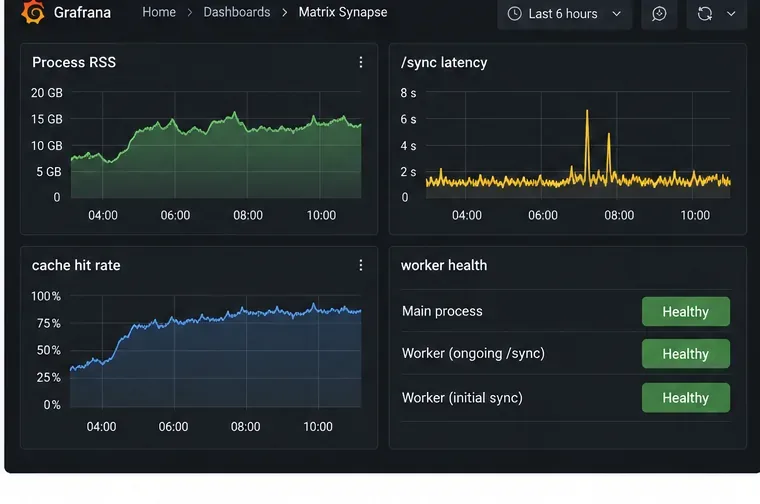
Após cada alteração, aguarde tempo suficiente para que o servidor atinja um padrão de tráfego normal. Monitore simultaneamente a memória residente, a latência das requisições, a carga do banco de dados e a integridade dos processos ativos. Um gráfico de memória que cai enquanto a latência de sincronização dobra indica que a correção não foi bem-sucedida.
Etapa 6: Habilite as métricas do Prometheus para diagnósticos repetíveis.
Para qualquer coisa além de um incidente isolado, ative as métricas do Synapse e colete-as com o Prometheus. Consulte o guia oficial de monitoramento enable_metrics: truee configure um listener de métricas interno dedicado. Mantenha o endpoint de métricas em uma interface interna ou proteja-o no proxy reverso; ele não deve ser exposto desnecessariamente.
Monitore a memória e a latência de sincronização simultaneamente. O resultado útil é uma memória estável com tempo de resposta aceitável, e não o menor valor de RSS possível.
Utilize o guia oficial de monitoramento do Synapse Prometheus para a sintaxe atual do listener. Em implantações com workers, monitore cada worker separadamente, pois as métricas dos workers não são agregadas automaticamente ao processo principal.
Erros comuns a evitar
Reduza o valor de SYNAPSE_CACHE_FACTOR até que o servidor fique mais lento.
Um cache menor usa menos memória por entrada, mas aumenta o trabalho de banco de dados e computação. Se esse trabalho extra criar uma fila de solicitações incompletas, o uso total de memória pode aumentar em vez de diminuir. Reduza esse fator em pequenos passos e sempre monitore a latência.
Supondo que cada solicitação /sync tenha o mesmo custo.
Uma sincronização contínua com sincetoken e uma sincronização inicial sem token apresentam perfis de recursos muito diferentes. Separe-as no seu diagnóstico antes de dimensionar todo o servidor.
Utilizando workers enquanto ainda se está no SQLite
Os workers do Synapse compartilham um banco de dados PostgreSQL. A documentação do worker afirma que o SQLite é para uso em demonstrações ou testes e não é a base para uma implantação de produção baseada em workers.
Utilizando a troca como solução principal
Uma pequena quantidade de swap pode evitar o encerramento abrupto de um processo, mas o uso excessivo de swap torna a sincronização drasticamente mais lenta e pode criar o mesmo ciclo vicioso de backlog. Considere o swap como uma proteção contra um pico de demanda momentâneo, e não como um mecanismo de planejamento de capacidade.
Alterar várias configurações de memória simultaneamente
Se você reduzir os caches, alterar o roteamento dos workers, modificar as configurações do PostgreSQL e aumentar o limite de um contêiner simultaneamente, não saberá qual alteração resolveu o problema. Faça uma alteração controlada por vez e compare as mesmas métricas.
Um caminho prático para a tomada de decisões
O que você observa
Próxima ação provável
O consumo de memória aumenta repentinamente quando os usuários fazem login em novos dispositivos.
Identifique a sincronização inicial e considere isolá-la em um nó de trabalho para implantações maiores.
O consumo de memória aumenta de forma constante enquanto a taxa de acertos no cache é alta e a latência é normal.
Reduza a capacidade do cache de forma conservadora e teste novamente.
A latência de memória e sincronização aumentam simultaneamente.
Investigue o acúmulo de dados no banco de dados ou no armazenamento antes de reduzir ainda mais os caches.
Apenas um trabalhador atinge seu limite.
Ajuste o orçamento de memória desse trabalhador ou dimensione esse grupo de trabalhadores em vez de todo o servidor doméstico.
O host tem RAM livre, mas o Synapse foi encerrado.
Inspecione os limites de memória do contêiner, cgroup, systemd ou Kubernetes.
Lista de verificação final
Execute uma versão atual e compatível do Synapse; a versão 1.162.0 é a versão estável mais recente, em 6 de outubro de 2026.
Utilize PostgreSQL para produção.
Confirme qual processo está realmente consumindo RSS e qual limite de memória se aplica a ele.
Diferencie a sincronização incremental normal da sincronização inicial.
Mantenha o recurso de expiração de cache ativado e ajuste os fatores de cache gradualmente.
Não habilite o ajuste automático de cache a menos que o jemalloc esteja em uso e todos os valores necessários estejam configurados.
Para implantações maiores, isole a sincronização inicial ou adicione processos de sincronização genéricos quando as métricas justificarem.
Monitore a memória e a latência simultaneamente após cada alteração.
O Synapse consome muita memória propositalmente, pois o cache faz parte de sua estratégia de desempenho. A solução correta para falhas de falta de memória (OOM) relacionadas à sincronização, portanto, é um equilíbrio: remover a retenção desnecessária de cache, eliminar o backlog do banco de dados ou das requisições e isolar cargas de trabalho excepcionais sem sobrecarregar os caches que mantêm a sincronização normal rápida. Essa abordagem é mais confiável do que tratar o maior número de RSS como o problema em si.