If a SUSE Linux server appears to hang during reboot at a systemd shutdown message, the most useful first assumption is not that the reboot command itself is broken. In most cases, systemd is waiting for a unit, mount, process, or shutdown hook to finish. The safest fix is therefore to identify the exact job that is still running, inspect why it does not stop, and correct that component rather than globally shortening shutdown timeouts.
This guide uses a hypothetical example throughout: a server named lab-sles01 runs SUSE Linux Enterprise Server and pauses during reboot with a message similar to A stop job is running for backup.service. The example is only an illustration of the diagnostic method; it is not a report of a real test or a claim that a particular SUSE release has a defect in a service named backup.service.
The four-step fix in brief
| Step | What to do | What you are trying to learn |
|---|
| 1 | Record the exact shutdown message | Which unit or stage is blocking progress |
| 2 | Review the previous boot journal | Whether the stop timed out, an unmount failed, or shutdown reached a later stage |
| 3 | Inspect the blocking unit and live jobs | Whether a service, mount, inhibitor, or dependency is responsible |
| 4 | Fix the root cause and retest | Whether a normal systemctl reboot now completes without delay |
Step 1: Record exactly where shutdown stops
Watch the local console, virtual machine console, BMC/IPMI console, or hypervisor console during a planned reboot. A line naming a unit is far more useful than a general description such as “systemd froze.” For the hypothetical lab-sles01, suppose the console shows that backup.service is still stopping while other units have already shut down.
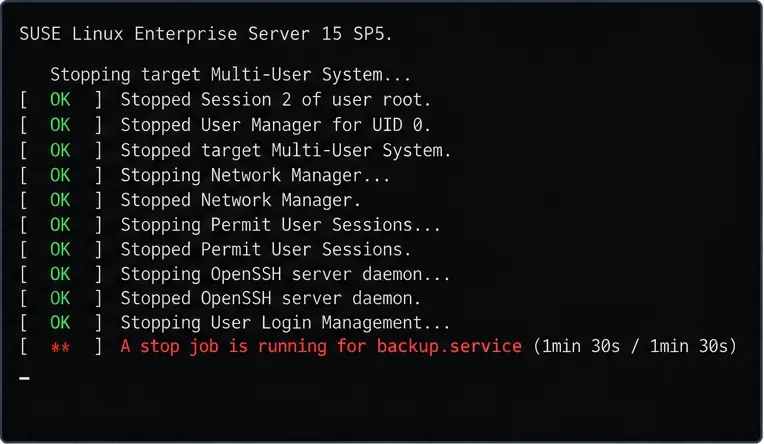
Illustrative example: the shutdown console identifies backup.service as the unit systemd is still waiting for.
If the console instead names a .mount unit, a network file system, a device, or another service, follow that name rather than applying a generic service timeout. The unit shown at the bottom of the console is a clue, not automatically the root cause: it may itself be waiting on a child process, storage, network I/O, or another dependency.
SUSE's current systemd guidance notes that a long reboot or poweroff can be caused by a service that is not exiting and recommends checking systemd jobs. See SUSE Linux Enterprise Server 16.0: Introduction to systemd Basics.
Step 2: Use the previous boot journal after the server returns
After the machine boots again, inspect the shutdown that just happened. SUSE documents boot offsets in the journal: boot 0 is the current boot, -1 is the previous boot, and so on. Start with:
sudo journalctl --list-boots
sudo journalctl -b -1
Para um periódico extenso, a ordem inversa pode revelar as últimas mensagens mais rapidamente:
sudo journalctl -b -1 -r
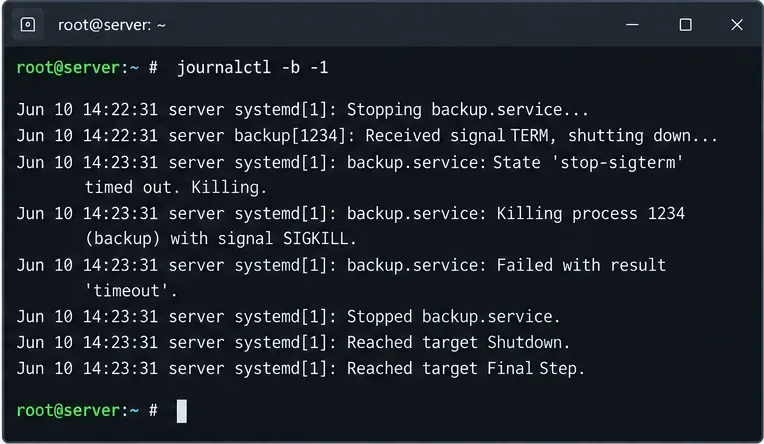
Exemplo ilustrativo: o registro de inicialização anterior mostra o hipotético serviço de backup recebendo SIGTERM e posteriormente atingindo o tempo limite.
Procure por frases como Stopping, stop job, timed out, Failed with result, Unmounting, Dependency failed, ou mensagens do próprio serviço suspeito. Você pode refinar a busca assim que souber o nome da unidade:
sudo journalctl -b -1 -u backup.service
A SUSE documenta journalctl -b -1a análise de inicializações anteriores em sua documentação do journal do SLES 15 SP7 . Se journalctl --list-bootso journal não contiver a inicialização anterior, não tire conclusões precipitadas com base na ausência do histórico; verifique como o armazenamento do journald está configurado e use o console ou o registro remoto para a próxima reprodução.
Etapa 3: Identifique se o bloqueador é um serviço, um ponto de montagem, um inibidor ou um gancho de desligamento tardio.
Se você conseguir reproduzir o problema durante uma janela de manutenção, mantenha um segundo console administrativo disponível. Antes que a conectividade seja perdida, execute o seguinte comando:
sudo systemctl list-jobs
sudo systemctl status backup.service
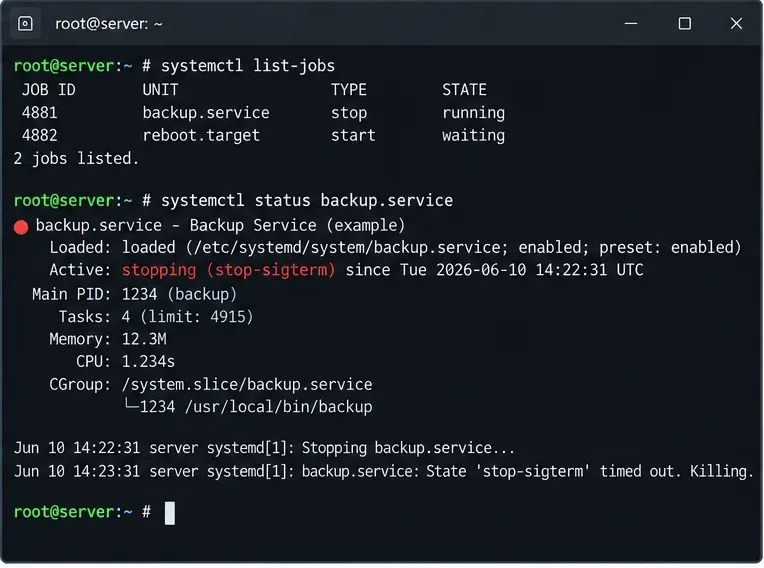
Exemplo ilustrativo: backup.servicepossui uma tarefa de parada em execução enquanto o alvo de reinicialização aguarda em segundo plano.
As diretrizes de depuração do systemd explicam que as tarefas exibidas como `none` runningdevem ser concluídas antes que as tarefas dependentes exibidas como `none` waitingpossam prosseguir. A SUSE também recomenda o uso de `none` systemctl list-jobsquando o desligamento ou a reinicialização demoram muito. Isso torna este comando particularmente útil quando o servidor não está totalmente congelado e o PID 1 ainda está respondendo.
Se um serviço estiver parando muito lentamente
Inspecione a definição da unidade e seu comportamento de desligamento:
sudo systemctl cat backup.service
sudo systemctl status backup.service
sudo journalctl -u backup.service -b
Verifique se o serviço possui alguma ExecStop=ação em andamento, se o processo dele está lidando com o sinal SIGTERM e se ele está aguardando recursos de armazenamento ou de rede. Um banco de dados, um agente de backup ou um serviço de middleware pode realmente precisar de tempo para liberar os dados, portanto, encerrá-lo antes não resolve o problema automaticamente.
Se houver uma montagem ou um sistema de arquivos de rede envolvido
Procure por operações de desmontagem com falha e identifique a origem da montagem:
findmnt
systemctl list-units --type=mount
sudo journalctl -b -1 | grep -Ei 'unmount|umount|mount|nfs|cifs'
Para NFS ou CIFS, investigue a acessibilidade do servidor, sessões obsoletas e se as opções de montagem atendem aos requisitos de desligamento do servidor. Se a unidade bloqueada for gerada a partir de /etc/fstab, corrija a configuração de montagem em vez de aplicar um tempo limite específico do serviço a uma unidade não relacionada.
Se a solicitação de reinicialização estiver sendo inibida
Antes do início do desligamento, você pode listar os inibidores do systemd ativos:
systemd-inhibit --list
Os bloqueios de inibição podem bloquear ou atrasar solicitações de desligamento enquanto um aplicativo está executando tarefas que não devem ser interrompidas. Eles são mais relevantes quando a própria solicitação de reinicialização é atrasada antes que o sistema entre na sequência final de desligamento. Consulte o manual do systemd-inhibit .
Se o travamento ocorrer depois que os serviços já estiverem inativos, isso acontecerá se o serviço já estiver desligado.
Uma paralisação em um estágio posterior exige uma investigação diferente. O systemd executa arquivos executáveis /usr/lib/systemd/system-shutdown/pouco antes da reinicialização ou desligamento final e aguarda a conclusão deles. Se o journal e o console mostrarem que os serviços comuns já foram interrompidos e a paralisação ocorrer no estágio final de desligamento, revise esse diretório e quaisquer hooks instalados pelo fornecedor. A documentação do serviço de desligamento do systemd descreve esse comportamento.
Passo 4: Conserte o componente e, em seguida, teste uma reinicialização normal.
Voltando ao exemplo hipotético lab-sles01, suponha que os logs mostrem que o serviço backup.serviceignora o encerramento normal após a conclusão do processo de backup. A primeira opção é corrigir o serviço ou o comando de parada. Se for sabido que o serviço pode ser encerrado com segurança após um período limitado, uma configuração específica do systemd por unidade pode limitar o tempo de espera do systemd.
Crie uma substituição em vez de editar uma unidade de fornecedor em /usr/lib/systemd/system:
sudo systemctl edit backup.service
Por exemplo:
[Service]
TimeoutStopSec=30s
Em seguida, recarregue a configuração da unidade do systemd:
sudo systemctl daemon-reload
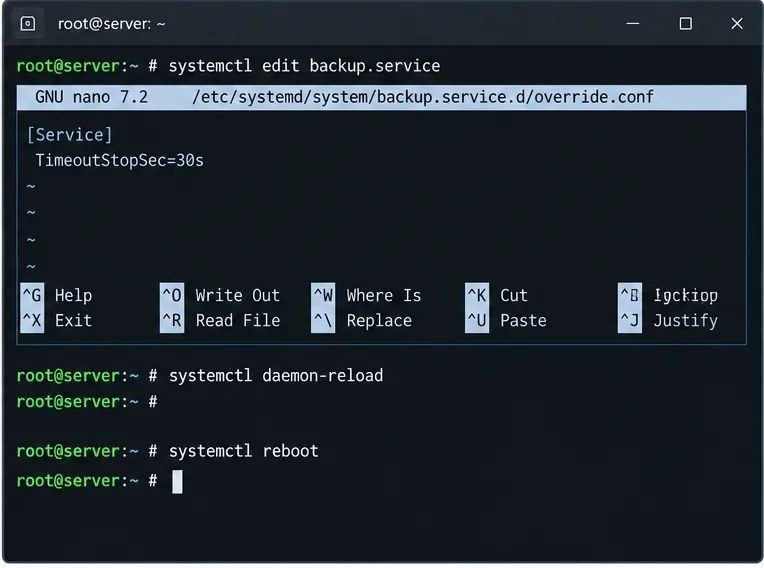
Exemplo ilustrativo: um tempo limite por serviço é aplicado somente depois que o serviço hipotético for identificado como o bloqueador.
Não copie o valor de 30 segundos cegamente. O tempo limite correto depende do que o serviço real precisa concluir com segurança. Reduzir esse tempo limite para um banco de dados, daemon de armazenamento, serviço em cluster ou processo de backup pode interromper a limpeza legítima. Um tempo limite é uma medida de segurança, não um substituto para corrigir uma ExecStop=ação com falha ou um aplicativo que não seja encerrado corretamente.
Quando estiver satisfeito com a alteração, teste uma reinicialização normal:
sudo systemctl reboot
Após o computador reiniciar, revise novamente a inicialização anterior e confirme se a unidade foi desativada corretamente, em vez de simplesmente desaparecer do console.
Quando você deve usar uma reinicialização forçada?
Uma reinicialização forçada é uma opção de recuperação, não uma estratégia de solução de problemas. A documentação oficial do systemd afirma que essa opção --forceignora systemctl rebooto desligamento normal do serviço, mas ainda encerra processos e tenta desmontar ou remontar sistemas de arquivos em modo somente leitura. Fornecer essa opção --forceduas vezes é mais perigoso, pois pode causar uma reinicialização sem encerrar processos ou desmontar sistemas de arquivos, com risco de perda de dados.
Se o servidor já estiver travado e não houver uma maneira mais segura de restabelecer o serviço, uma reinicialização forçada pode ser justificada de acordo com seus procedimentos operacionais:
sudo systemctl reboot --force
Evite tratar systemctl reboot --force --forceum ciclo de energia virtual ou uma reinicialização física como uma solução normal. Essas ações podem remover as evidências necessárias e colocar em risco as gravações em andamento. A documentação do systemctl distingue explicitamente os comportamentos de força simples e dupla.
E se cada reinicialização travar e você não conseguir solucionar o problema no modo normal?
Use um console de manutenção e inicialize no modo de recuperação. A SUSE documenta a adição de systemd.unit=rescue.targetcomandos à linha de comando do kernel a partir do editor GRUB. O modo de recuperação fornece uma sessão root com acesso aos sistemas de arquivos locais e serviços essenciais, mantendo a rede inativa, o que pode ajudar a desativar ou reparar o serviço ou a configuração de montagem com problemas.
Consulte o Guia de Administração do SLES 15 SP7 para obter o procedimento oficial do modo de recuperação. Em sistemas onde o problema aparece somente após uma alteração específica em um pacote, kernel, driver ou armazenamento, revise também o histórico de manutenção relevante do SUSE antes de fazer alterações permanentes no tempo limite.
Tabela de decisão rápida
| O que você vê | Área provável para inspeção | Melhor próxima ação |
|---|
A stop job is running for xyz.service | caminho de desligamento do serviço | Verifique systemctl statuso arquivo da unidade e o diário de serviço. |
| Mensagens repetidas de desmontagem ou de sistema de arquivos remoto | Montagem, NFS, CIFS, armazenamento | Verifique findmnt, monte as unidades /etc/fstabe a acessibilidade do servidor. |
| A solicitação de reinicialização foi recusada ou atrasada antes do desligamento. | Inibidor ou outro trabalho do sistema | Corra systemd-inhibit --listesystemctl list-jobs |
| Os serviços são interrompidos, mas o desligamento final nunca é concluído. | Gancho de desligamento tardio, kernel, driver, armazenamento | Analise o diário de inicialização anterior e/usr/lib/systemd/system-shutdown/ |
| A inicialização normal torna o reparo impossível | Falha persistente na configuração ou na unidade | Inicializar comsystemd.unit=rescue.target |
Resumindo
Para um servidor SUSE Linux travado durante o desligamento do systemd, a solução definitiva é identificar a tarefa que o systemd está aguardando e corrigir essa unidade ou sua dependência. Registre a mensagem de desligamento, inspecione o arquivo de configuração journalctl -b -1, use as opções `--systemd-timeout` systemctl list-jobse `--systemd-timeout` systemctl statuspara isolar o bloqueador e, somente então, altere o tempo limite de cada serviço ou a configuração de montagem. Reserve os métodos de reinicialização forçada para situações de recuperação, não para operações de rotina.






