Acasă
» ADMIN. REȚEA
»
Cele mai bune practici de monitorizare a rețelei: Ce să urmăriți și ce instrumente să utilizați
Cele mai bune practici de monitorizare a rețelei: Ce să urmăriți și ce instrumente să utilizați
Monitorizarea eficientă a rețelei începe cu un inventar verificat, valori de măsurare axate pe servicii și alerte acționabile. Cartografiați dispozitivele și serviciile critice, stabiliți performanța normală, apoi alegeți o platformă care să vă susțină infrastructura și să poată fi întreținută de echipa dvs. Acest lucru ajută la evidențierea problemelor în curs de dezvoltare, fără a transforma fiecare fluctuație scurtă într-o simplă pagină.
Ce ar trebui să vă spună monitorizarea rețelei
Monitorizarea rețelei urmărește dacă dispozitivele și serviciile sunt accesibile și cum performează acestea în timp. De obicei, aceasta acoperă starea dispozitivelor și a interfeței, traficul, resursele serverului și verificările serviciilor. Jurnalizarea de securitate are o funcție diferită: un NMS explică disponibilitatea și performanța, în timp ce jurnalele centralizate sau un SIEM ajută la investigarea evenimentelor precum conectările suspecte și modificările de configurație. Multe echipe folosesc ambele. NIST prezintă monitorizarea continuă ca o conștientizare continuă a deciziilor privind riscurile; revizuiește acoperirea rețelei pe măsură ce mediul se schimbă.
Cele mai bune practici de monitorizare a rețelei
1. Creați un inventar înainte de a seta alerte
Enumerați routerele, switch-urile, firewall-urile, echipamentele wireless, serverele critice, legăturile cloud și serviciile orientate către clienți. Pentru fiecare, înregistrați locația, proprietarul, prioritatea afacerii, adresa de administrare și dependențele. Utilizați funcția Discovery pentru a alimenta inventarul, apoi verificați-l și adăugați dispozitivele care nu pot fi găsite automat. Grupați după site sau serviciu. Actualizați lista după modificări, astfel încât acoperirea să rămână completă.
Un exemplu de vizualizare topologică leagă starea dispozitivului de dependențele din amonte și din aval.
2. Monitorizați semnalele care explică impactul asupra utilizatorului
Începeți cu un set compact de măsurători legate de serviciile critice:
Disponibilitate: starea dispozitivului și a interfeței, plus verificări ale serviciilor esențiale, cum ar fi DNS, aplicații web, e-mail sau acces VPN.
Calitatea căii: latență, pierdere de pachete și jitter acolo unde vocea sau video-ul în timp real depind de acestea.
Trafic și capacitate: utilizarea interfeței, debitul, erorile și eliminările. Păstrați istoricul pentru a putea distinge un vârf scurt de o problemă recurentă de capacitate.
Starea dispozitivului: starea procesorului, a memoriei, a temperaturii, a alimentării sau a ventilatorului în cazul în care echipamentul expune aceste valori.
Sisteme de suport: stocarea serverului și starea serviciilor atunci când o întrerupere a aplicației ar putea fi cauzată în afara nivelului de rețea.
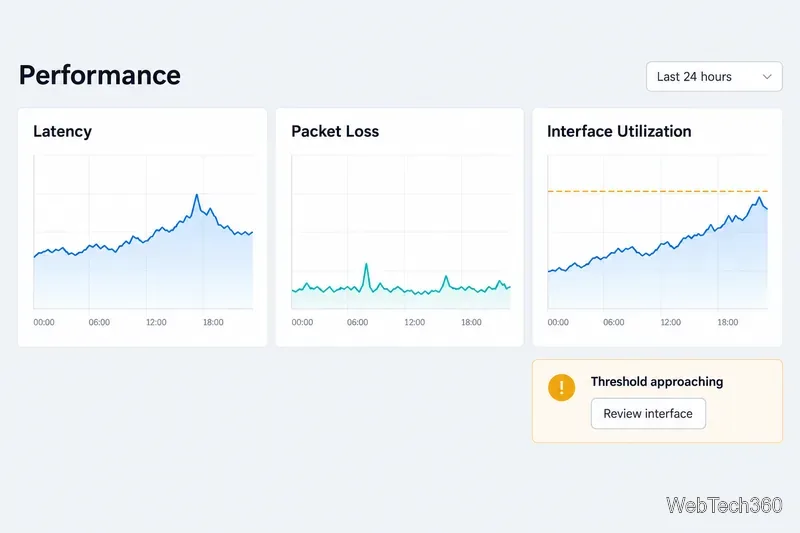
Stabiliți valori de referință în funcție de locație și serviciu, în loc să utilizați un prag universal. Comparați comportamentul actual cu perioadele normale de aglomerare și urmăriți presiunea susținută sau schimbările bruște.
Un exemplu de tablou de bord pentru performanță ajută la separarea variației normale de presiunea susținută asupra unei legături.
3. Faceți alertele acționabile și reduceți duplicatele
Alertează în cazul condițiilor care necesită acțiune: întreruperi, verificări eșuate ale serviciilor sau încălcări susținute ale pragurilor. Folosește o regulă de întârziere sau de recuperare pentru a filtra erorile tranzitorii. Include dispozitivul sau interfața, serviciul sau site-ul afectat, ora primei detectări, valorile observate și așteptate și un registru de operațiuni. Dirige alertele către un proprietar și definește escaladarea.
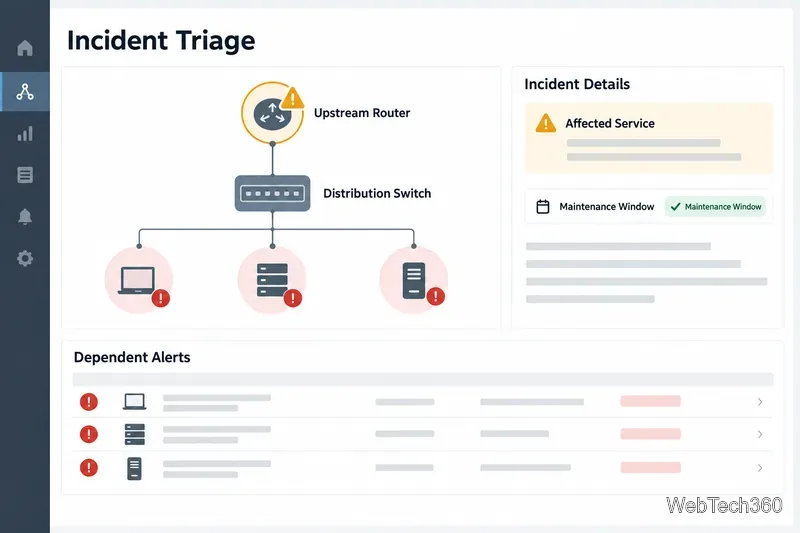
Grupați alertele din aval atunci când o defecțiune din amonte le explică; programați ferestre de întreținere pentru lucrările planificate. Acest lucru ajută respondenții să găsească mai rapid cauzele probabile. Revizuiți regulile de suprimare după modificările topologiei, astfel încât defecțiunile independente să rămână vizibile.
Un exemplu de vizualizare a incidentelor arată cum alertele dependente pot direcționa respondenții către prima legătură eșuată.
4. Protejați sistemul de monitorizare
Acreditările și jurnalele de monitorizare pot dezvălui o infrastructură sensibilă. Restricționați traficul de administrare, utilizați conturi doar pentru citire acolo unde este posibil, acordați acces bazat pe roluri și securizați serverul de monitorizare și copiile de rezervă. Preferați SNMPv3 atunci când este acceptat, cu setări de autentificare și confidențialitate compatibile; modelul de securitate bazat pe utilizator SNMPv3 definește aceste servicii de securitate. Urmați îndrumările CISA pentru protejarea jurnalelor și nu expuneți niciodată interfețele de administrare direct la internetul public.
5. Acoperire de testare, alerte și recuperare
Confirmați că sondele ajung la dispozitive din locațiile relevante, că acreditările funcționează și că istoricul este păstrat pentru depanare și planificare a capacității. Testați alertele cu destinatarii acestora; documentați proprietarii și programele de întreținere. Examinați dispozitivele învechite, lacunele și regulile zgomotoase după modificările rețelei. Mențineți un plan de recuperare testat pentru platforma de monitorizare.
Trei instrumente de monitorizare a rețelei pentru evaluare
Aceste produse acoperă nevoi comune. Compatibilitatea depinde de mediul dvs., modelul de implementare, licențiere și competențele disponibile. Verificați planurile și asistența pentru dispozitive cu fiecare furnizor.
Instrument
Unde s-ar putea potrivi
Verificați în timpul evaluării
Monitorul de performanță al rețelei SolarWinds
Medii cu mai mulți furnizori care necesită metrici, hărți, alerte, raportare sau depanare a căilor pentru dispozitive. Furnizorul listează disponibilitatea, latența, pierderea de pachete, utilizarea și starea dispozitivului.
Verificați suportul pentru dispozitive și protocoale, implementarea, păstrarea și modulele necesare. Consultați SolarWinds NPM .
Monitor de rețea Paessler PRTG
Echipele monitorizează dispozitive, trafic, servere și servicii cu hărți, tablouri de bord și notificări. PRTG reprezintă valorile monitorizate ca senzori.
Estimați necesarul de senzori și sonde pentru planul dvs. de acoperire. Consultați Paessler PRTG .
ManageEngine OpManager
Organizații care doresc monitorizarea descoperirii și a performanței pe dispozitive de rețea și servere. Documentele descriu suportul pentru SNMP, CLI și WMI.
Verificați accesul la protocol, șabloanele, controalele de rol, extensiile și gestionarea locațiilor la distanță. Consultați OpManager .
Alegeți cu un pilot mic
Testați un site reprezentativ, un serviciu critic și o combinație de dispozitive. Testați descoperirea, precizia metricilor, alertele, gestionarea întreținerii, rapoartele, permisiunile și recuperarea. Întrebați utilizatorii tabloului de bord ce context lipsește. Un scurt test pilot arată dacă platforma se potrivește rețelei dvs. mai bine decât o listă de verificare a caracteristicilor.