Главная
» СЕТЕВОЙ АДМИНИСТРАТОР
»
Рекомендации по мониторингу сети: что отслеживать и какие инструменты использовать.
Рекомендации по мониторингу сети: что отслеживать и какие инструменты использовать.
Эффективный мониторинг сети начинается с проверенной инвентаризации, метрик, ориентированных на сервисы, и оперативных оповещений. Составьте карту критически важных устройств и сервисов, определите нормальную производительность, а затем выберите платформу, которая поддерживает вашу инфраструктуру и может обслуживаться вашей командой. Это помогает выявлять возникающие проблемы, не превращая каждое кратковременное колебание в сообщение об ошибке.
Что должен показывать мониторинг сети?
Мониторинг сети отслеживает доступность устройств и служб, а также их производительность с течением времени. Обычно он охватывает состояние устройств и интерфейсов, трафик, ресурсы серверов и проверки служб. Ведение журналов безопасности выполняет другую задачу: система управления сетью (NMS) объясняет доступность и производительность, в то время как централизованные журналы или SIEM-система помогают расследовать такие события, как подозрительные входы в систему и изменения конфигурации. Многие команды используют оба подхода. NIST рассматривает непрерывный мониторинг как постоянное отслеживание рисков для принятия решений; необходимо проверять покрытие сети по мере изменения среды.
Передовые методы мониторинга сети
1. Перед настройкой оповещений составьте список товаров на складе.
Составьте список маршрутизаторов, коммутаторов, межсетевых экранов, беспроводного оборудования, критически важных серверов, облачных каналов связи и сервисов, ориентированных на клиентов. Для каждого устройства укажите местоположение, владельца, приоритет бизнеса, адрес управления и зависимости. Используйте функцию обнаружения для заполнения списка, затем проверьте его и добавьте устройства, которые не могут быть найдены автоматически. Сгруппируйте по сайту или сервису. Обновляйте список после внесения изменений, чтобы обеспечить полное покрытие.
Пример представления топологии связывает состояние устройства с зависимостями от вышестоящих и нижестоящих источников.
2. Отслеживайте сигналы, объясняющие влияние на пользователя.
Начните с небольшого набора измерений, привязанных к критически важным сервисам:
Доступность: состояние устройства и интерфейса, а также проверка наличия основных служб, таких как DNS, веб-приложения, электронная почта или доступ к VPN.
Качество передачи данных: задержка, потеря пакетов и дрожание сигнала, от которых зависит передача голоса или видео в реальном времени.
Трафик и пропускная способность: использование интерфейсов, пропускная способность, ошибки и отброшенные запросы. Сохраняйте историю, чтобы отличать кратковременный всплеск от повторяющихся проблем с пропускной способностью.
Состояние устройства: состояние процессора, памяти, температуры, питания или вентилятора, если оборудование отображает эти показания.
Вспомогательные системы: серверное хранилище и состояние сервисов в случаях, когда сбой в работе приложения может быть вызван причинами, не связанными с сетевым уровнем.
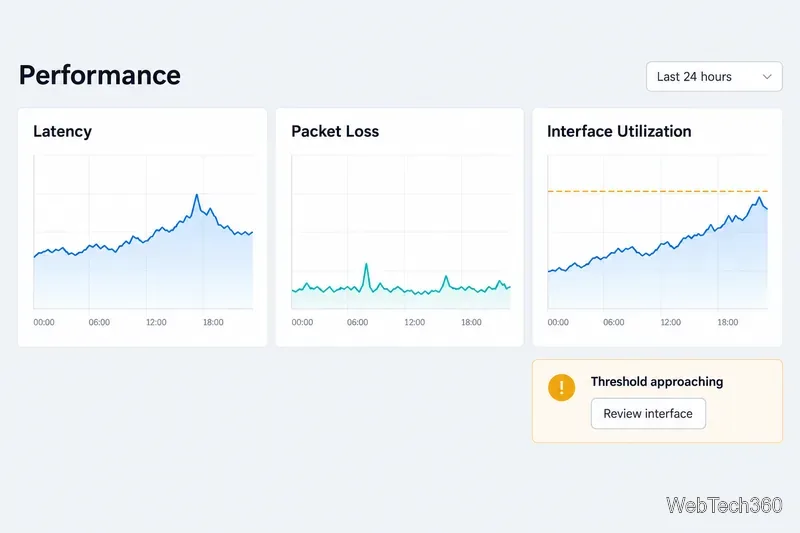
Установите базовые показатели для каждого объекта и услуги, вместо использования одного универсального порогового значения. Сравните текущее поведение с обычными периодами высокой загрузки и отслеживайте наличие устойчивой нагрузки или внезапных изменений.
Пример панели мониторинга производительности помогает отличить нормальные колебания от постоянной нагрузки на канал связи.
3. Сделайте оповещения действенными и уменьшите количество дубликатов.
Оповещения о ситуациях, требующих принятия мер: сбои, неудачные проверки сервисов или устойчивые превышения пороговых значений. Используйте правило задержки или восстановления для фильтрации кратковременных сбоев. Укажите устройство или интерфейс, затронутый сервис или сайт, время первого обнаружения, наблюдаемые и ожидаемые значения, а также руководство по устранению неполадок. Направляйте оповещения ответственному лицу и определяйте порядок эскалации.
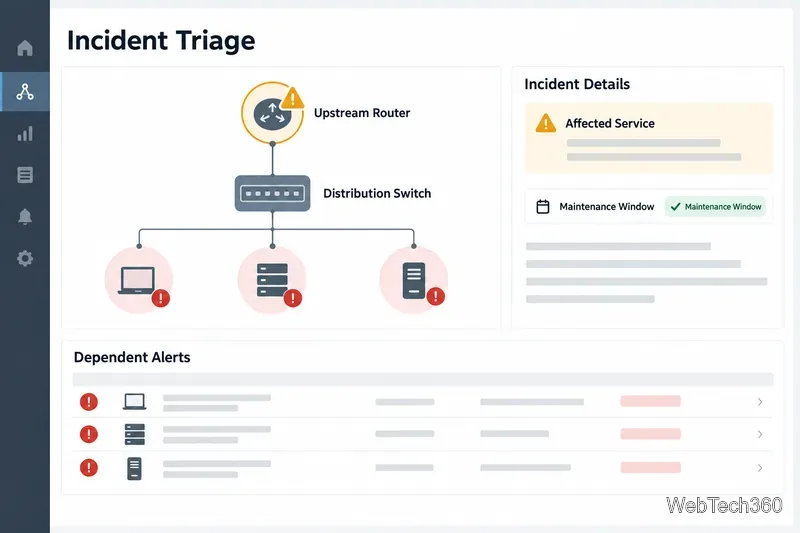
Группируйте оповещения нижестоящих звеньев, если их объясняет сбой вышестоящего звена; планируйте окна технического обслуживания для плановых работ. Это помогает специалистам быстрее находить вероятные причины. Пересматривайте правила подавления после изменения топологии, чтобы независимые сбои оставались видимыми.
На примере отображения инцидента показано, как зависимые оповещения могут указать специалистам на первое неисправное звено.
4. Защитите систему мониторинга.
Мониторинг учетных данных и журналов может выявить уязвимости инфраструктуры. Ограничьте трафик управления, используйте учетные записи только для чтения, где это возможно, предоставляйте доступ на основе ролей и обеспечьте безопасность сервера мониторинга и резервных копий. Отдавайте предпочтение SNMPv3, если он поддерживается, с совместимыми настройками аутентификации и конфиденциальности; модель безопасности на основе пользователей SNMPv3 определяет эти службы безопасности. Следуйте рекомендациям CISA по защите журналов и никогда не предоставляйте прямой доступ к интерфейсам управления через общедоступный интернет.
5. Тестовое покрытие, оповещения и восстановление.
Убедитесь, что зонды достигают устройств из соответствующих мест, учетные данные работают, а история сохраняется для устранения неполадок и планирования мощностей. Протестируйте оповещения с их получателями; задокументируйте владельцев и графики технического обслуживания. Проанализируйте устаревшие устройства, пробелы и некорректные правила после изменений в сети. Поддерживайте проверенный план восстановления для платформы мониторинга.
Три инструмента мониторинга сети для оценки
Эти продукты удовлетворяют распространенные потребности. Выбор зависит от вашей среды, модели развертывания, лицензирования и имеющихся навыков. Уточните планы и поддержку устройств у каждого поставщика.
Инструмент
Где это может поместиться
Проверить во время оценки
Монитор производительности сети SolarWinds
В средах, использующих оборудование разных производителей и требующих метрик устройств, карт, оповещений, отчетов или устранения неполадок с маршрутизацией, поставщик указывает доступность, задержку, потерю пакетов, загрузку и состояние устройств.
Проверьте поддержку устройств и протоколов, развертывание, хранение и необходимые модули. См. SolarWinds NPM .
Монитор сети Paessler PRTG
Команды отслеживают устройства, трафик, серверы и сервисы с помощью карт, панелей мониторинга и уведомлений. PRTG отображает отслеживаемые значения в виде данных с датчиков.
Оцените потребности в датчиках и зондах для вашего плана покрытия. См. Paessler PRTG .
ManageEngine OpManager
Организации, стремящиеся к обнаружению и мониторингу производительности сетевых устройств и серверов. В документации описана поддержка SNMP, CLI и WMI.
Проверьте доступ к протоколам, шаблоны, управление ролями, дополнения и управление удаленными сайтами. См. OpManager .
Выберите с помощью небольшого пилота.
Проведите пилотное тестирование на репрезентативном сайте, критически важном сервисе и наборе устройств. Проверьте обнаружение, точность метрик, оповещения, обработку технического обслуживания, отчеты, права доступа и восстановление. Спросите пользователей панели управления, какой контекст отсутствует. Короткое пилотное тестирование покажет, подходит ли платформа вашей сети лучше, чем контрольный список функций.