Если сервер SUSE Linux зависает во время перезагрузки на сообщении о завершении работы systemd, наиболее полезным первым предположением является не то, что сама команда перезагрузки неисправна. В большинстве случаев systemd ожидает завершения работы юнита, монтирования, процесса или обработчика завершения работы. Поэтому наиболее безопасным решением является определение точной задачи, которая все еще выполняется, изучение причин, по которым она не останавливается, и исправление этого компонента, а не глобальное сокращение времени ожидания завершения работы.
В этом руководстве используется гипотетический пример : сервер с именем lab-sles01работает под управлением SUSE Linux Enterprise Server и приостанавливается во время перезагрузки с сообщением, похожим на A stop job is running for backup.service. Пример является лишь иллюстрацией метода диагностики; это не отчет о реальном тестировании и не утверждение о наличии дефекта в службе с именем в конкретной версии SUSE backup.service.
Краткое описание решения в четыре этапа
| Шаг | Что делать | Что вы пытаетесь узнать |
|---|
| 1 | Запишите точное сообщение о завершении работы. | Какой блок или этап препятствует прогрессу? |
| 2 | Просмотрите предыдущий журнал загрузки. | Произошло ли срабатывание таймера остановки, не удалось ли отсоединить оборудование или выключение перешло на более позднюю стадию. |
| 3 | Проверьте блок блокировки и текущие задания. | Ответственность за это несет служба, крепление, ингибитор или зависимость. |
| 4 | Устраните первопричину и проведите повторное тестирование. | Завершится ли теперь нормальная ситуация systemctl rebootбез задержек? |
Шаг 1: Зафиксируйте точное место, где останавливается процесс выключения.
Во время плановой перезагрузки следите за локальной консолью, консолью виртуальной машины, консолью BMC/IPMI или консолью гипервизора. Строка с указанием имени юнита гораздо полезнее, чем общее описание, например, «systemd завис». В гипотетическом случае lab-sles01предположим, что консоль показывает, что backup.serviceпроцесс всё ещё останавливается, в то время как другие юниты уже завершили работу.
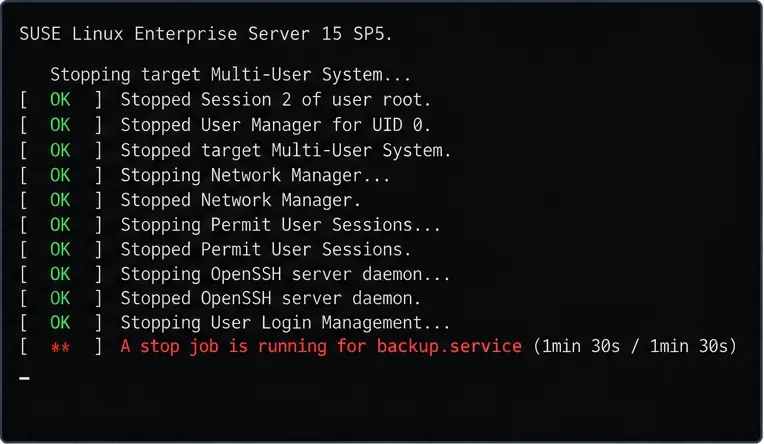
Показательный пример: консоль завершения работы определяет backup.service, что systemd все еще ожидает этот модуль.
Если в консоли вместо этого отображается имя .mountюнита, сетевой файловой системы, устройства или другой службы, используйте это имя, а не применяйте общий тайм-аут службы. Юнит, отображаемый в нижней части консоли, является подсказкой, но не автоматически указывает на первопричину: он сам может ожидать завершения дочернего процесса, хранилища, сетевого ввода-вывода или другой зависимости.
В текущих рекомендациях SUSE по systemd отмечается, что длительная перезагрузка или выключение питания могут быть вызваны службой, которая не завершила свою работу, и рекомендуется проверять задания systemd. См. SUSE Linux Enterprise Server 16.0: Введение в основы systemd .
Шаг 2: Используйте предыдущий журнал загрузки после возврата сервера.
После перезагрузки компьютера проверьте только что произошедшее завершение работы. SUSE документирует смещения загрузки в журнале: boot 0— это текущая загрузка, -1- это предыдущая загрузка и так далее. Начните с:
sudo journalctl --list-boots
sudo journalctl -b -1
В большом журнале обратный порядок сообщений позволяет быстрее отобразить последние сообщения:
sudo journalctl -b -1 -r

Показательный пример: журнал предыдущей загрузки показывает, что гипотетическая служба резервного копирования получает сигнал SIGTERM, а затем истекает время ожидания.
Ищите фразы типа Stopping, stop job, timed out, Failed with result, Unmounting, Dependency failed, или сообщения от самой подозрительной службы. Вы можете сузить круг поиска, как только узнаете название устройства:
sudo journalctl -b -1 -u backup.service
Документация SUSE journalctl -b -1по анализу предыдущих загрузок содержится в документации журнала SLES 15 SP7 . Если journalctl --list-bootsона не содержит информацию о предыдущей загрузке, не делайте выводов на основе отсутствующей истории; проверьте конфигурацию хранилища journald и используйте консольное или удаленное логирование для следующего воспроизведения проблемы.
Шаг 3: Определите, является ли блокировщик службой, процессом монтирования, ингибитором или обработчиком позднего завершения работы.
Если вы можете воспроизвести проблему во время планового технического обслуживания, держите под рукой вторую административную консоль. Прежде чем связь прервется, выполните следующие действия:
sudo systemctl list-jobs
sudo systemctl status backup.service
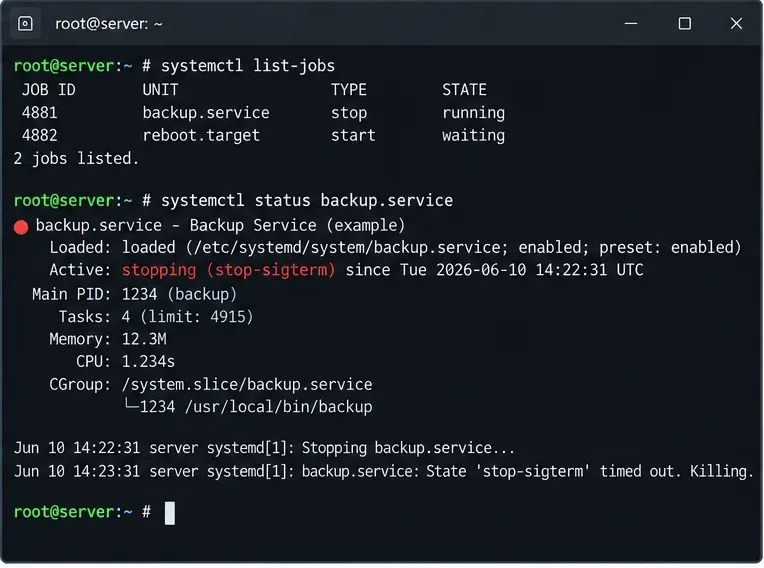
Показательный пример: backup.serviceвыполняется задача остановки, в то время как целевая задача перезагрузки ожидает завершения этой задачи.
В руководстве по отладке systemd от разработчика поясняется, что задания, обозначенные как , runningдолжны завершиться до того, как зависимые задания, обозначенные как , waitingсмогут продолжить выполнение. SUSE также рекомендует использовать systemctl list-jobsэту команду, когда выключение или перезагрузка занимают слишком много времени. Это делает данную команду особенно полезной, когда сервер не полностью завис и PID 1 все еще отвечает.
Если остановка службы происходит слишком медленно
Проверьте описание модуля и его поведение при завершении работы:
sudo systemctl cat backup.service
sudo systemctl status backup.service
sudo journalctl -u backup.service -b
Проверьте, выполняет ли служба какое-либо ExecStop=действие, обрабатывает ли ее процесс сигнал SIGTERM и ожидает ли он выделения ресурсов хранилища или сети. Базе данных, агенту резервного копирования или промежуточному программному обеспечению может потребоваться время для сброса данных, поэтому преждевременное завершение их работы не является автоматическим решением.
Если задействована система монтирования или сетевая файловая система.
Найдите ошибки при операциях размонтирования и определите источник монтирования:
findmnt
systemctl list-units --type=mount
sudo journalctl -b -1 | grep -Ei 'unmount|umount|mount|nfs|cifs'
Для NFS или CIFS проверьте доступность сервера, наличие устаревших сессий и соответствие параметров монтирования требованиям завершения работы сервера. Если заблокированный модуль создан из /etc/fstab, исправьте конфигурацию монтирования, вместо того чтобы применять тайм-аут, специфичный для службы, к несвязанному модулю.
Если запрос на перезагрузку блокируется
Перед началом завершения работы системы вы можете перечислить активные ингибиторы systemd:
systemd-inhibit --list
Блокировки-ингибиторы могут блокировать или задерживать запросы на завершение работы, пока приложение выполняет работу, которую не следует прерывать. Они наиболее актуальны, когда сам запрос на перезагрузку задерживается до того, как система перейдет в заключительную последовательность завершения работы. См. руководство по systemd-inhibit в исходном коде .
Если зависание происходит после того, как сервисы уже не работают
Зависание на более поздней стадии требует иного расследования. systemd запускает исполняемые файлы /usr/lib/systemd/system-shutdown/незадолго до окончательной перезагрузки или выключения питания и ожидает их завершения. Если журнал и консоль показывают, что обычные службы уже остановлены, и зависание происходит на заключительном этапе завершения работы, проверьте этот каталог и любые установленные поставщиком обработчики событий. Документация по службе завершения работы systemd описана в исходном коде.
Шаг 4: Исправьте компонент, затем проверьте обычную перезагрузку.
Вернемся к гипотетической ситуации lab-sles01. Предположим, журналы показывают, что служба backup.serviceигнорирует обычное завершение работы после завершения процесса резервного копирования. Первый вариант — исправить службу или команду ее остановки. Если известно, что служба может безопасно завершиться по истечении определенного периода времени, можно ограничить время ожидания systemd для каждого модуля службы.
Вместо редактирования единицы измерения поставщика создайте переопределение в следующем разделе /usr/lib/systemd/system:
sudo systemctl edit backup.service
Например:
[Service]
TimeoutStopSec=30s
Затем перезагрузите конфигурацию юнитов systemd:
sudo systemctl daemon-reload
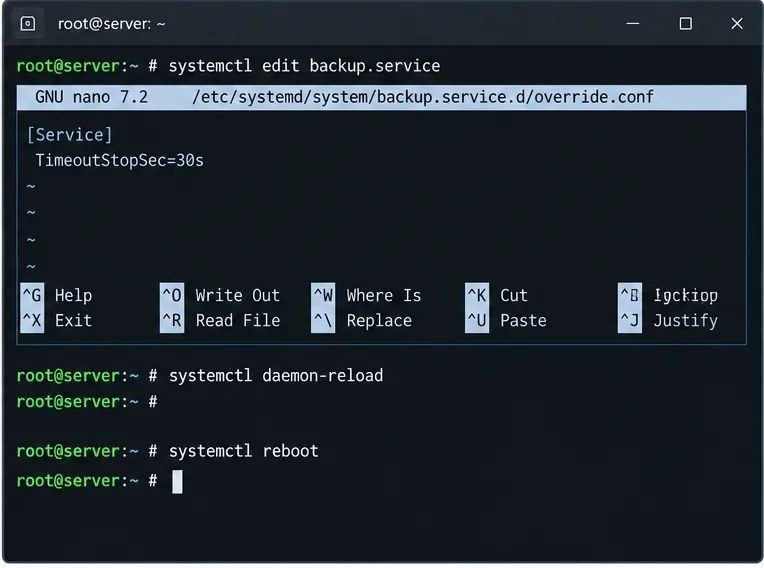
Показательный пример: тайм-аут для каждой службы применяется только после того, как гипотетическая служба будет определена как блокирующая.
Не следует слепо копировать значение в 30 секунд. Правильное значение тайм-аута зависит от того, что именно должна безопасно завершить реальная служба. Уменьшение его для базы данных, демона хранения, кластерной службы или процесса резервного копирования может прервать корректную очистку. Тайм-аут — это ограничитель, а не замена для исправления неисправного ExecStop=действия или приложения, которое не завершается должным образом.
Когда вы будете удовлетворены изменениями, попробуйте выполнить обычную перезагрузку:
sudo systemctl reboot
После того, как устройство вернется в рабочее состояние, еще раз проверьте предыдущую загрузку и убедитесь, что оно завершило работу корректно, а не просто исчезло из консоли.
В каких случаях следует использовать принудительную перезагрузку?
Принудительная перезагрузка — это вариант восстановления, а не стратегия устранения неполадок. В документации systemd указано, что принудительная перезагрузка --forceпропускает systemctl rebootобычное завершение работы служб, но всё равно завершает процессы и пытается размонтировать или повторно смонтировать файловые системы в режиме только для чтения. --forceДвойное указание параметра более опасно, поскольку может привести к перезагрузке без завершения процессов или размонтирования файловых систем, с риском потери данных.
Если сервер уже завис и нет более безопасного способа восстановить работу, в соответствии с вашими рабочими процедурами может быть оправдана одна принудительная перезагрузка:
sudo systemctl reboot --force
Не следует рассматривать systemctl reboot --force --forceвиртуальное отключение питания или физическую перезагрузку как обычное решение проблемы. Эти действия могут удалить необходимые вам доказательства и поставить под угрозу операции записи, находящиеся в процессе выполнения. В документации к systemctl явно различаются режимы принудительного и принудительного отключения питания.
Что делать, если каждая перезагрузка приводит к зависанию, и вы не можете устранить неполадки в обычном режиме?
Используйте консоль обслуживания и загрузитесь в режиме восстановления. В документации SUSE описано добавление параметров systemd.unit=rescue.targetв командную строку ядра из редактора GRUB. Режим восстановления предоставляет сеанс root с локальными файловыми системами и основными службами, оставляя сеть неактивной, что может помочь отключить или восстановить проблемную службу или конфигурацию монтирования.
Официальную процедуру восстановления см . в Руководстве по администрированию SLES 15 SP7 . На системах, где проблема возникает только после изменения определенного пакета, ядра, драйвера или хранилища, перед внесением необратимых изменений в настройки таймаута также следует просмотреть соответствующую историю обновлений SUSE.
Таблица для быстрого принятия решений
| То, что вы видите | Вероятная область для осмотра | Лучшее следующее действие |
|---|
A stop job is running for xyz.service | Путь завершения работы службы | Проверка systemctl status, файл модуля и журнал обслуживания. |
| Повторяющиеся сообщения об отключении или удаленной файловой системе | Монтирование, NFS, CIFS, хранилище | Проверьте findmnt, подключите устройства /etc/fstabи проверьте доступность сервера. |
| Запрос на перезагрузку отклонен или задерживается перед завершением работы. | Ингибитор или другая задача системы. | Беги systemd-inhibit --listиsystemctl list-jobs |
| Работа служб приостановлена, но окончательное отключение так и не завершилось. | Задержка завершения работы, ядро, драйвер, хранилище | Просмотрите журнал предыдущей загрузки и/usr/lib/systemd/system-shutdown/ |
| Обычная загрузка делает ремонт невозможным. | Постоянная неисправность конфигурации или устройства. | Загрузка сsystemd.unit=rescue.target |
Итог
Для сервера SUSE Linux, зависающего при завершении работы systemd, надежным решением является определение задачи, которую ожидает systemd, и исправление этого модуля или его зависимости. Запишите сообщение о завершении работы, проанализируйте его journalctl -b -1, используйте systemctl list-jobsи systemctl statusдля изоляции блокирующей задачи, и только после этого измените тайм-аут для каждой службы или конфигурацию монтирования. Используйте принудительную перезагрузку только для ситуаций восстановления, а не для рутинных операций.



