ณ วันที่ 6 ตุลาคม 2026 เวอร์ชันเสถียรล่าสุดของ Matrix Synapse คือ 1.162.0 ซึ่งเผยแพร่เมื่อวันที่ 29 กันยายน 2026 หากโฮมเซิร์ฟเวอร์ของคุณมีปัญหาหน่วยความจำไม่เพียงพอระหว่างการซิงโครไนซ์ไคลเอ็นต์ การอัปเกรดเป็นเวอร์ชันที่รองรับในปัจจุบันถือเป็นการตรวจสอบเบื้องต้นที่เหมาะสม แต่การแก้ไขที่ยั่งยืนมักอยู่ที่การใช้งานมากกว่าการตั้งค่าเพียงอย่างเดียว Synapse จงใจเก็บข้อมูลห้องและเมตาเดต้าล่าสุดไว้ในหน่วยความจำเพื่อให้การร้องขอทั่วไปเร็วขึ้น และเอกสารผู้ดูแลระบบอย่างเป็นทางการเตือนว่าการลดแคชมากเกินไปอาจทำให้ปัญหาหน่วยความจำแย่ลงได้โดยการสร้างคิวของการร้องขอที่ช้า
คู่มือนี้จะแนะนำขั้นตอนที่ผู้ดูแลระบบมือใหม่สามารถใช้งานได้อย่างปลอดภัย: ทำความเข้าใจว่า "การซิงค์" หมายถึงอะไร ตรวจสอบว่ากระบวนการนั้นใช้หน่วยความจำเกินขีดจำกัดจริงหรือไม่ ลดภาระแคชที่ไม่จำเป็น แยกการรับส่งข้อมูลการซิงค์เริ่มต้นที่หนักผิดปกติเมื่อจำเป็น และตรวจสอบผลลัพธ์ เป้าหมายไม่ใช่เพียงแค่ทำให้ขนาดชุดข้อมูลที่ใช้งานอยู่เล็กลง เป้าหมายคือการหยุดการเกิดข้อผิดพลาดเนื่องจากหน่วยความจำไม่เพียงพอในขณะที่ยังคงรักษาการตอบสนองของโฮมเซิร์ฟเวอร์ไว้
“การซิงค์” ใน Matrix Synapse หมายความว่าอย่างไร
ไคลเอนต์ Matrix จะเรียกใช้ API แบบ Client-Server ซ้ำๆ/_matrix/client/v3/syncเพื่อรับเหตุการณ์ใหม่ๆ เช่น ข้อความ สถานะห้อง ข้อมูลบัญชี ข้อมูลสถานะการใช้งาน และการอัปเดตอุปกรณ์ การซิงค์ข้อมูลตามปกติมักจะมีsinceโทเค็นอยู่ด้วย ดังนั้น Synapse จึงจำเป็นต้องส่งคืนเฉพาะการเปลี่ยนแปลงหลังจากจุดซิงค์ครั้งก่อนเท่านั้น
การซิงค์ครั้งแรกนั้นแตกต่างออกไป เป็นการซิงค์ครั้งแรกสำหรับอุปกรณ์หรือเซสชัน และไม่มีsinceโทเค็นก่อนหน้า เอกสารอย่างเป็นทางการของ Synapse อธิบายว่าคำขอเหล่านี้อาจใช้ทรัพยากรมาก ในโฮมเซิร์ฟเวอร์ขนาดใหญ่ Synapse รองรับการกำหนดเส้นทางการซิงค์ครั้งแรกแยกต่างหากจากการซิงค์ที่กำลังดำเนินอยู่ เพื่อไม่ให้การซิงค์ครั้งแรกที่มีค่าใช้จ่ายสูงเพียงไม่กี่ครั้งไปรบกวนคนอื่นๆ
ก่อนทำการเปลี่ยนแปลงใดๆ โปรดตรวจสอบคำถามที่พบบ่อยสำหรับผู้ดูแลระบบ Synapse ฉบับปัจจุบัน เอกสารอ้างอิงการกำหนดค่าและคู่มือการใช้งานอย่างเป็นทางการตัวเลือกที่ใช้งานได้จริงจะขึ้นอยู่กับเวอร์ชัน Synapse และรูปแบบการใช้งาน
ก่อนที่คุณจะเปลี่ยนแปลงอะไรก็ตาม
- โปรดจดบันทึกเวอร์ชัน Synapse และวิธีการติดตั้งของคุณ
- สำรอง
homeserver.yamlข้อมูลไฟล์การกำหนดค่าผู้ปฏิบัติงาน การกำหนดค่าพร็อกซีแบบย้อนกลับ และฐานข้อมูล PostgreSQL ตามขั้นตอนการสำรองข้อมูลปกติของคุณ
- โปรดสังเกตว่า Synapse ทำงานเป็นกระบวนการเดียว ในคอนเทนเนอร์ หรือเป็นกระบวนการหลักบวกกับกระบวนการทำงานเสริม
- ตรวจสอบขีดจำกัดหน่วยความจำที่แท้จริง คอนเทนเนอร์ หน่วย systemd พอด Kubernetes หรือ VM อาจมีขีดจำกัดที่ต่ำกว่าเซิร์ฟเวอร์ทางกายภาพ
- โปรดตรวจสอบให้แน่ใจว่าได้ใช้ PostgreSQL สำหรับการใช้งานจริงแล้ว เอกสารการติดตั้ง Synapse ฉบับปัจจุบันระบุว่า SQLite เหมาะสำหรับการทดสอบและทำงานได้ไม่ดีสำหรับการใช้งานจริง โดยเฉพาะอย่างยิ่งในห้องขนาดใหญ่
ขั้นตอนที่ 1: ยืนยันว่าปัญหาเกิดจากหน่วยความจำหมดนั่นเอง
อย่าเริ่มต้นด้วยการเปลี่ยนค่าแคช ก่อนอื่นให้ระบุว่ากระบวนการใดของ Synapse ที่ใช้หน่วยความจำมาก และกระบวนการนั้นถูกปิดโดยระบบปฏิบัติการหรือโดยข้อจำกัดของคอนเทนเนอร์หรือไม่
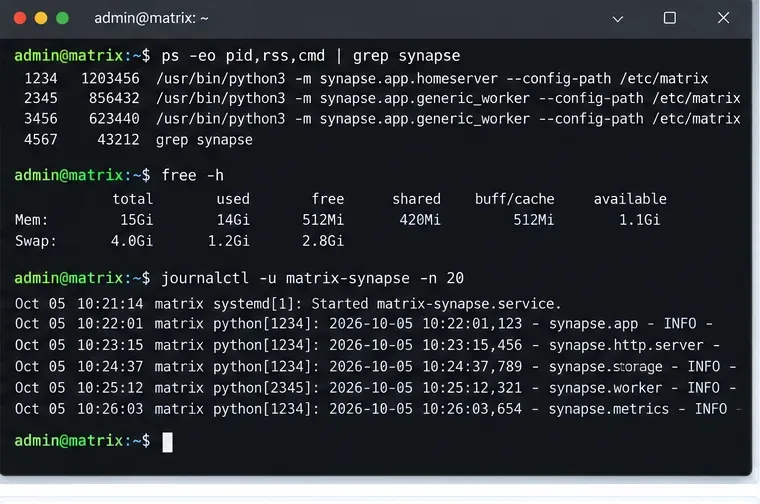 เริ่มต้นด้วยการตรวจสอบค่า RSS ของกระบวนการ หน่วยความจำที่ใช้งานได้ แรงดันสวอป และบันทึกบริการ Synapse ล่าสุด เพื่อตรวจสอบว่าปัญหาเกิดจากการใช้หน่วยความจำหมดจริง ๆ หรือเป็นความล้มเหลวในการซิงค์ข้อมูลประเภทอื่น
บนระบบปฏิบัติการ Linux คำสั่งต่างๆ เช่น คำสั่งต่อไปนี้ จะช่วยให้เห็นภาพรวมเบื้องต้นได้อย่างรวดเร็ว:
ps -eo pid,rss,cmd | grep synapse
free -h
journalctl -u matrix-synapse -n 200
หากคุณใช้ Docker, Podman, Kubernetes หรือตัวจัดตารางเวลาอื่นๆ โปรดตรวจสอบขีดจำกัดหน่วยความจำของคอนเทนเนอร์หรือพอดด้วย โฮสต์ที่มีหน่วยความจำว่างหลายกิกะไบต์ก็ยังสามารถปิด Synapse ได้หากกระบวนการถูกจำกัดไว้ที่ขีดจำกัด cgroup ที่เล็กกว่ามาก
มองหารูปแบบที่ซ้ำกัน หน่วยความจำเพิ่มขึ้นเฉพาะเมื่อผู้ใช้รายใดรายหนึ่งเข้าสู่ระบบบนอุปกรณ์ใหม่หรือไม่? เพิ่มขึ้นอย่างค่อยเป็นค่อยไปตลอดทั้งวันหรือไม่? กระบวนการทำงานทั่วไปหนึ่งกระบวนการเติบโตขึ้นในขณะที่กระบวนการหลักยังคงที่หรือไม่? การสังเกตเหล่านี้จะช่วยแยกแยะการเพิ่มขึ้นของหน่วยความจำในช่วงเริ่มต้นการซิงค์ออกจากการเพิ่มขึ้นของแคชโดยทั่วไปหรือปริมาณคำขอที่ค้างอยู่
ขั้นตอนที่ 2: ตรวจสอบการตั้งค่าแคชก่อนที่จะลดระดับลง
แคช คือข้อมูล ที่ Synapse เก็บไว้ใน RAM เพื่อไม่ต้องคำนวณหรือโหลดข้อมูลเดิมซ้ำๆ Synapse มีแคชหลายประเภท รวมถึงแคชเหตุการณ์ เอกสารอ้างอิงการกำหนดค่าในปัจจุบันระบุค่าเริ่มต้นไว้caches.global_factorที่ 0.5 ค่าevent_cache_sizeเริ่มต้น 10K ก่อนที่จะใช้ปัจจัยโดยรวม การหมดอายุของแคชตามเวลา และค่าsync_response_cache_durationเริ่มต้น 2 นาที
วิธีแก้ปัญหาที่ดูน่าสนใจคือการตั้งค่าตัวประกอบโดยรวมให้ต่ำที่สุดเท่าที่จะเป็นไปได้ แต่ห้ามทำเช่นนั้นโดยไม่คิดให้รอบคอบ คำถามที่พบบ่อยสำหรับผู้ดูแลระบบ Synapse เตือนไว้อย่างชัดเจนว่าแคชที่มีขนาดเล็กเกินไปอาจทำให้ระบบที่ช้าอยู่แล้วช้าลงไปอีก ทำให้คำขอต่างๆ สะสมและทำให้การใช้หน่วยความจำเพิ่มขึ้นอย่างมากจากคำขอที่ค้างอยู่แทนที่จะเป็นรายการในแคช
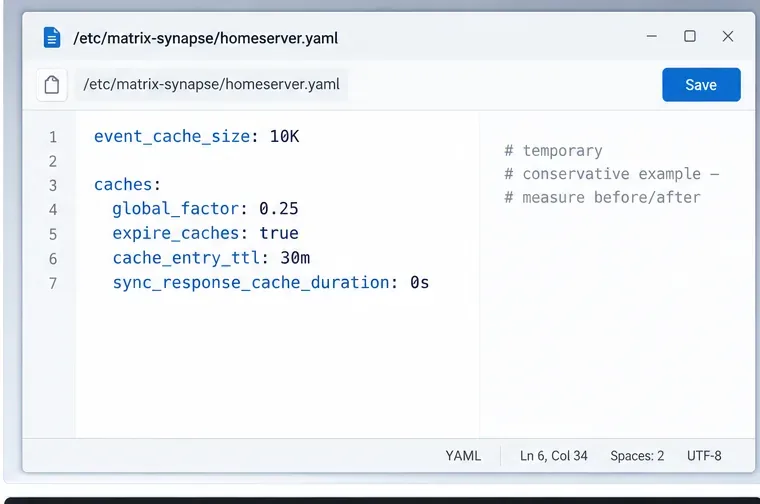 ปรับเปลี่ยนแคชอย่างระมัดระวังและวัดผลลัพธ์ ตัวอย่างนี้แสดงให้เห็นว่าการตั้งค่าที่เกี่ยวข้องอยู่ที่ใด ไม่ใช่ค่าการผลิตทั่วไป
หากการวิเคราะห์ประสิทธิภาพแสดงให้เห็นว่าหน่วยความจำแคชเป็นส่วนประกอบหลักที่ใช้ทรัพยากร และปริมาณการประมวลผลคำขออยู่ในระดับที่ดี ควรลองลดขนาดหน่วยความจำแคชลงทีละน้อยแทนที่จะลดอย่างมาก ตัวอย่างเช่น:
event_cache_size: 10K

caches:
  global_factor: 0.25
  expire_caches: true
  cache_entry_ttl: 30m
  sync_response_cache_duration: 0s
นี่เป็นตัวอย่างการแก้ไขปัญหา ไม่ใช่ค่าที่แนะนำสำหรับทุกเซิร์ฟเวอร์ การตั้งค่าsync_response_cache_durationเป็นศูนย์จะปิดใช้งานการแคช/syncการตอบสนองที่เสร็จสมบูรณ์ ซึ่งอาจช่วยประหยัดหน่วยความจำได้เมื่อมีการเก็บรักษาการตอบสนองการซิงค์จำนวนมาก แต่ก็อาจทำให้การเชื่อมต่อไคลเอ็นต์ใหม่ต้องทำงานหนักขึ้น ทดสอบภายใต้ภาระงานจริงของคุณ
Synapse ยังมีฟังก์ชันปรับแต่งแคชอัตโนมัติด้วยmax_cache_memory_usage, target_cache_memory_usage, และmin_cache_ttlเอกสารอย่างเป็นทางการระบุว่าฟีเจอร์นี้ต้องการjemallocซึ่งเป็นตัวจัดสรรหน่วยความจำทางเลือก และต้องระบุการตั้งค่าทั้งสามค่า อย่าเปิดใช้งานเพียงหนึ่งหรือสองค่า เอกสารเตือนว่าการกำหนดค่าที่ไม่สมบูรณ์อาจทำให้การทำงานไม่เสถียร
ขั้นตอนที่ 3: ตรวจสอบให้แน่ใจว่าฐานข้อมูลไม่ได้สร้างคำขอค้างอยู่
ปัญหาหน่วยความจำระหว่างการซิงค์ไม่ได้เกิดจากปริมาณข้อมูลที่แคชไว้เสมอไป ฐานข้อมูลที่ทำงานช้าอาจเก็บคำขอจำนวนมากไว้พร้อมกัน และแต่ละคำขอที่กำลังดำเนินการอยู่จะใช้หน่วยความจำ นี่คือเหตุผลที่การลดขนาดแคชอาจส่งผลเสียต่อระบบจัดเก็บข้อมูลที่ทำงานช้าอยู่แล้ว
สำหรับการใช้งานจริง ให้ปฏิบัติตามคู่มืออย่างเป็นทางการของ Synapse PostgreSQLตรวจสอบการใช้งาน CPU ของฐานข้อมูล ความหน่วงในการจัดเก็บข้อมูล ความอิ่มตัวของการเชื่อมต่อ คิวรีที่ใช้เวลานาน และตรวจสอบว่าเซิร์ฟเวอร์ PostgreSQL กำลังใช้หน่วยความจำเสมือนหรือไม่ หากความหน่วงในการซิงค์เพิ่มขึ้นพร้อมกับหน่วยความจำที่ใช้งานอยู่ ให้ตรวจสอบงานที่ค้างอยู่ก่อนที่จะลดแคชอีกครั้ง
หากคุณเพิ่งย้ายไปใช้ห้องสาธารณะขนาดใหญ่ รวมเข้ากับชุมชนที่ใหญ่ขึ้นมาก หรือเพิ่มผู้ใช้งานจำนวนมาก การทำงานอาจเพิ่มขึ้นจนเกินขีดจำกัดของการตั้งค่าที่เคยใช้งานได้ก่อนหน้านี้ ในกรณีเช่นนั้น การปรับแต่งฐานข้อมูลและการแยกการทำงานของระบบมักมีความสำคัญมากกว่าการลดขนาดแคชเพียงเล็กน้อย
ขั้นตอนที่ 4: แยกการซิงค์เริ่มต้นบนโฮมเซิร์ฟเวอร์ขนาดใหญ่
Synapse สามารถทำงานในรูปแบบ โมโนลิธ (monolith)เดียวซึ่งหมายถึงกระบวนการหลักบนโฮมเซิร์ฟเวอร์เพียงกระบวนการเดียว หรือสามารถแบ่งงานออกเป็นเวิร์กเกอร์ (worker)ซึ่งเป็นกระบวนการ Synapse เพิ่มเติมที่ใช้ฐานข้อมูล PostgreSQL เดียวกัน โดยรูปแบบเวิร์กเกอร์นี้เหมาะสำหรับระบบขนาดใหญ่ที่ต้องการปรับขนาดปริมาณงานแต่ละส่วนได้อย่างอิสระ
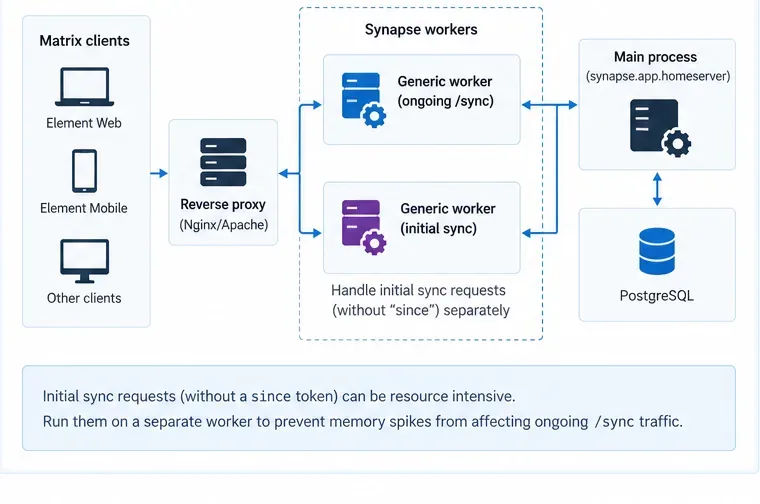 ในการใช้งานฐานข้อมูล PostgreSQL ขนาดใหญ่ ควรแยกการซิงค์ข้อมูลครั้งแรกที่มีค่าใช้จ่ายสูงออกจากการซิงค์ข้อมูลที่กำลังดำเนินการอยู่ เพื่อไม่ให้การล็อกอินครั้งแรกใช้กลุ่มทรัพยากรการทำงานเดียวกันกับการอัปเดตข้อมูลไคลเอ็นต์ตามปกติ
เอกสารประกอบการทำงานของ Worker ระบุว่า Worker ทั่วไปสามารถจัดการ/syncและ/initialSyncได้ นอกจากนี้ยังแนะนำให้พิจารณาการจัดการแยกต่างหากสำหรับคำขอซิงค์ที่ไม่มีsinceพารามิเตอร์ เนื่องจากคำขอซิงค์เริ่มต้นเหล่านี้อาจใช้ทรัพยากรมาก
สถาปัตยกรรมที่ใช้งานได้จริงคือ:
- รีเวิร์สพร็อกซีรับทราฟฟิกจากไคลเอ็นต์ Matrix
/syncคำขอที่ดำเนินการอยู่ จะถูกส่งไปยังผู้ประมวลผลทั่วไปหนึ่งคนหรือมากกว่านั้น- คำขอซิงค์เริ่มต้นจะถูกส่งไปยังกลุ่มผู้ปฏิบัติงานทั่วไปแยกต่างหาก
- กระบวนการหลักยังคงดำเนินต่อไปด้วยการจัดการกับความรับผิดชอบที่ไม่ได้มอบหมายให้ผู้อื่น
- กระบวนการทั้งหมดของ Synapse ใช้ฐานข้อมูล PostgreSQL ร่วมกัน
อย่าเปิดเผย Synapse replication listener สู่สาธารณะทางอินเทอร์เน็ต เอกสารประกอบการใช้งานปัจจุบันเตือนว่า การรับส่งข้อมูลการจำลองแบบนั้นไม่ได้เข้ารหัสและไม่ได้รับการตรวจสอบความถูกต้อง เว้นแต่จะมีการกำหนดค่ารหัสลับการจำลองไว้
การใช้ Worker ไม่ใช่ทางเลือกแรกที่เหมาะสมสำหรับโฮมเซิร์ฟเวอร์ขนาดเล็ก คำแนะนำของ Synapse เองแนะนำให้ใช้โหมด Monolith สำหรับอินสแตนซ์ขนาดเล็กกว่า ควรเพิ่ม Worker เมื่อคุณมีหลักฐานที่แน่ชัดว่าเวิร์กโหลดเฉพาะนั้นต้องการการแยกหรือการขยายขนาดในแนวนอน
ขั้นตอนที่ 5: โหลดค่าแคชใหม่อย่างปลอดภัยและสังเกตผลลัพธ์
Synapse อนุญาตให้โหลดค่าแคชใหม่ได้โดยใช้คำสั่ง `reload` เอกสารSIGHUPอ้างอิงการกำหนดค่าให้ตัวอย่างดังนี้:
kill -HUP PID_OF_SYNAPSE_PROCESS
หากบริการ systemd ที่ติดตั้งมานั้นรองรับsystemctl reload matrix-synapseก็สามารถดำเนินการเดียวกันได้ ในการใช้งานแบบ worker นั้น เอกสารอย่างเป็นทางการระบุว่าต้องอัปเดตการกำหนดค่า worker ที่เกี่ยวข้อง และแต่ละ worker ต้องได้รับสัญญาณ reload แยกกัน
หลังจากทำการเปลี่ยนแปลงทุกครั้ง ให้เวลาเซิร์ฟเวอร์มากพอที่จะกลับสู่รูปแบบการรับส่งข้อมูลปกติ ตรวจสอบหน่วยความจำที่ใช้งานอยู่ ความหน่วงในการร้องขอ โหลดฐานข้อมูล และสถานะของเวิร์กเกอร์ที่กำลังทำงานอยู่พร้อมกัน กราฟหน่วยความจำที่ลดลงในขณะที่ความหน่วงในการซิงค์เพิ่มขึ้นเป็นสองเท่า ไม่ถือเป็นการแก้ไขที่ประสบความสำเร็จ
ขั้นตอนที่ 6: เปิดใช้งานเมตริกของ Prometheus เพื่อการวินิจฉัยที่ทำซ้ำได้
สำหรับเหตุการณ์ที่ซับซ้อนกว่าเหตุการณ์ครั้งเดียว ให้เปิดใช้งานเมตริกของ Synapse และรวบรวมข้อมูลด้วย Prometheus คู่มือการตรวจสอบอย่างเป็นทางการได้enable_metrics: trueระบุถึงวิธีการใช้งาน และควรใช้ตัวรับฟังเมตริกภายในโดยเฉพาะ เก็บปลายทางเมตริกไว้บนอินเทอร์เฟซภายในหรือป้องกันไว้ที่พร็อกซีแบบย้อนกลับ ไม่ควรเปิดเผยโดยไม่จำเป็น
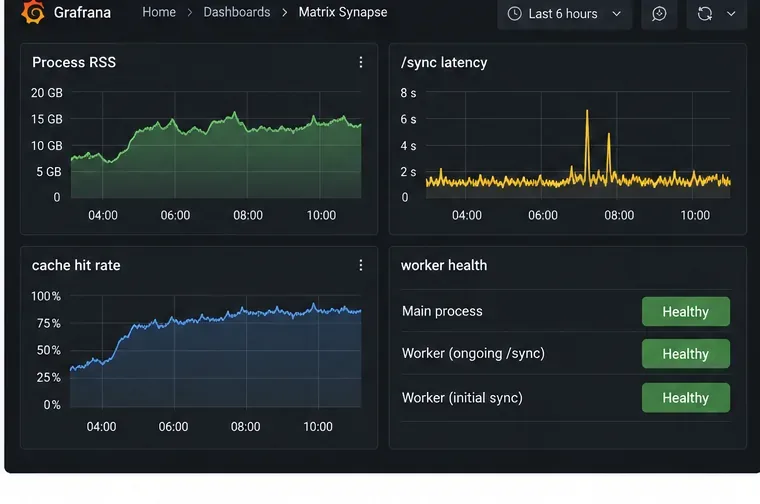 ติดตามหน่วยความจำและเวลาแฝงในการซิงค์ไปพร้อมกัน ผลลัพธ์ที่มีประโยชน์คือหน่วยความจำที่เสถียรพร้อมเวลาตอบสนองที่ยอมรับได้ ไม่ใช่ค่า RSS ที่น้อยที่สุดเท่าที่จะเป็นไปได้
โปรดใช้คู่มือการตรวจสอบ Prometheus อย่างเป็นทางการของ Synapseสำหรับไวยากรณ์ Listener ปัจจุบัน ในการใช้งานแบบ Worker ให้ตรวจสอบ Worker แต่ละตัวแยกกัน เนื่องจากเมตริกของ Worker จะไม่ถูกรวบรวมเข้ากับกระบวนการหลักโดยอัตโนมัติ
ข้อผิดพลาดทั่วไปที่ควรหลีกเลี่ยง
ลดค่า SYNAPSE_CACHE_FACTOR ลงเรื่อยๆ จนกว่าเซิร์ฟเวอร์จะทำงานช้าลง
แคชขนาดเล็กใช้หน่วยความจำต่อรายการน้อยกว่า แต่จะเพิ่มภาระงานของฐานข้อมูลและการคำนวณ หากภาระงานที่เพิ่มขึ้นนั้นทำให้เกิดคิวคำขอที่ไม่เสร็จสมบูรณ์ หน่วยความจำโดยรวมอาจเพิ่มขึ้นแทนที่จะลดลง ดังนั้นควรลดขนาดแคชทีละน้อย และควรตรวจสอบความหน่วงอยู่เสมอ
โดยสมมติว่าทุกคำขอ /sync มีค่าใช้จ่ายเท่ากัน
การซิงค์ข้อมูลอย่างต่อเนื่องโดยใช้sinceโทเค็นและการซิงค์ข้อมูลครั้งแรกโดยไม่ใช้โทเค็นนั้นใช้ทรัพยากรแตกต่างกันมาก ควรแยกการซิงค์ทั้งสองประเภทนี้ออกจากกันในขั้นตอนการวิเคราะห์ก่อนที่จะปรับขนาดเซิร์ฟเวอร์ทั้งหมด
การใช้งานเวิร์กเกอร์ในขณะที่ยังคงใช้ SQLite อยู่
Synapse worker ใช้ฐานข้อมูล PostgreSQL ร่วมกัน เอกสารประกอบการใช้งานระบุว่า SQLite ใช้สำหรับการสาธิตหรือทดสอบเท่านั้น และไม่ใช่พื้นฐานสำหรับการใช้งานจริงในระบบ Worker
การใช้ swap เป็นวิธีแก้ไขหลัก
การใช้หน่วยความจำเสมือน (swap) ในปริมาณเล็กน้อยอาจช่วยป้องกันการหยุดทำงานของกระบวนการอย่างกะทันหันได้ แต่การใช้หน่วยความจำเสมือนในปริมาณมากจะทำให้การซิงค์ช้าลงอย่างมาก และอาจสร้างวงจรป้อนกลับแบบค้างคาขึ้นมาได้เช่นกัน ควรใช้หน่วยความจำเสมือนเป็นการป้องกันการใช้งานที่เพิ่มขึ้นอย่างรวดเร็วในระยะสั้น ไม่ใช่การวางแผนกำลังการผลิต
การเปลี่ยนการตั้งค่าหน่วยความจำหลายรายการพร้อมกัน
หากคุณลดแคช เปลี่ยนเส้นทางการทำงานของเวิร์กเกอร์ ปรับเปลี่ยนการตั้งค่า PostgreSQL และเพิ่มขีดจำกัดคอนเทนเนอร์พร้อมกัน คุณจะไม่รู้ว่าการเปลี่ยนแปลงใดแก้ปัญหาได้ ควรทำการเปลี่ยนแปลงทีละอย่างอย่างเป็นระบบ และเปรียบเทียบตัวชี้วัดเดียวกัน
เส้นทางการตัดสินใจที่เป็นรูปธรรม
| สิ่งที่คุณสังเกตเห็น | การดำเนินการต่อไปที่น่าจะเป็นไปได้ |
|---|
| หน่วยความจำทำงานผิดปกติเมื่อผู้ใช้ลงชื่อเข้าใช้บนอุปกรณ์ใหม่ | ระบุการซิงค์เริ่มต้นและพิจารณาแยกการซิงค์นั้นไว้บนเครื่องทำงานสำหรับงานติดตั้งขนาดใหญ่ |
| หน่วยความจำเพิ่มขึ้นอย่างต่อเนื่อง ในขณะที่อัตราการเข้าถึงแคชสูง และความหน่วงแฝงอยู่ในระดับปกติ | ลดความจุแคชลงอย่างระมัดระวังแล้วทดสอบอีกครั้ง |
| หน่วยความจำและเวลาแฝงในการซิงค์เพิ่มขึ้นพร้อมกัน | ตรวจสอบฐานข้อมูลหรือพื้นที่จัดเก็บข้อมูลที่ค้างอยู่ก่อนที่จะลดขนาดแคชลงอีก |
| มีเพียงคนงานคนเดียวเท่านั้นที่ถึงขีดจำกัดของตนเอง | ปรับงบประมาณหน่วยความจำของพนักงานคนนั้น หรือปรับขนาดกลุ่มพนักงานนั้นแทนที่จะปรับขนาดโฮมเซิร์ฟเวอร์ทั้งหมด |
| เครื่องโฮสต์มี RAM เหลืออยู่ แต่โปรแกรม Synapse ถูกปิดการทำงาน | ตรวจสอบขีดจำกัดหน่วยความจำของคอนเทนเนอร์, cgroup, systemd หรือ Kubernetes |
รายการตรวจสอบขั้นสุดท้าย
- ใช้งาน Synapse เวอร์ชันปัจจุบันที่ได้รับการสนับสนุน โดยเวอร์ชัน 1.162.0 เป็นเวอร์ชันเสถียรล่าสุด ณ วันที่ 6 ตุลาคม 2569
- ใช้ PostgreSQL สำหรับระบบการผลิต
- ตรวจสอบว่ากระบวนการใดกำลังใช้งาน RSS อยู่จริง และมีข้อจำกัดด้านหน่วยความจำเท่าใดสำหรับกระบวนการนั้น
- แยกความแตกต่างระหว่างการซิงค์แบบเพิ่มทีละขั้นปกติกับการซิงค์เริ่มต้น
- เปิดใช้งานการหมดอายุของแคชและปรับค่าตัวประกอบแคชทีละน้อย
- อย่าเปิดใช้งานการปรับแต่งแคชอัตโนมัติ เว้นแต่ว่ากำลังใช้งาน jemalloc และได้กำหนดค่าที่จำเป็นทั้งหมดแล้ว
- สำหรับการใช้งานในวงกว้าง ควรแยกการซิงค์เริ่มต้นออก หรือเพิ่มตัวทำงานซิงค์ทั่วไปเมื่อการวัดผลแสดงให้เห็นความเหมาะสม
- ตรวจสอบหน่วยความจำและเวลาแฝงพร้อมกันหลังจากทำการเปลี่ยนแปลงแต่ละครั้ง
Synapse จงใจใช้หน่วยความจำมาก เพราะการแคชเป็นส่วนหนึ่งของกลยุทธ์ด้านประสิทธิภาพ ดังนั้น วิธีแก้ไขที่ถูกต้องสำหรับความล้มเหลว OOM ที่เกี่ยวข้องกับการซิงค์จึงเป็นการสร้างสมดุล: ลบการเก็บรักษาแคชที่ไม่จำเป็น กำจัดฐานข้อมูลหรือคำขอที่ค้างอยู่ และแยกเวิร์กโหลดที่ผิดปกติโดยไม่ทำให้แคชที่ทำให้การซิงค์ปกติรวดเร็วนั้นขาดแคลน วิธีการนี้มีความน่าเชื่อถือมากกว่าการมองว่าตัวเลข RSS สูงสุดเป็นปัญหาเพียงอย่างเดียว
สำหรับข้อมูลการเผยแพร่เวอร์ชันล่าสุด โปรดดูที่หน้าข้อมูลการเผยแพร่เวอร์ชันอย่างเป็นทางการของ Element Synapse









