โฮมเซิร์ฟเวอร์ Matrix Synapse อาจดูเหมือนทำงานได้ปกติดีเป็นเวลาหลายวัน แล้วจู่ๆ ก็ทำให้ PostgreSQL ใช้ RAM ส่วนใหญ่ของเครื่องไป อาการที่พบได้ทั่วไปก็คือ พื้นที่สวอปเริ่มเพิ่มขึ้น การซิงค์ข้อมูลของไคลเอ็นต์ช้าลง งานเฟเดอเรชันค้างอยู่ในคิว และเซิร์ฟเวอร์ที่ปกติแล้วทำงานได้ไม่ซับซ้อนก็กลายเป็นจัดการได้ยาก ขั้นตอนแรกที่สำคัญคืออย่าเพิ่งคิดไปเองว่า PostgreSQL มีปัญหาหน่วยความจำรั่วไหล การใช้งานหน่วยความจำสูงอาจมาจากหลายแหล่งที่มาอย่างอิสระ รวมถึงแคชบัฟเฟอร์ที่ใช้ร่วมกัน หน่วยความจำทำงานต่อการสืบค้นข้อมูล ฐานข้อมูลหลายตัว ตัวจัดการการบำรุงรักษา และการสืบค้นข้อมูลที่ไม่มีประสิทธิภาพซึ่งเกิดจากสถิติที่ล้าสมัยหรือการเปลี่ยนแปลงตาราง
เอกสารของ Synapse เองแนะนำให้ใช้ PostgreSQL สำหรับการใช้งานจริง และเปิดเผยการควบคุมพูลการเชื่อมต่อฐานข้อมูล เช่นcp_minและcp_maxในขณะเดียวกัน PostgreSQL เตือนว่าการตั้งค่าเช่นwork_memสามารถถูกใช้โดยการดำเนินการหลายอย่างภายในคำสั่ง SQL เดียว และโดยหลายเซสชันพร้อมกัน การรวมกันดังกล่าวเป็นเหตุผลว่าทำไมการตั้งค่าที่ดูเหมือนไม่เป็นอันตรายเมื่อพิจารณาแยกต่างหาก อาจกลายเป็นเรื่องสิ้นเปลืองในช่วงเวลาที่มีการใช้งานมาก วิธีแก้ไขที่ปลอดภัยที่สุดคือการวัดผลก่อน ลดการทำงานพร้อมกันที่ไม่จำเป็นเป็นอันดับสอง จากนั้นปรับแต่งหน่วยความจำและพฤติกรรมการบำรุงรักษาเฉพาะในส่วนที่พบหลักฐานเท่านั้น
ขั้นตอนที่ 1: ยืนยันว่า PostgreSQL เป็นสาเหตุที่ทำให้เกิดการใช้หน่วยความจำมากเกินไปจริง ๆ
เริ่มต้นที่ระดับระบบปฏิบัติการ บน Linux ให้เปรียบเทียบหน่วยความจำทั้งหมด หน่วยความจำที่ใช้งานได้ หน่วยความจำสวอป และกระบวนการที่ใช้ทรัพยากรมากที่สุด:
free -h
ps aux --sort=-%mem | head -n 15
อย่าตัดสินเซิร์ฟเวอร์จากแค่บรรทัดคำสั่งเดียว PostgreSQL ใช้ทั้งหน่วยความจำร่วม (shared memory) และหน่วยความจำส่วนตัว (private memory) ในกระบวนการแบ็กเอนด์ ดังนั้นคำถามที่สำคัญกว่าคือ โฮสต์นั้นกำลังเผชิญกับแรงกดดันจริง ๆ หรือไม่ เช่น หน่วยความจำที่ใช้งานได้เหลือน้อย หน่วยความจำสวอปเพิ่มขึ้น การหยุดทำงานเนื่องจากหน่วยความจำไม่เพียงพอ (OOM kills) หรือความหน่วงแฝงที่ต่อเนื่อง บันทึกตัวเลขในช่วงเวลาที่เงียบและอีกครั้งในช่วงเวลาที่ยุ่ง การบันทึกค่าพื้นฐานนี้จะทำให้การเปลี่ยนแปลงในภายหลังสามารถวัดผลได้ แทนที่จะเป็นการคาดเดา
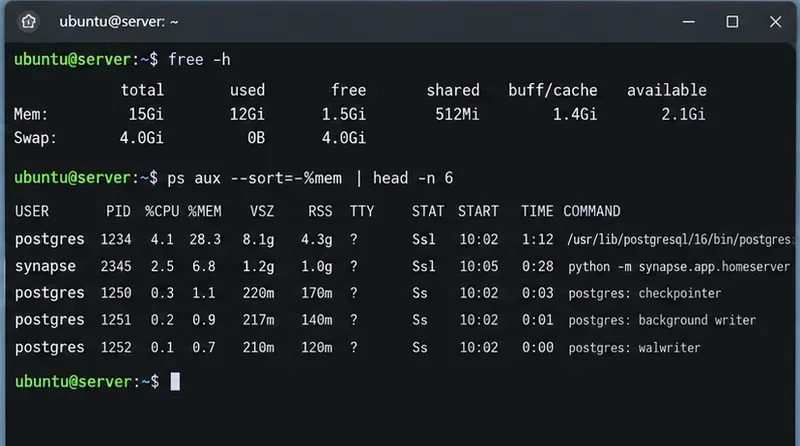
คำบรรยายภาพ: การตรวจสอบหน่วยความจำเบื้องต้นจะเปรียบเทียบ RAM ที่ใช้งานได้ในระดับโฮสต์กับกระบวนการของ PostgreSQL และ Synapse ก่อนที่จะมีการเปลี่ยนแปลงการกำหนดค่าใดๆ
ขั้นตอนต่อไป ให้ตรวจสอบการตั้งค่า PostgreSQL ที่อาจส่งผลต่อหน่วยความจำมากที่สุด:
SHOW shared_buffers;
SHOW work_mem;
SHOW maintenance_work_mem;
SHOW autovacuum_work_mem;
SHOW max_connections;
เอกสารเกี่ยวกับการใช้ทรัพยากรของ PostgreSQLอธิบายถึงความแตกต่างที่สำคัญshared_buffersคือแคชที่ใช้ร่วมกันทั่วทั้งเซิร์ฟเวอร์ ในทางตรงกันข้ามwork_memคือขีดจำกัดสำหรับการดำเนินการเรียงลำดับหรือแฮชแต่ละรายการก่อนที่จะถูกบันทึกไปยังไฟล์ชั่วคราว การค้นหาข้อมูลที่ซับซ้อนอาจมีการดำเนินการดังกล่าวหลายรายการ และหลายเซสชันสามารถเรียกใช้พร้อมกันได้ ปัจจุบัน PostgreSQL ระบุwork_memค่าเริ่มต้นไว้ที่ 4 MB และระบุว่าการใช้งานทั้งหมดอาจมากกว่าค่านี้หลายเท่า
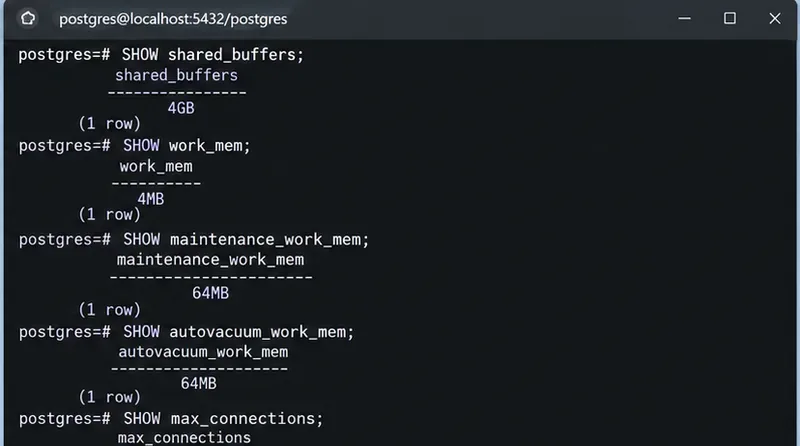
คำบรรยายภาพ: อ่านการตั้งค่าที่เกี่ยวข้องกับหน่วยความจำของ PostgreSQL ก่อนทำการเปลี่ยนแปลง การตั้งค่าที่อันตรายมักเป็นผลรวมของการตั้งค่าและการทำงานพร้อมกันมากกว่าตัวเลขเพียงตัวเดียว
ขั้นตอนที่ 2: นับจำนวนการเชื่อมต่อฐานข้อมูล Synapse และค้นหางานที่กำลังทำงานอยู่
พูลการเชื่อมต่อขนาดใหญ่ไม่ได้หมายความว่าจะใช้หน่วยความจำwork_memสำหรับทุกการเชื่อมต่อโดยอัตโนมัติ แต่แบ็กเอนด์ของ PostgreSQL แต่ละตัวจะมีกระบวนการและหน่วยความจำส่วนตัวของตนเอง และจำนวนการสืบค้นพร้อมกันที่มากขึ้นจะสร้างโอกาสในการจัดสรรหน่วยความจำต่อการดำเนินการมากขึ้น ตรวจสอบจำนวนการเชื่อมต่อที่เปิดอยู่จริงและสถานะของการเชื่อมต่อเหล่านั้น:
SELECT state,
       usename,
       application_name,
       count(*) AS connections
FROM pg_stat_activity
GROUP BY state, usename, application_name
ORDER BY connections DESC;
จากนั้นตรวจสอบคิวรีที่ใช้เวลานาน:
SELECT pid,
       usename,
       state,
       now() - query_start AS running_for,
       wait_event_type,
       wait_event,
       left(query, 180) AS query
FROM pg_stat_activity
WHERE state <> 'idle'
ORDER BY query_start;
เอกสารทางการ อธิบายถึงฟิลด์เซสชันและกิจกรรม จำนวนเซสชันที่ไม่ได้ใช้งานจำนวนมาก pg_stat_activityนั้นแตกต่างจากจำนวนการสืบค้นข้อมูลที่ใช้หน่วยความจำสูงจำนวนน้อย ดังนั้นวิธีการแก้ไขจึงควรแตกต่างกันด้วย หากปัญหาอยู่ที่จำนวนการเชื่อมต่อ ให้แก้ไขที่ขนาดของพูลการเชื่อมต่อ หากปัญหาอยู่ที่การสืบค้นข้อมูลที่ใช้หน่วยความจำสูงเพียงไม่กี่รายการ การลดขนาดพูลเพียงอย่างเดียวอาจเป็นการปกปิดอาการเท่านั้น
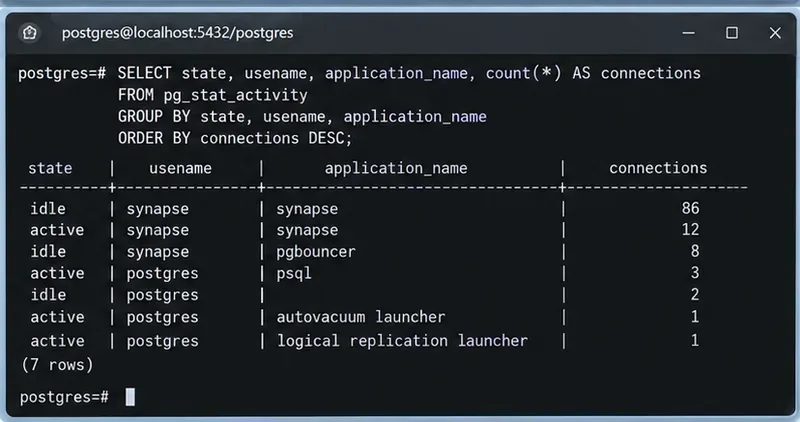
คำบรรยายภาพ: การจัดกลุ่มpg_stat_activityทำให้แยกแยะแบ็กเอนด์ที่ไม่ได้ใช้งานจำนวนมากออกจากเซสชันฐานข้อมูลที่ใช้งานอยู่จำนวนน้อยลงได้ง่ายขึ้น
ขั้นตอนที่ 3: ปรับขนาดพูลการเชื่อมต่อ Synapse PostgreSQL ให้เหมาะสม
Synapse ส่งผ่านอาร์กิวเมนต์ฐานข้อมูลส่วนใหญ่ไปยัง PostgreSQL ในขณะที่ใช้ตัวเลือกที่ขึ้นต้นด้วยcp_สำหรับพูลการเชื่อมต่อ Twisted ของมันคู่มือ Synapse PostgreSQL ฉบับปัจจุบัน แสดงตัวอย่างที่มีcp_min: 5และcp_max: 10โปรดถือว่าค่าเหล่านั้นเป็นเพียงตัวอย่าง ไม่ใช่เป้าหมายสากล
ตรวจสอบการdatabaseบล็อกในhomeserver.yaml:
database:
  name: psycopg2
  args:
    user: synapse_user
    password: "your-secret"
    dbname: synapse
    host: 127.0.0.1
    cp_min: 5
    cp_max: 10
หากก่อนหน้านี้คุณเพิ่มจำนวนการเชื่อมต่อ Synapse cp_maxอย่างรวดเร็วและ พบว่ามีการเชื่อมต่อที่ไม่ได้ใช้งานจำนวนมาก ให้ค่อยๆ ลดจำนวนการเชื่อมต่อลงและตรวจสอบความหน่วงของการร้องขอ ในการใช้งาน Synapse แบบใช้ Worker โปรดจำไว้ว่าความต้องการฐานข้อมูลมาจากกระบวนการ Synapse หลายกระบวนการ ดังนั้นควรประเมินจำนวนการเชื่อมต่อโดยรวมแทนที่จะประเมินจาก Worker เพียงตัวเดียว คู่มือการกำหนดค่า Synapseยืนยันว่าตัวเลือกต่างๆ จะกำหนดค่าพูลการเชื่อมต่อpg_stat_activitycp_
หลังจากแก้ไขการตั้งค่าแล้ว ให้รีสตาร์ทกระบวนการ Synapse ที่ได้รับผลกระทบตามวิธีการปรับใช้ของคุณ จากนั้นเรียกใช้คำสั่งตรวจสอบจำนวนการเชื่อมต่ออีกครั้ง อย่าลดขนาดพูลจนกว่าคำขอจะเริ่มเข้าคิวเพียงเพื่อประหยัดพื้นที่ไม่กี่เมกะไบต์ พูลที่มีขนาดเล็กเกินไปอาจทำให้การทำงานพร้อมกันของฐานข้อมูลกลายเป็นความหน่วงของแอปพลิเคชันได้
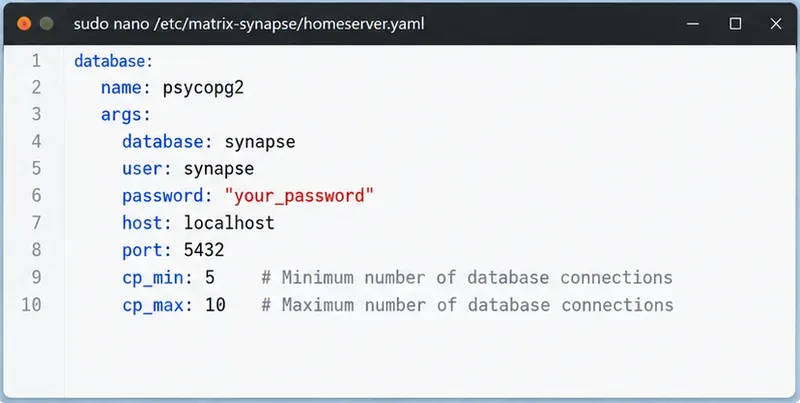
คำบรรยายภาพ: Synapse เปิดเผยcp_minและcp_maxกำหนดค่าฐานข้อมูล PostgreSQL ทำให้ผู้ดูแลระบบสามารถจำกัดการทำงานพร้อมกันที่ไม่จำเป็นของแบ็กเอนด์ได้
ขั้นตอนที่ 4: ปรับแต่งการใช้หน่วยความจำของ PostgreSQL อย่างระมัดระวัง
เมื่อจำนวนการเชื่อมต่ออยู่ในระดับที่เหมาะสมแล้ว ให้ตรวจสอบการตั้งค่าหน่วยความจำของ PostgreSQL โดยคำนึงถึง RAM ที่ฐานข้อมูลใช้งานได้จริง PostgreSQL ระบุว่าบนเซิร์ฟเวอร์ฐานข้อมูลเฉพาะที่มี RAM อย่างน้อย 1 GB ควรใช้หน่วยความจำระบบประมาณ 25% เป็นจุดเริ่มต้นที่เหมาะสมshared_buffersคำแนะนำนี้ใช้สำหรับเซิร์ฟเวอร์ฐานข้อมูลเฉพาะเท่านั้น หาก Synapse, reverse proxy, Redis, ระบบตรวจสอบ และ PostgreSQL ใช้ VM ขนาดเล็กเครื่องเดียวกัน PostgreSQL จะไม่ได้เป็นเจ้าของเครื่องทั้งหมด ดังนั้นควรจัดสรรงบประมาณให้เหมาะสม
การตั้งค่าที่อาจทำให้ผู้ดูแลระบบประหลาดใจมากที่สุดคือwork_memหลีกเลี่ยงการคูณwork_memด้วยmax_connectionsและถือว่าเป็นการจองแบบตายตัว เพราะ PostgreSQL ไม่ได้จัดสรรหน่วยความจำล่วงหน้าแบบนั้น แต่ให้คิดในแง่ของการดำเนินการสืบค้นพร้อมกัน การสืบค้นเดียวอาจใช้โหนดการเรียงลำดับหรือโหนดแฮชหลายโหนด และการดำเนินการแฮชอาจใช้จำนวนเท่าของwork_memหากคุณตั้งค่าwork_memเป็นตัวเลขที่มากมากเกินไปทั่วโลกเพราะรายงานหนึ่งทำงานช้า การเพิ่มขึ้นของข้อมูลจากระบบเครือข่ายหรือช่วงเวลาที่มีการซิงค์ข้อมูลจำนวนมากอาจทำให้การใช้หน่วยความจำสูงสุดมากกว่าที่คาดไว้มาก
รูปแบบที่เหมาะสมคือการตั้งค่าหน่วยความจำโดยรวมให้มีค่าปานกลาง และเพิ่มค่าเฉพาะในเซสชันการดูแลระบบที่เฉพาะเจาะจง เมื่อมีการสืบค้นข้อมูลที่ทราบว่าต้องการหน่วยความจำมากขึ้น ก่อนที่จะเปลี่ยนแปลงค่าใดๆ ให้เก็บรักษาการกำหนดค่าที่มีอยู่และจดบันทึกว่าพารามิเตอร์ใดบ้างที่ต้องรีสตาร์ท PostgreSQL shared_buffersตัวอย่างเช่น เป็นการตั้งค่าการเริ่มต้นเซิร์ฟเวอร์ ควรวางแผนการเปลี่ยนแปลงเพื่อให้คุณสามารถเปรียบเทียบหน่วยความจำ ความหน่วง และพฤติกรรมของไฟล์ชั่วคราวก่อนและหลังการเปลี่ยนแปลงได้
ตรวจสอบmaintenance_work_memและ เพิ่มเติมด้วย autovacuum_work_memPostgreSQL ระบุว่า worker ของ autovacuum สามารถจัดสรรหน่วยความจำสำหรับการบำรุงรักษาพร้อมกันได้ หากautovacuum_work_memปล่อยให้ทำงานตามค่าเริ่มต้น หน่วยความจำขนาดใหญ่ผิดปกติmaintenance_work_memอาจทำให้ worker ของ autovacuum หลายตัวทำงานพร้อมกันสิ้นเปลืองทรัพยากร อย่าปิดใช้งาน autovacuum เพื่อประหยัด RAM เพราะโดยปกติแล้วการทำเช่นนั้นจะแก้ปัญหาเรื่องหน่วยความจำในระยะสั้น แต่จะทำให้ตารางมีขนาดใหญ่ขึ้น สถิติไม่ทันสมัย และประสิทธิภาพแย่ลง
ขั้นตอนที่ 5: ตรวจสอบสภาพการทำงานของเครื่องดูดฝุ่น จากนั้นทดสอบการแก้ไขปัญหาภายใต้ภาระการใช้งานจริง
Synapse เขียนและอัปเดตข้อมูลเหตุการณ์และสถานะจำนวนมาก PostgreSQL จำเป็นต้องมีการล้างข้อมูล (vacuum) เป็นประจำเพื่อเรียกคืนทูเพิลที่ไม่ได้ใช้งานแล้วกลับมาใช้ใหม่ และเพื่อให้สถิติของตัววางแผนเป็นปัจจุบันอยู่เสมอคู่มือการล้างข้อมูลเป็นประจำของ PostgreSQLแนะนำให้ใช้ autovacuum สำหรับการติดตั้งส่วนใหญ่
มองหาตารางที่มีทูเพิลที่คาดว่าตายแล้วจำนวนมาก หรือมีเวลาประทับการบำรุงรักษาที่ล้าสมัย:
SELECT relname,
       n_live_tup,
       n_dead_tup,
       last_autovacuum,
       last_autoanalyze
FROM pg_stat_user_tables
ORDER BY n_dead_tup DESC
LIMIT 20;
หากตารางใดตารางหนึ่งต้องการการดูแลเป็นพิเศษVACUUM (ANALYZE)เครื่องมือปรับแก้แบบแมนนวลมักจะเป็นเครื่องมือแรกที่ควรพิจารณา:
VACUUM (ANALYZE) your_table_name;
หลีกเลี่ยงการข้ามไปใช้คำสั่ง `vacuum` โดยตรงVACUUM FULLเอกสารอ้างอิงอย่างเป็นทางการของ VACUUMอธิบายว่า `vacuum` แบบปกติVACUUMสามารถทำงานควบคู่ไปกับการอ่านและการเขียนตามปกติได้ ในขณะที่ `vacuum` VACUUM FULLจะเขียนทับตารางและล็อกACCESS EXCLUSIVEข้อมูล ควรใช้คำสั่งหลังเฉพาะเมื่อการเรียกคืนพื้นที่ดิสก์คุ้มค่ากับการหยุดชะงักที่วางแผนไว้
วิธีสังเกตว่าการเปลี่ยนแปลงนั้นได้ผลจริงหรือไม่
ตรวจสอบผลลัพธ์โดยใช้ภาระงานแบบเดียวกันกับที่ทำให้เกิดปัญหา การแก้ไขที่ได้ผลไม่ได้หมายความว่า "Postgres ใช้ RAM น้อยลงทันที" เพราะแคชของฐานข้อมูลควรใช้หน่วยความจำ ดังนั้น ให้ตรวจสอบว่ามีหน่วยความจำที่ใช้งานได้คงที่หรือไม่ มีการเติบโตของ swap น้อยหรือไม่มีเลย ไม่มีเหตุการณ์ OOM (Out of Memory) จำนวนการเชื่อมต่อตรงกับการทำงานพร้อมกันที่คาดไว้ และเวลาตอบสนองของ Synapse อยู่ในระดับที่ยอมรับได้
- เรียกใช้
free -hและแสดงรายการกระบวนการโดยใช้ระดับการรับส่งข้อมูลเดียวกันกับที่ใช้สำหรับค่าพื้นฐานของคุณ
- ทำการสอบถามการเชื่อมต่อ ซ้ำอีกครั้ง
pg_stat_activityและยืนยันว่าจำนวนแบ็กเอนด์ที่ไม่ได้ใช้งานลดลง หากคุณได้เปลี่ยนพูล Synapse แล้ว
- ตรวจสอบความหน่วงในการสืบค้นและซิงค์ข้อมูลหลังจากลดค่าลง
cp_maxหากพบว่าเวลารอฐานข้อมูลเพิ่มขึ้นอย่างเห็นได้ชัด ให้ยกเลิกการเปลี่ยนแปลงนั้น
- ตรวจสอบ
pg_stat_user_tablesเป็นระยะเพื่อให้แน่ใจว่าระบบดูดฝุ่นอัตโนมัติทำงานที่โต๊ะที่มีคนใช้งานอยู่จริง
- หากคุณลดค่าลงแล้ว
work_memให้ตรวจสอบว่าการเรียงลำดับขนาดใหญ่มีการถ่ายโอนข้อมูลไปยังไฟล์ชั่วคราวมากเกินไปหรือไม่ ก่อนที่จะลดค่าลงอีก
หาก PostgreSQL ยังคงใช้หน่วยความจำเพิ่มขึ้นจนกระทั่งโฮสต์ต้องใช้หน่วยความจำเสมือนจำนวนมากหลังจากตรวจสอบเหล่านี้แล้ว ให้บันทึกรายการคำสั่ง SQL ที่ใช้งานอยู่ระหว่างที่มีการใช้หน่วยความจำสูง และตรวจสอบปริมาณงานแทนที่จะลดขีดจำกัดหน่วยความจำโดยรวมซ้ำๆ ในเวอร์ชัน PostgreSQL ที่รองรับpg_backend_memory_contextsสามารถตรวจสอบบริบทหน่วยความจำสำหรับแบ็กเอนด์ปัจจุบันได้เอกสารประกอบเกี่ยวกับมุมมองระบบของ PostgreSQLอธิบายถึงมุมมองและสิทธิ์การเข้าถึง ซึ่งมีประโยชน์มากกว่าสำหรับการตรวจสอบฐานข้อมูลอย่างเจาะจงมากกว่าการสันนิษฐานว่าการใช้งาน Synapse ที่ใช้หน่วยความจำสูงทุกครั้งมีสาเหตุเดียวกัน
สรุปแล้ว
สำหรับ Matrix Synapse บน PostgreSQL การแก้ไขปัญหาการใช้หน่วยความจำฐานข้อมูลสูงอย่างปลอดภัยที่สุดคือการจัดการเป็นชั้นๆ โดยตรวจสอบให้แน่ใจว่าโฮสต์กำลังประสบปัญหาการใช้หน่วยความจำจริง นับจำนวนเซสชันของฐานข้อมูล ปรับขนาดพูลของ Synapse ให้เหมาะสม รักษาการใช้หน่วยความจำต่อการดำเนินการของ PostgreSQL ให้อยู่ในระดับที่เหมาะสม และตรวจสอบให้แน่ใจว่า autovacuum ทำงานได้อย่างมีประสิทธิภาพ เป้าหมายไม่ใช่การลดขนาดการใช้หน่วยความจำของ PostgreSQL ให้เหลือน้อยที่สุด แต่เป้าหมายคือการใช้หน่วยความจำที่คาดการณ์ได้โดยไม่ทำให้การแคชและการทำงานพร้อมกันของฐานข้อมูลกลายเป็นปัญหา swap ที่สามารถหลีกเลี่ยงได้ ปัญหา OOM หรือทำให้ไคลเอนต์ Matrix ทำงานช้าลง