คู่มือสำหรับผู้เริ่มต้นนี้จะสร้างคลัสเตอร์แบบแอคทีฟ/พาสซีฟสองโหนดพื้นฐานโดยใช้ SUSE Linux Enterprise High Availability (SLE HA) 15 โดยใช้สคริปต์บูตสแตรป CRM Shell ที่รองรับ: เริ่มต้นโหนดแรกด้วย คำสั่ง ` crm cluster initstartup` เพิ่มโหนดที่สองด้วยคำสั่ง `add` crm cluster joinตรวจสอบสมาชิก และทดสอบการเฟลโอเวอร์ที่วางแผนไว้ของ IP เสมือนสำหรับการจัดการ ตัวอย่างเหล่านี้เป็นไปตามเอกสาร SUSE SLE HA 15 SP7 ที่เผยแพร่เมื่อวันที่ 24 กันยายน 2026 ข้อความแจ้งเตือนอาจแตกต่างกันไปตาม Service Pack ฮาร์ดแวร์ และแพลตฟอร์ม
“HAE” มักใช้เรียกอย่างไม่เป็นทางการสำหรับ High Availability Extension เอกสารผลิตภัณฑ์ปัจจุบันของ SUSE เรียกมันว่า SUSE Linux Enterprise High Availability หรือ SLE HA กระบวนการนี้จะวางรากฐานคลัสเตอร์ที่ใช้งานได้และให้สิทธิ์การเข้าถึงการจัดการ Hawk2 แต่ไม่ได้ทำให้แอปพลิเคชัน ฐานข้อมูล หรือข้อมูลในนั้นมีความพร้อมใช้งานสูงโดยอัตโนมัติ สิ่งเหล่านี้จำเป็นต้องมีทรัพยากร Pacemaker การออกแบบพื้นที่จัดเก็บข้อมูล และการทดสอบเฉพาะสำหรับภาระงานของตนเอง
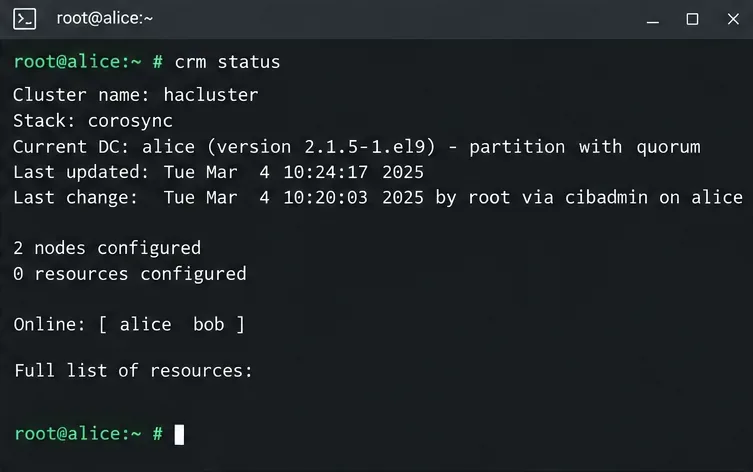
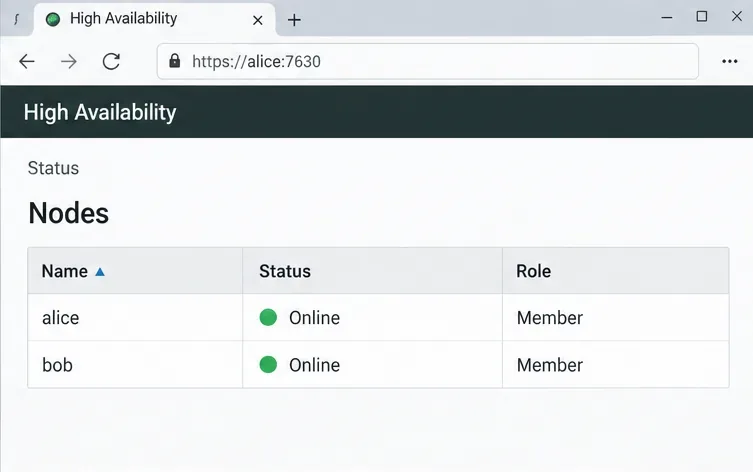
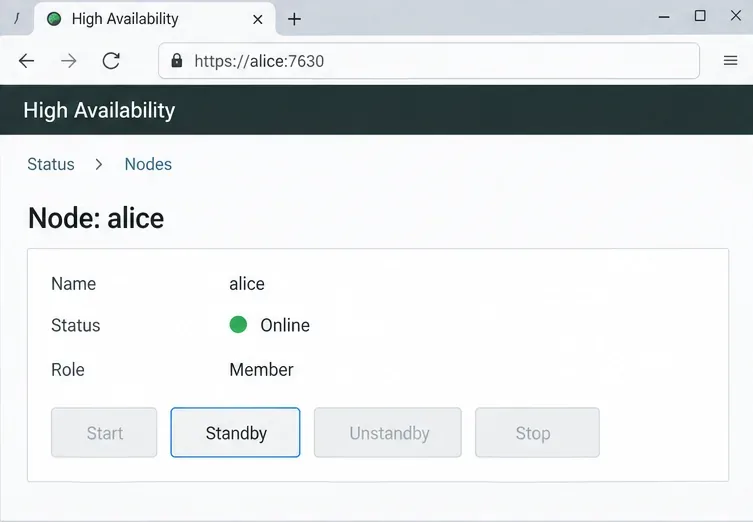
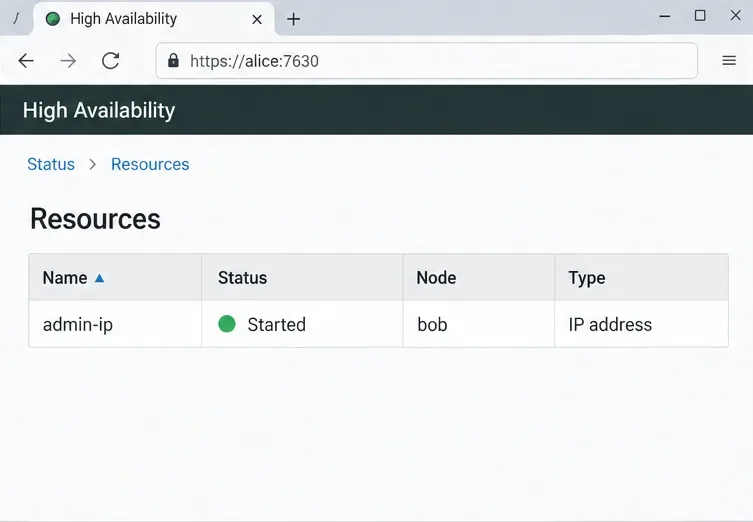
ภาพประกอบหน้าจอเทอร์มินัลและ Hawk2 ด้านล่างแสดงมุมมองอินเทอร์เฟซตัวอย่าง ไม่ใช่ภาพที่แคปมาจากระบบที่ใช้งานจริง ชื่อและที่อยู่เป็นเพียงตัวอย่าง โปรดแทนที่ด้วยค่าจากเครือข่ายของคุณ
กลุ่มคลัสเตอร์นี้จะทำอะไร?
คลัสเตอร์คือกลุ่มของเซิร์ฟเวอร์ที่เรียกว่าโหนด ซึ่งทำงานร่วมกันเพื่อให้บริการที่เลือกไว้ทำงานได้อย่างต่อเนื่อง Corosync ทำหน้าที่จัดการการเป็นสมาชิกของโหนดและการส่งข้อความภายในคลัสเตอร์ ส่วน Pacemaker ซึ่งเป็นตัวจัดการทรัพยากรของคลัสเตอร์ จะตัดสินใจว่าทรัพยากรที่ได้รับการจัดการควรทำงานอยู่ที่ใดและตอบสนองต่อความล้มเหลวทรัพยากร คือบริการหรือที่อยู่ซึ่ง Pacemaker สามารถเริ่มต้น หยุด ตรวจสอบ และย้ายได้
ในตัวอย่างการใช้งานนี้ โหนดaliceสองbobโหนดจะประกอบกันเป็นคลัสเตอร์สองโหนด IP สำหรับการจัดการแบบลอยตัวจะช่วยให้ผู้ดูแลระบบมีที่อยู่ IP ที่เสถียรสำหรับ Hawk2 ซึ่งเป็นเว็บอินเทอร์เฟซของ SUSE หากโหนดใดโหนดหนึ่งอยู่ในโหมดสแตนด์บาย Pacemaker สามารถย้าย IP นั้นไปยังโหนดอื่นได้ สำหรับคลัสเตอร์สองโหนดในสภาพแวดล้อมการใช้งานจริง SUSE แนะนำให้เพิ่ม QDevice/QNetd สำหรับการตัดสินใจเกี่ยวกับจำนวนเสียงข้างมาก และกำหนดให้ต้องมีการป้องกันโหนด (node fencing)
คุณควรเตรียมอะไรบ้างก่อนการติดตั้ง?
ระบบ SUSE Linux Enterprise Server 15 ที่รองรับสองระบบ ซึ่งใช้ Service Pack และสถาปัตยกรรมโปรเซสเซอร์เดียวกัน โดยมีบัญชีผู้ใช้ root หรือบัญชี sudo ที่มีสิทธิ์เหมาะสม
ต้องมีการลงทะเบียน SUSE ที่ถูกต้องและสิทธิ์ในการใช้งาน SLE HA บนทุกโหนด ส่วนขยายและรูปแบบแพ็กเกจต้องตรงกับ Service Pack และสถาปัตยกรรมของ SLES
การกำหนดที่อยู่โหนดแบบคงที่ การแก้ไขชื่อที่ใช้งานได้จริง นาฬิกาที่ซิงโครไนซ์กัน และการเชื่อมต่อเครือข่ายคลัสเตอร์ที่เชื่อถือได้ เลือกอินเทอร์เฟซ Corosync ที่ต้องการอย่างรอบคอบ เส้นทางที่แยกจากกันหรือสำรองไว้จะมีประโยชน์ในการออกแบบสำหรับการใช้งานจริง
แผนการป้องกันเครือข่าย (Fencing plan) การป้องกันเครือข่าย (ตามแนวคิดของ STONITH ที่ว่า “ยิงโหนดอื่นที่หัว”) จะแยกหรือรีบูตโหนดที่อาจไม่ทำงานอย่างมีประสิทธิภาพ เพื่อป้องกันไม่ให้ทั้งสองฝั่งของเครือข่ายที่ถูกแยกเขียนข้อมูลลงในข้อมูลที่ใช้ร่วมกัน คลัสเตอร์ที่รองรับจะต้องเปิดใช้งานการป้องกันเครือข่ายนี้
หากใช้ SBD (STONITH Block Device) ควรมี watchdog ที่เหมาะสมในแต่ละโหนด และพื้นที่จัดเก็บข้อมูลแบบบล็อกที่ใช้ร่วมกันซึ่งออกแบบมาอย่างเหมาะสมพร้อมเส้นทางอุปกรณ์ที่เสถียร ควรใช้ watchdog แบบฮาร์ดแวร์สำหรับการใช้งานจริง หากใช้ power fence ทางกายภาพแทน ควรตั้งค่าและทดสอบอุปกรณ์ STONITH ที่รองรับ
สำหรับระบบที่มีสองโหนด ควรวางแผนติดตั้ง QDevice/QNetd witness ก่อนเริ่มใช้งาน หากคุณตั้งใจจะกำหนดค่าผ่านกระบวนการ bootstrap witness จะช่วยให้คลัสเตอร์ตัดสินใจได้ว่าฝั่งใดมีจำนวนโหนดเพียงพอเมื่อการเชื่อมต่อขาดหายไป
อย่าถือว่าการตั้งค่าในห้องปฏิบัติการพร้อมใช้งานในสภาพแวดล้อมการใช้งานจริงข้อกำหนดของระบบ SLE HA 15 SP7 ของ SUSE กำหนด ให้ต้องมีการป้องกันการเข้าถึง (fencing) และภาพรวมการติดตั้ง แนะนำให้ทดสอบการตั้งค่าด้วยโหนดสองหรือสามโหนดก่อนที่จะขยายเพิ่มเติม
ขั้นตอนที่ 1: ติดตั้งส่วนขยาย SLE HA และแพ็กเกจต่างๆ
หากไม่ได้เลือก SLE HA ระหว่างการติดตั้ง SLES ให้เปิดใช้งานส่วนขยายบนแต่ละโหนด สำหรับโฮสต์ x86_64 SLES 15 SP7 ที่ลงทะเบียนแล้ว รูปแบบที่ระบุไว้ในเอกสารมีดังนี้:
SUSEConnect -p sle-ha/15.7/x86_64 -r ADDITIONAL_REGCODE
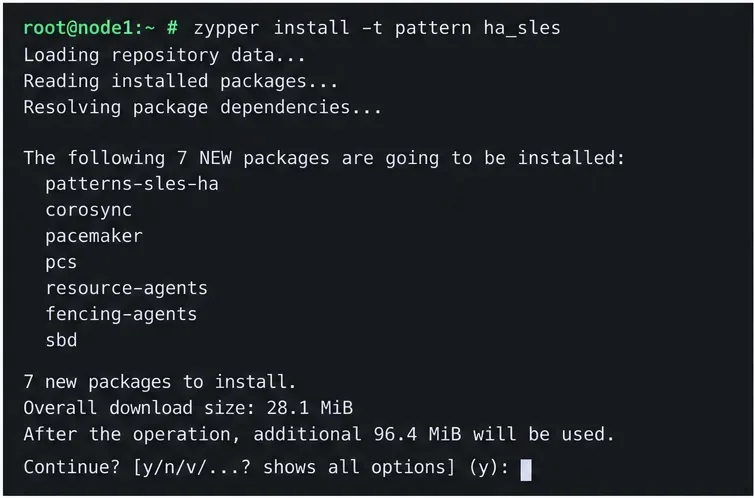
zypper install -t pattern ha_slesแทนที่ADDITIONAL_REGCODEด้วยรหัสลงทะเบียน SLE HA ใช้ตัวระบุผลิตภัณฑ์การเปิดใช้งานที่ตรงกับ Service Pack และสถาปัตยกรรมของคุณเอง อย่าคัดลอกตัวอย่าง SP7 ไปยัง Service Pack SLES 15 อื่น เรียกใช้คำสั่ง package-pattern บนทั้งสองโหนด เอกสารของ SUSE ระบุha_slesรูปแบบนี้ว่าเป็นชุดของแพ็กเกจที่ใช้ในการกำหนดค่าและจัดการคลัสเตอร์
ภาพแสดงคำสั่งติดตั้งรูปแบบความพร้อมใช้งานสูง (High Availability pattern) บนโหนดแรกในหน้าจอเทอร์มินัล ขั้นตอนที่ 2: เตรียมชื่อ เวลา และการเข้าถึงเครือข่าย
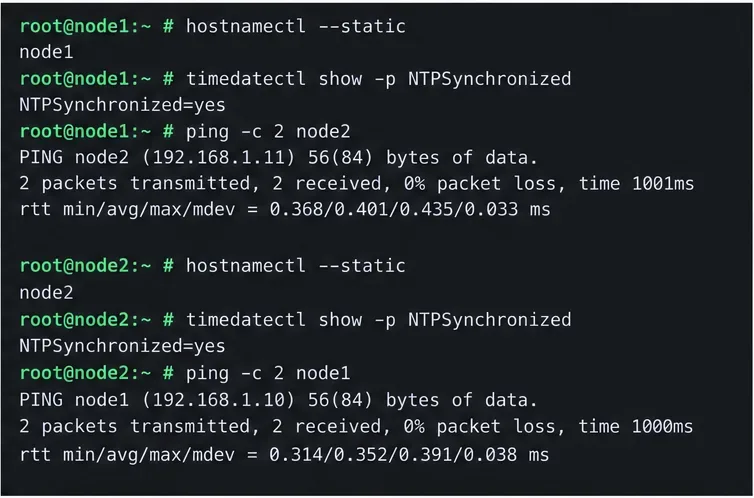
ตั้งชื่อโฮสต์ที่เสถียรและกำหนดที่อยู่ IP หลักแบบคงที่ให้กับทั้งสองโหนด ตรวจสอบให้แน่ใจว่าแต่ละโหนดสามารถระบุชื่อของอีกโหนดได้ทั้งโดยใช้ชื่อย่อและชื่อเต็ม คำแนะนำในการตั้งค่าของ SUSE แนะนำให้ระบุรายชื่อสมาชิกคลัสเตอร์/etc/hostsเมื่อจำเป็น เนื่องจากความล้มเหลวในการระบุชื่ออาจทำให้การสื่อสารภายในหยุดชะงัก ตัวอย่างเช่น ปรับรายการเหล่านี้ให้เข้ากับแผน DNS และที่อยู่ของคุณ:
10.20.0.11 alice.example.net alice
10.20.0.12 bob.example.net bob
ซิงโครไนซ์นาฬิกาทั้งสองกับแหล่ง NTP ภายนอกคลัสเตอร์และรักษาเขตเวลาให้สอดคล้องกัน Chrony เป็นการใช้งาน NTP เริ่มต้นใน SLES 15 ตรวจสอบการเชื่อมต่อบนเครือข่ายที่คุณวางแผนจะใช้สำหรับ Corosync สคริปต์บูตสแตรปสามารถเปิดพอร์ตไฟร์วอลล์ที่จำเป็นสำหรับการสื่อสารในคลัสเตอร์ได้ แต่ยืนยันว่าไฟร์วอลล์ของโฮสต์และเครือข่ายของคุณอนุญาตการรับส่งข้อมูลที่จำเป็นสำหรับโทโพโลยีที่คุณเลือก Unicast เป็นค่าเริ่มต้นในขั้นตอนการบูตสแตรป พอร์ต Corosync เริ่มต้นที่ระบุไว้คือ 5405
การตรวจสอบก่อนเริ่มบินจะยืนยันชื่อโหนดตัวอย่าง นาฬิกาที่ซิงโครไนซ์กัน และการเชื่อมต่อกับโหนดอื่น ขั้นตอนที่ 3: เริ่มต้นใช้งานโหนดแรก
ในวันที่ดังaliceกล่าว ให้รันคำสั่ง bootstrap ในฐานะผู้ใช้ root:
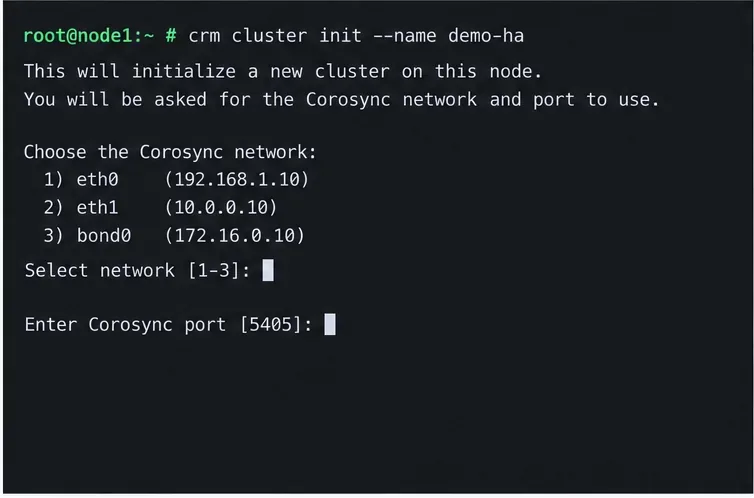
crm cluster init --name demo-haตรวจสอบข้อความแจ้งเตือนก่อนยอมรับ เลือกอินเทอร์เฟซและที่อยู่เครือข่ายที่ต้องการใช้สำหรับ Corosync จากนั้นยืนยันพอร์ต สคริปต์จะตรวจสอบการซิงโครไนซ์เวลาและความพร้อมใช้งานของวอชด็อก และสามารถเตรียมคีย์ SSH และการกำหนดค่าคลัสเตอร์ที่เกี่ยวข้องได้ สคริปต์จะถามว่าต้องการกำหนดค่า SBD ซึ่งเป็น IP เสมือนสำหรับการดูแลระบบ Hawk2 และ QDevice/QNetd หรือไม่ SBD ต้องการให้วอชด็อกและอุปกรณ์ที่ใช้ร่วมกันพร้อมใช้งานแล้ว หากกำหนดค่า QDevice ในการบูตสแตรปนี้ ให้เตรียมเซิร์ฟเวอร์ QNetd ก่อน สคริปต์จะสร้างคลัสเตอร์แบบโหนดเดียวที่ทำงานอยู่ โดยจะไม่เพิ่มโหนดอื่นbobในขั้นตอนนี้
อย่าเลือกดิสก์ที่ใช้ร่วมกันแบบสุ่มหรือเส้นทางอุปกรณ์สำหรับ SBD เส้นทางนั้นต้องระบุพื้นที่จัดเก็บข้อมูลที่เหมาะสมเดียวกันในทุกโหนด และพฤติกรรมการทำงานผิดพลาดและระยะเวลาหมดเวลาต้องตรงกับการออกแบบพื้นที่จัดเก็บข้อมูล SUSE ระบุว่าsoftdogไม่สามารถรีบูตเครื่องได้หากซีพียูทั้งหมดค้าง ดังนั้นควรใช้ฮาร์ดแวร์วอทช์ด็อกที่ถูกต้องสำหรับการใช้งานจริงทุกครั้งที่มีให้ใช้งาน
ขั้นตอนการบูตโหนดแรกจะแจ้งให้ระบุเครือข่ายการสื่อสารของคลัสเตอร์และพอร์ต Corosync ขั้นตอนที่ 4: เชื่อมต่อโหนดที่สอง
หลังจากเริ่มต้นโหนดแรกแล้ว ให้ล็อกอินเข้าสู่ระบบbobและเรียกใช้คำสั่ง:
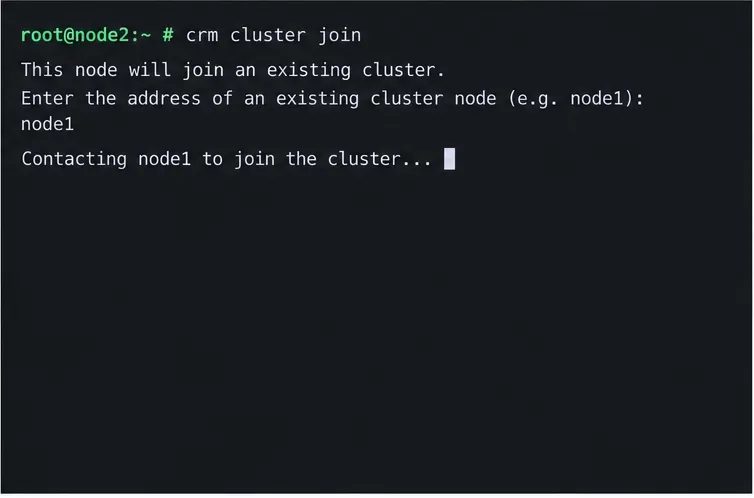
crm cluster joinทำตามคำแนะนำเพื่อระบุโหนดคลัสเตอร์ที่มีอยู่aliceหากคุณใช้บัญชี sudo แทนบัญชี root สำหรับโหนดแรก เอกสารของ SUSE ระบุบัญชีนั้นด้วย-cเช่น:
sudo crm cluster join -c USER@aliceสคริปต์การเข้าร่วมจะคัดลอกการตั้งค่า Corosync กำหนดค่า SSH และ Csync2 ทำให้เครื่องปัจจุบันออนไลน์เป็นโหนดคลัสเตอร์ และเริ่มต้นบริการที่จำเป็นสำหรับ Hawk2 อย่าเริ่มต้นเครื่องทั้งสองเครื่องแยกจากกัน โหนดที่สองต้องเข้าร่วมคลัสเตอร์ที่สร้างโดยโหนดแรก
เรียกใช้เวิร์กโฟลว์การเชื่อมต่อบนโหนดที่สองและชี้ไปยังโหนดแรกที่เริ่มต้นใช้งานแล้ว ขั้นตอนที่ 5: ตรวจสอบว่าโหนดทั้งสองออนไลน์อยู่
ตรวจสอบสรุปข้อมูลคลัสเตอร์ได้จากโหนดใดก็ได้:
crm statusมองหาทั้งชื่อโหนดOnlineและพาร์ติชันคลัสเตอร์ที่มีควอรัม ตรวจสอบการดำเนินการที่ล้มเหลวหรือโหนดที่ออฟไลน์ก่อนดำเนินการต่อ คุณยังสามารถลงชื่อเข้าใช้ Hawk2 โดยใช้ VIP ผู้ดูแลระบบที่เลือกไว้ระหว่างการเริ่มต้นใช้งาน ซึ่งโดยทั่วไปจะอยู่ที่https://ADMIN-VIP:7630/คำเตือนเกี่ยวกับใบรับรองการเข้าใช้งานครั้งแรกอาจเกิดขึ้นเมื่อมีการใช้ใบรับรองที่ลงนามด้วยตนเอง ตรวจสอบรายละเอียดใบรับรองกับผู้ดูแลระบบคลัสเตอร์แทนที่จะเพิกเฉยต่อใบรับรองที่ไม่รู้จักในสภาพแวดล้อมการใช้งานจริง
การตรวจสอบสถานะคลัสเตอร์ควรแสดงว่าโหนดทั้งสองออนไลน์ก่อนที่จะทดสอบการสลับไปใช้โหนดสำรอง (failover) รายการโหนดเป็นอีกวิธีหนึ่งในการยืนยันการเป็นสมาชิกของคลัสเตอร์ ขั้นตอนที่ 6: รักษาความปลอดภัยบัญชีการจัดการ
ขั้นตอนการบูตระบบจะสร้างhaclusterบัญชีสำหรับ Hawk2 คู่มือการติดตั้งของ SUSE ระบุรหัสผ่านเริ่มต้นไว้ในระหว่างการติดตั้งขั้นพื้นฐาน ดังนั้นควรเปลี่ยนรหัสผ่านทันทีก่อนที่จะออกจากระบบและปล่อยให้ระบบเข้าถึงได้
passwd haclusterใช้รหัสผ่านที่ปลอดภัยและไม่ซ้ำใคร และปฏิบัติตามนโยบายการรับรองความถูกต้องขององค์กร จำกัดการเข้าถึงเครือข่ายการจัดการ Hawk2 ติดตั้งใบรับรองที่เชื่อถือได้ตามความเหมาะสม และอย่าเปิดเผยอินเทอร์เฟซการจัดการสู่สาธารณะทางอินเทอร์เน็ตโดยตรง
ขั้นตอนที่ 7: ทดสอบการสลับระบบเมื่อเกิดข้อผิดพลาดอย่างปลอดภัย
การทดสอบสแตนด์บายที่วางแผนไว้จะตรวจสอบว่า IP เสมือนสำหรับการจัดการสามารถเคลื่อนย้ายได้หรือไม่ เมื่อโหนดหนึ่งถูกลบออกจากตำแหน่งการจัดสรรทรัพยากรโดยเจตนา ก่อนทำการทดสอบ โปรดตรวจสอบให้แน่ใจว่าทั้งสองโหนดทำงานได้อย่างปกติ คลัสเตอร์มีจำนวนสมาชิกครบตามที่กำหนด และคุณสามารถเข้าถึงคอนโซลหรือการเข้าถึงนอกแบนด์ได้ในกรณีที่เกิดพฤติกรรมที่ไม่คาดคิด ตัวอย่างเช่น จากไคลเอนต์บนเครือข่ายเดียวกัน ให้ทำการ ping ไปยัง VIP สำหรับการจัดการอย่างต่อเนื่อง:
ping 10.20.0.20ใน Hawk2 ให้เปิดโหนดที่กำลังโฮสต์ IP สำหรับการดูแลระบบ แล้วเลือกStandby จากนั้นตรวจสอบStatus > Resources คู่มือ เริ่มต้นใช้งานฉบับย่อของ SUSE อธิบายว่าทรัพยากรแบบลอยตัวจะย้ายไปยังโหนดอื่นในขณะที่การทดสอบ ping ยังคงดำเนินต่อไป เมื่อการทดสอบเสร็จสิ้น ให้คืนค่าโหนดกลับสู่การใช้งานโดยใช้การดำเนินการที่เกี่ยวข้องของ Hawk2 ยืนยันว่าทั้งสองโหนดออนไลน์ และตรวจสอบว่าทรัพยากรอยู่ในตำแหน่งที่คาดไว้
ใช้การดำเนินการสแตนด์บายที่วางแผนไว้บนโหนดที่ใช้งานอยู่เพื่อทดสอบการเคลื่อนย้ายทรัพยากรโดยไม่ต้องจำลองการขัดข้อง หลังจากโหมดสแตนด์บายเสร็จสิ้น ให้ตรวจสอบว่า IP สำหรับการดูแลระบบทำงานอยู่บนโหนดอื่นหรือไม่ การทดสอบนี้พิสูจน์อะไรได้บ้าง และพิสูจน์อะไรไม่ได้บ้าง?
หากโหนดทั้งสองยังคงมองเห็นได้ และ IP สำหรับการดูแลระบบย้ายไปยังโหนดปลายทาง แสดงว่าการเป็นสมาชิกคลัสเตอร์ขั้นพื้นฐานและทรัพยากร IP แบบลอยตัวทำงานได้ในสถานการณ์ที่วางแผนไว้ การ ping เพียงอย่างเดียวไม่ได้พิสูจน์ว่าแอปพลิเคชันพร้อมใช้งาน เซสชันของไคลเอ็นต์ยังคงอยู่ ข้อมูลที่ใช้ร่วมกันได้รับการปกป้อง หรือคลัสเตอร์สามารถกู้คืนจากความล้มเหลวของเครือข่าย พื้นที่จัดเก็บ ไฟฟ้า หรือซอฟต์แวร์ได้ทุกครั้ง
สำหรับแอปพลิเคชัน ให้เพิ่มเอเจนต์ทรัพยากรที่ถูกต้องและกำหนดค่าการจัดลำดับ การจัดวางร่วม การตรวจสอบ การเข้าถึงพื้นที่จัดเก็บ และการป้องกันตามการออกแบบของแอปพลิเคชัน ห้ามปล่อยให้โหนดสองโหนดเขียนข้อมูลลงในพื้นที่จัดเก็บร่วมทั่วไปพร้อมกัน ทดสอบการกู้คืนเวิร์กโหลดและความสมบูรณ์ของข้อมูลในสภาพแวดล้อมทดสอบ รวมถึงความล้มเหลวของโหนดและเครือข่ายที่สมจริง ก่อนนำไปใช้งานจริง
ข้อผิดพลาดทั่วไปที่ควรหลีกเลี่ยง
การข้ามขั้นตอนการทำรั้วกั้น: คลัสเตอร์ที่ไม่มี STONITH ที่ใช้งานได้จะไม่สามารถแก้ไขปัญหา split-brain ได้อย่างปลอดภัย และไม่ตรงตามข้อกำหนดด้านการสนับสนุนของ SUSEสมมติว่าโหนดสองโหนดสามารถตัดสินใจได้ด้วยตนเอง: วางแผน QDevice/QNetd สำหรับคลัสเตอร์ที่มีจำนวนโหนดเป็นเลขคู่ โดยเฉพาะคลัสเตอร์ที่มีสองโหนดการใช้ข้อมูลประจำตัวโหนดที่ไม่เสถียรหรือไม่ตรงกัน: ควรใช้ที่อยู่แบบคงที่ ชื่อโฮสต์ที่สอดคล้องกัน การแก้ไขชื่อที่ใช้งานได้ทั้งแบบไปข้างหน้าและย้อนกลับ และการซิงโครไนซ์เวลาการใช้งานเครือข่ายผิด: เลือกอินเทอร์เฟซ Corosync ที่ต้องการ และตรวจสอบนโยบายไฟร์วอลล์ในทุกเส้นทางเครือข่ายโดยสมมติว่าคลัสเตอร์จะปกป้องแอปโดยอัตโนมัติ: คลัสเตอร์สามารถจัดการได้เฉพาะทรัพยากรที่ได้รับการกำหนดค่าและทดสอบแล้วเท่านั้นการเรียกขั้นตอนการบูตสแตรปเบื้องต้นว่า “พร้อมใช้งานจริง” นั้นหมายความว่า การเริ่มต้นอย่างรวดเร็วเป็นการตั้งค่าพื้นฐานเท่านั้น ความพร้อมสำหรับการใช้งานจริงนั้นจำเป็นต้องมีการทดสอบการกู้คืนเฉพาะงาน การตรวจสอบความถูกต้องของการป้องกัน การตรวจสอบ การสำรองและกู้คืนข้อมูล และการดำเนินงานที่จัดทำเป็นเอกสาร
เอกสารอ้างอิงอย่างเป็นทางการจาก SUSE