Ein Matrix Synapse Homeserver kann tagelang einwandfrei funktionieren und dann plötzlich PostgreSQL den Großteil des verfügbaren Arbeitsspeichers belegen lassen. Die typischen Symptome sind bekannt: Der Swap-Speicher wächst, Client-Synchronisierungen verlangsamen sich, Federation-Jobs stauen sich, und ein ansonsten sparsamer Server wird schwer zu verwalten. Wichtig ist, nicht voreilig von einem Speicherleck in PostgreSQL auszugehen. Hohe Speicherauslastung kann verschiedene Ursachen haben, darunter der gemeinsam genutzte Puffer-Cache, der Arbeitsspeicher pro Abfrage, viele Datenbank-Backends, Wartungsprozesse und ineffiziente Abfragen aufgrund veralteter Statistiken oder häufiger Tabellenänderungen.
cp_minDie Synapse-Dokumentation empfiehlt PostgreSQL für den Produktiveinsatz und stellt Optionen zur Steuerung des Datenbank-Verbindungspools bereit cp_max. PostgreSQL warnt jedoch davor, dass Einstellungen wie diese work_memvon mehreren Operationen innerhalb einer Abfrage und von mehreren Sitzungen gleichzeitig verwendet werden können. Diese Kombination führt dazu, dass eine Einstellung, die isoliert betrachtet harmlos erscheint, in Spitzenzeiten ressourcenintensiv werden kann. Die sicherste Lösung besteht darin, zunächst die Abhängigkeiten zu messen, anschließend unnötige Parallelität zu reduzieren und erst dann Speicher- und Wartungsverhalten gezielt anzupassen.
Schritt 1: Bestätigen Sie, dass PostgreSQL tatsächlich die Quelle des Speicherdrucks ist.
Beginnen Sie auf Betriebssystemebene. Vergleichen Sie unter Linux den gesamten Arbeitsspeicher, den verfügbaren Arbeitsspeicher, den Auslagerungsspeicher und die größten Prozesse:
free -h
ps aux --sort=-%mem | head -n 15
Beurteilen Sie den Server nicht anhand einer einzelnen Prozesszeile. PostgreSQL nutzt sowohl gemeinsam genutzten als auch privaten Speicher in Backend-Prozessen. Die entscheidende Frage ist daher, ob der Host tatsächlich unter Druck steht: zu wenig verfügbarer Speicher, wachsender Swap-Speicher, OOM-Kills oder anhaltende Latenz. Erfassen Sie die Werte während einer ruhigen Phase und erneut während einer Hochlastphase. Diese Basiswerte ermöglichen es, spätere Änderungen messbar statt auf Vermutungen zu basieren.
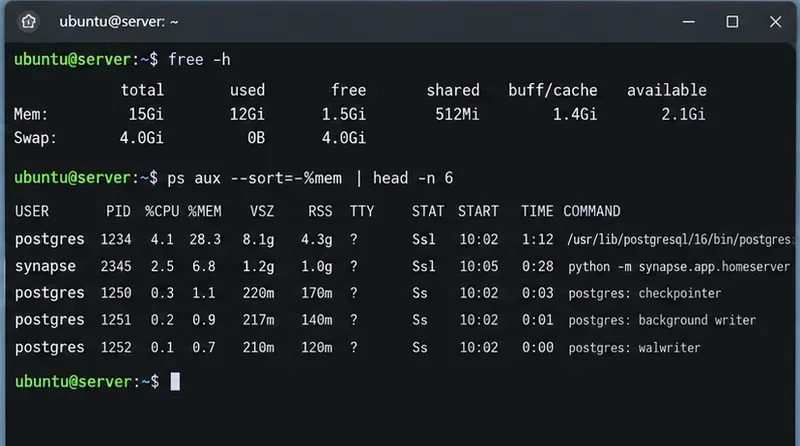
Bildunterschrift: Bei einer ersten Speicherprüfung wird der auf dem Host verfügbare RAM mit dem der PostgreSQL- und Synapse-Prozesse verglichen, bevor eine Konfigurationsänderung vorgenommen wird.
Überprüfen Sie als Nächstes die PostgreSQL-Einstellungen, die am ehesten den Speicherverbrauch beeinflussen:
SHOW shared_buffers;
SHOW work_mem;
SHOW maintenance_work_mem;
SHOW autovacuum_work_mem;
SHOW max_connections;
Die Dokumentation zum Ressourcenverbrauch von PostgreSQL beschreibt den wesentlichen Unterschied. shared_buffersist ein serverweiter, gemeinsam genutzter Cache. hingegen work_memist ein Limit für einzelne Sortier- oder Hash-Operationen, bevor diese in temporäre Dateien ausgelagert werden. Eine komplexe Abfrage kann mehrere solcher Operationen umfassen, und viele Sitzungen können diese gleichzeitig ausführen. PostgreSQL dokumentiert derzeit 4 MB als Standardwert work_memund weist darauf hin, dass der Gesamtverbrauch ein Vielfaches dieses Wertes betragen kann.
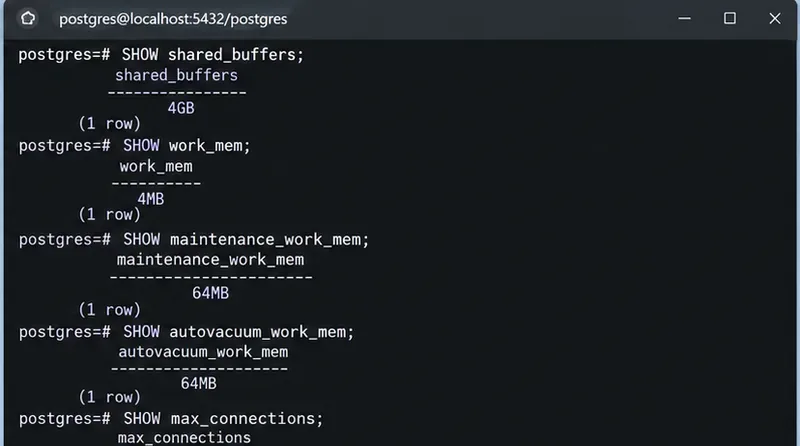
Bildunterschrift: Lesen Sie die aktiven PostgreSQL-Speichereinstellungen, bevor Sie sie ändern; der gefährliche Wert ist oft die Kombination aus Einstellungen und Parallelität und nicht eine einzelne Zahl.
Schritt 2: Synapse-Datenbankverbindungen zählen und aktive Arbeit finden
Ein großer Verbindungspool belegt nicht automatisch work_memfür jede Verbindung Speicher, aber jedes PostgreSQL-Backend verfügt über einen eigenen Prozess und eigenen Speicher. Mehr gleichzeitige Abfragen führen zu mehr Möglichkeiten für Speicherzuweisungen pro Operation. Prüfen Sie, wie viele Verbindungen tatsächlich geöffnet sind und in welchem Zustand sie sich befinden.
SELECT state,
       usename,
       application_name,
       count(*) AS connections
FROM pg_stat_activity
GROUP BY state, usename, application_name
ORDER BY connections DESC;
Anschließend werden langlaufende aktive Abfragen untersucht:
SELECT pid,
       usename,
       state,
       now() - query_start AS running_for,
       wait_event_type,
       wait_event,
       left(query, 180) AS query
FROM pg_stat_activity
WHERE state <> 'idle'
ORDER BY query_start;
Die offizielle pg_stat_activityDokumentation erläutert die Felder „Sitzung“ und „Aktivität“. Eine hohe Anzahl inaktiver Sitzungen unterscheidet sich von wenigen speicherintensiven aktiven Abfragen; daher sollte auch die Lösung unterschiedlich sein. Liegt das Problem an der Anzahl der Verbindungen, ist die Größe des Adresspools zu berücksichtigen. Sind es hingegen wenige speicherintensive Abfragen, kann eine Verkleinerung des Pools das Problem lediglich kaschieren.
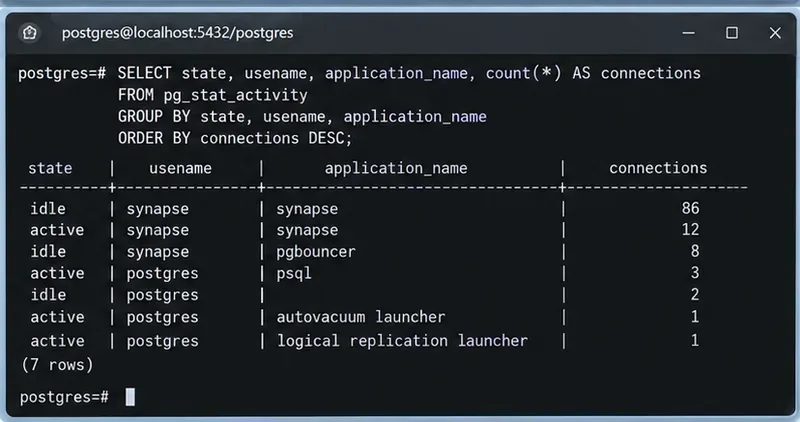
Bildunterschrift: Durch die Gruppierung pg_stat_activitylassen sich viele inaktive Backends leichter von einer kleineren Anzahl aktiver Datenbanksitzungen unterscheiden.
Schritt 3: Den Synapse-PostgreSQL-Verbindungspool optimal dimensionieren
Synapse übergibt die meisten Datenbankargumente an PostgreSQL und verwendet dabei Optionen, die mit `--database` beginnen, cp_für seinen Twisted-Verbindungspool. Die aktuelle Synapse-PostgreSQL-Anleitung zeigt ein Beispiel mit ` --database` cp_min: 5und ` cp_max: 10--database`. Diese Werte sind beispielhaft und nicht als universelles Ziel zu verstehen.
Überprüfen Sie den databaseBlock in homeserver.yaml:
database:
  name: psycopg2
  args:
    user: synapse_user
    password: "your-secret"
    dbname: synapse
    host: 127.0.0.1
    cp_min: 5
    cp_max: 10
Wenn Sie die Anzahl der Verbindungen zuvor cp_maxstark erhöht haben und pg_stat_activitynun viele, größtenteils inaktive Synapse-Verbindungen vorhanden sind, reduzieren Sie diese schrittweise und beobachten Sie die Latenzzeiten der Anfragen. Bei einer Worker-basierten Synapse-Bereitstellung ist zu beachten, dass die Datenbankanforderungen von mehreren Synapse-Prozessen stammen. Bewerten Sie daher die Gesamtzahl der Verbindungen und nicht die eines einzelnen Workers. Das Synapse-Konfigurationshandbuch bestätigt, dass cp_die Optionen den Verbindungspool konfigurieren.
Starten Sie nach der Konfigurationsbearbeitung den/die betroffenen Synapse-Prozess(e) entsprechend Ihrer Bereitstellungsmethode neu und führen Sie anschließend die Abfrage der Verbindungsanzahl erneut aus. Verkleinern Sie den Verbindungspool nicht, bis Anfragen in der Warteschlange stehen, nur um einige Megabyte einzusparen. Ein zu kleiner Pool kann die Datenbankkonkurrenz in Anwendungslatenz umwandeln.
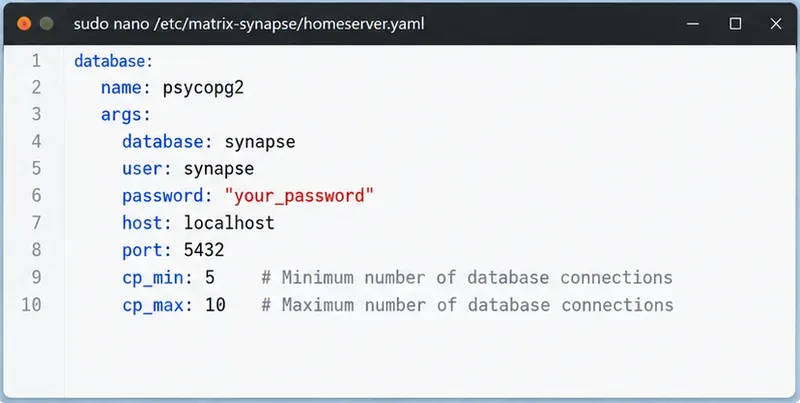
Bildunterschrift: Synapse legt cp_mindie cp_maxKonfiguration der PostgreSQL-Datenbank offen, sodass Administratoren unnötige Backend-Parallelität begrenzen können.
Schritt 4: PostgreSQL-Speicher konservativ optimieren
Sobald die Anzahl der Verbindungen angemessen ist, überprüfen Sie die PostgreSQL-Speichereinstellungen im Hinblick auf den tatsächlich verfügbaren Arbeitsspeicher (RAM). PostgreSQL empfiehlt auf einem dedizierten Datenbankserver mit mindestens 1 GB RAM etwa 25 % des Systemspeichers als Ausgangspunkt shared_buffers. Diese Empfehlung gilt ausdrücklich für einen dedizierten Datenbankserver. Wenn Synapse, Reverse-Proxy, Redis, Monitoring und PostgreSQL auf einer kleinen virtuellen Maschine laufen, belegt PostgreSQL nicht die gesamte Maschine. Planen Sie die Speichernutzung daher entsprechend ein.
Die Einstellung, die Administratoren am ehesten überraschen dürfte, ist work_memdie Multiplikation mit . Vermeiden Sie work_memes max_connections, dies als feste Reservierung zu betrachten; PostgreSQL reserviert Speicher nicht auf diese Weise vor. Denken Sie stattdessen an parallele Abfrageoperationen. Eine einzelne Abfrage kann mehrere Sortier- oder Hash-Knoten verwenden, und Hash-Operationen können ein Vielfaches von belegen work_mem. Wenn Sie work_memglobal auf einen sehr hohen Wert setzen, weil ein Bericht langsam war, kann ein Federation-Burst oder eine Phase mit hohem Synchronisierungsaufkommen einen viel höheren Speicherverbrauch als erwartet verursachen.
Es empfiehlt sich, den globalen Wert konservativ zu halten und ihn nur für eine bestimmte administrative Sitzung zu erhöhen, wenn eine bekannte Abfrage von mehr Speicher profitiert. Bevor Sie Werte ändern, sichern Sie Ihre bestehende Konfiguration und notieren Sie sich, welche Parameter einen PostgreSQL-Neustart erfordern. shared_buffersBeispielsweise ist dies eine Serverstart-Einstellung. Änderungen sollten so geplant werden, dass Sie Speichernutzung, Latenz und das Verhalten temporärer Dateien vor und nach der Änderung vergleichen können.
Prüfen Sie außerdem die Einstellungen für `autovacuum` maintenance_work_memund autovacuum_work_mem`autovacuum.org`. PostgreSQL weist darauf hin, dass Autovacuum-Worker gleichzeitig Wartungsspeicher belegen können. Wenn ` autovacuum_work_memautovacuum` das gewohnte Verhalten beibehält, maintenance_work_memkann eine ungewöhnlich große Anzahl von `autovacuum.org`-Werten dazu führen, dass mehrere Autovacuum-Worker gleichzeitig ressourcenintensiv arbeiten. Deaktivieren Sie Autovacuum nicht, um RAM zu sparen; dies führt in der Regel kurzfristig zu einer geringeren Speicherauslastung, aber langfristig zu einer aufgeblähten Tabelle, veralteten Statistiken und einer schlechteren Performance.
Schritt 5: Überprüfen Sie den Zustand des Staubsaugers und verifizieren Sie die Reparatur anschließend unter realer Last.
Synapse schreibt und aktualisiert große Mengen an Ereignis- und Statusdaten. PostgreSQL benötigt regelmäßiges VACUUMING, um nicht mehr benötigte Datensätze wiederzuverwenden und die Planerstatistiken aktuell zu halten. Die PostgreSQL-Anleitung zum regelmäßigen VACUUMING empfiehlt für die meisten Installationen die automatische Bereinigung (Autovacuum).
Suchen Sie nach Tabellen mit vielen geschätzten toten Datensätzen oder veralteten Wartungszeitstempeln:
SELECT relname,
       n_live_tup,
       n_dead_tup,
       last_autovacuum,
       last_autoanalyze
FROM pg_stat_user_tables
ORDER BY n_dead_tup DESC
LIMIT 20;
Wenn eine bestimmte Tabelle eindeutig Aufmerksamkeit erfordert, VACUUM (ANALYZE)ist eine Normalisierung in der Regel das erste manuelle Hilfsmittel, das in Betracht gezogen werden sollte:
VACUUM (ANALYZE) your_table_name;
Vermeiden Sie es, direkt zu VACUUM zu springen VACUUM FULL. Die offizielle VACUUM-Referenz erklärt, dass reguläres VACUUM VACUUMparallel zu normalen Lese- und Schreibvorgängen ausgeführt werden kann, während VACUUM FULLVACUUM die Tabelle überschreibt und eine ACCESS EXCLUSIVESperre setzt. Verwenden Sie VACUUM nur, wenn die Freigabe von Speicherplatz den geplanten Aufwand wert ist.
Woran man erkennt, ob die Änderung tatsächlich funktioniert hat
Überprüfen Sie das Ergebnis unter derselben Arbeitslast, die das Problem verursacht hat. Eine erfolgreiche Behebung bedeutet nicht einfach nur, dass Postgres sofort weniger RAM benötigt. Datenbank-Caches benötigen Speicher. Achten Sie stattdessen auf stabilen verfügbaren Speicher, geringes oder kein unerwartetes Wachstum des Swap-Speichers, keine OOM-Ereignisse, eine der erwarteten Parallelität entsprechende Verbindungsanzahl und akzeptable Synapse-Antwortzeiten.
- Führen Sie
free -hdie Prozessliste bei dem gleichen Verkehrsaufkommen aus, das Sie für Ihre Basislinie verwendet haben.
- Wiederholen Sie die
pg_stat_activityVerbindungsabfrage und vergewissern Sie sich, dass die Anzahl der inaktiven Backends gesunken ist, wenn Sie den Synapse-Pool geändert haben.
- Beobachten Sie die Abfrage- und Synchronisierungslatenz nach der Reduzierung
cp_max; machen Sie die Änderung rückgängig, wenn die Wartezeiten der Datenbank merklich ansteigen.
- Überprüfen Sie
pg_stat_user_tablesregelmäßig, ob der Staubsauger auch tatsächlich die stark frequentierten Tische anfährt.
- Wenn Sie den Wert gesenkt haben
work_mem, beobachten Sie, ob große Sortierungen nun übermäßig in temporäre Dateien ausgelagert werden, bevor Sie ihn weiter senken.
Wenn PostgreSQL nach diesen Prüfungen weiterhin so stark wächst, dass der Host häufig auslagert, erfassen Sie die Liste der aktiven Abfragen während der Lastspitze und untersuchen Sie die Arbeitslast, anstatt die globalen Speichergrenzen wiederholt zu verringern. Bei unterstützten PostgreSQL-Versionen pg_backend_memory_contextskönnen Sie die Speicherkontexte des aktuellen Backends überprüfen; die Dokumentation zur PostgreSQL-Systemansicht beschreibt die Ansicht und ihre Berechtigungen. Dies ist für eine gezielte Datenbankuntersuchung hilfreicher, als anzunehmen, dass jede speicherintensive Synapse-Bereitstellung dieselbe Ursache hat.
Fazit
Bei Matrix Synapse auf PostgreSQL lässt sich eine hohe Datenbank-Speicherauslastung am sichersten schrittweise beheben: Zunächst muss nachgewiesen werden, dass der Host tatsächlich unter Speicherdruck steht. Anschließend werden die Datenbanksitzungen gezählt, der Speicherpool von Synapse optimal dimensioniert, der Speicherverbrauch pro Operation in PostgreSQL konservativ gehalten und die korrekte Funktion des automatischen Speichermanagements sichergestellt werden. Ziel ist nicht die minimale Speicherauslastung von PostgreSQL, sondern eine vorhersehbare Speichernutzung, ohne dass normales Datenbank-Caching und Parallelverarbeitung zu unnötigem Swapping, Speichermangel oder langsamen Matrix-Clients führen.









