Startseite
» NETZWERK-ADMIN
»
Bewährte Methoden für die Netzwerküberwachung: Was sollte überwacht werden und welche Tools eignen sich?
Bewährte Methoden für die Netzwerküberwachung: Was sollte überwacht werden und welche Tools eignen sich?
Effektives Netzwerkmonitoring beginnt mit einem geprüften Inventar, serviceorientierten Kennzahlen und aussagekräftigen Warnmeldungen. Erfassen Sie kritische Geräte und Dienste, ermitteln Sie den Normalbetrieb und wählen Sie anschließend eine Plattform, die Ihre Infrastruktur unterstützt und von Ihrem Team gewartet werden kann. So lassen sich sich anbahnende Probleme frühzeitig erkennen, ohne dass jede noch so kleine Schwankung sofort Anlass zu einer Meldung gibt.
Was Ihnen die Netzwerküberwachung mitteilen sollte
Netzwerküberwachung verfolgt die Erreichbarkeit und Leistung von Geräten und Diensten. Sie umfasst üblicherweise Geräte- und Schnittstellenstatus, Datenverkehr, Serverressourcen und Serviceprüfungen. Sicherheitsprotokollierung hat eine andere Funktion: Ein Netzwerkmanagementsystem (NMS) erklärt Verfügbarkeit und Leistung, während zentralisierte Protokolle oder ein SIEM-System die Untersuchung von Ereignissen wie verdächtigen Anmeldungen und Konfigurationsänderungen unterstützen. Viele Teams nutzen beides. Das NIST definiert kontinuierliche Überwachung als ständige Risikobewertung für fundierte Entscheidungen; die Netzwerkabdeckung sollte bei Änderungen der Umgebung überprüft werden.
Best Practices für die Netzwerküberwachung
1. Erstellen Sie ein Inventar, bevor Sie Benachrichtigungen einrichten.
Erstellen Sie eine Liste von Routern, Switches, Firewalls, WLAN-Geräten, kritischen Servern, Cloud-Verbindungen und kundenseitigen Diensten. Erfassen Sie für jedes Gerät Standort, Eigentümer, Priorität, Managementadresse und Abhängigkeiten. Nutzen Sie die automatische Erkennung, um das Inventar zu initialisieren, überprüfen Sie es anschließend und fügen Sie Geräte hinzu, die nicht automatisch gefunden werden. Gruppieren Sie die Geräte nach Standort oder Dienst. Aktualisieren Sie die Liste nach Änderungen, um eine vollständige Abdeckung zu gewährleisten.
Eine Beispiel-Topologieansicht verknüpft den Gerätestatus mit vorgelagerten und nachgelagerten Abhängigkeiten.
2. Signale überwachen, die die Auswirkungen auf die Nutzer erklären
Beginnen Sie mit einem kompakten Satz von Messgrößen, die mit kritischen Diensten verknüpft sind:
Verfügbarkeit: Geräte- und Schnittstellenstatus sowie Überprüfungen auf wichtige Dienste wie DNS, Webanwendungen, E-Mail oder VPN-Zugang.
Pfadqualität: Latenz, Paketverlust und Jitter, wo Echtzeit-Sprach- oder Videoübertragung davon abhängt.
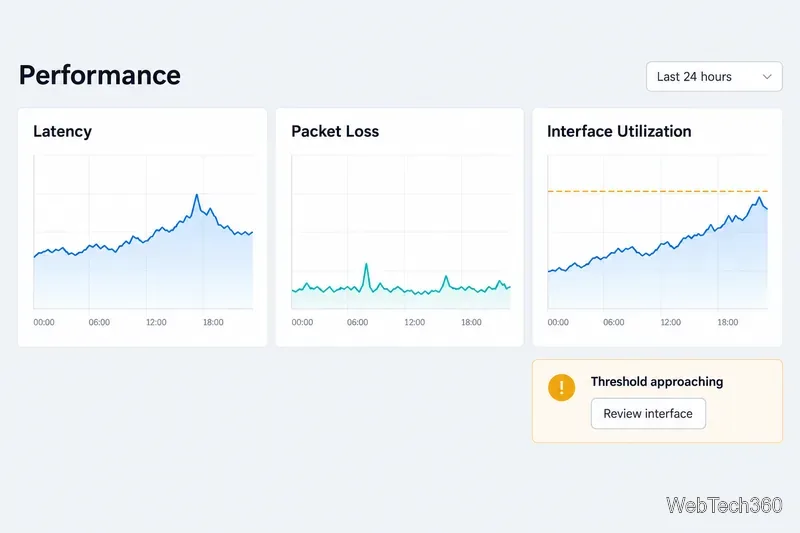
Datenverkehr und Kapazität: Schnittstellenauslastung, Durchsatz, Fehler und verworfene Pakete. Speichern Sie den Verlauf, um kurzfristige Spitzen von wiederkehrenden Kapazitätsproblemen zu unterscheiden.
Gerätezustand: CPU-, Speicher-, Temperatur-, Leistungs- oder Lüfterstatus, sofern das Gerät diese Messwerte anzeigt.
Unterstützende Systeme: Serverspeicher und Dienststabilität, wenn ein Anwendungsausfall außerhalb der Netzwerkschicht verursacht werden könnte.
Legen Sie standort- und servicebezogene Ausgangswerte fest, anstatt einen einheitlichen Schwellenwert zu verwenden. Vergleichen Sie das aktuelle Verhalten mit normalen Spitzenzeiten und achten Sie auf anhaltenden Druck oder plötzliche Veränderungen.
Ein Beispiel-Performance-Dashboard hilft dabei, normale Schwankungen von anhaltender Belastung einer Verbindung zu unterscheiden.
3. Benachrichtigungen umsetzbar gestalten und Duplikate reduzieren
Benachrichtigen Sie bei handlungsbedürftigen Zuständen: Ausfälle, fehlgeschlagene Serviceprüfungen oder anhaltende Schwellenwertüberschreitungen. Filtern Sie kurzzeitige Störungen mithilfe einer Verzögerungs- oder Wiederherstellungsregel heraus. Geben Sie das Gerät oder die Schnittstelle, den betroffenen Dienst oder Standort, den Zeitpunkt des ersten Auftretens, die beobachteten und erwarteten Werte sowie ein Runbook an. Leiten Sie Benachrichtigungen an einen Verantwortlichen weiter und definieren Sie die Eskalationsstufe.
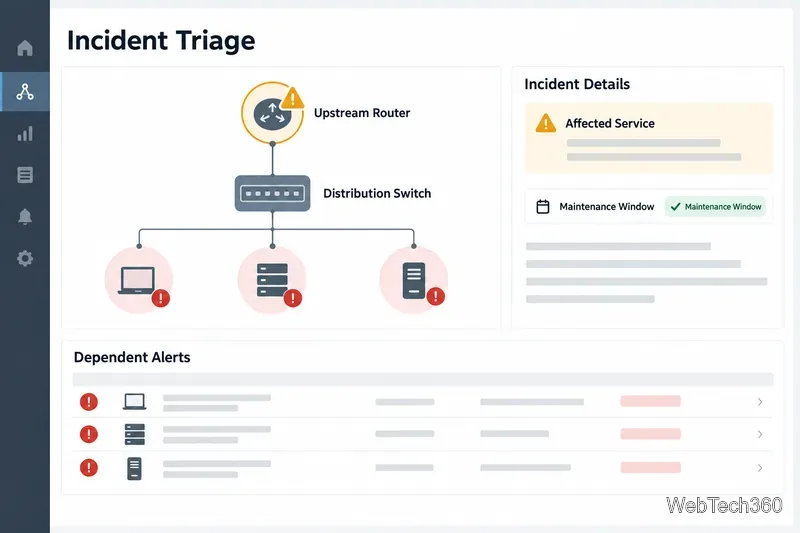
Gruppieren Sie nachgelagerte Warnmeldungen, wenn ein vorgelagerter Fehler diese erklärt; planen Sie Wartungsfenster für geplante Arbeiten ein. Dies hilft den Einsatzkräften, wahrscheinliche Ursachen schneller zu finden. Überprüfen Sie die Unterdrückungsregeln nach Topologieänderungen, damit unabhängige Fehler weiterhin sichtbar bleiben.
Eine Beispielansicht eines Vorfalls zeigt, wie abhängige Warnmeldungen die Einsatzkräfte auf die erste ausgefallene Verbindung hinweisen können.
4. Schützen Sie das Überwachungssystem
Überwachungszugangsdaten und Protokolle können sensible Infrastrukturinformationen offenlegen. Beschränken Sie den Management-Datenverkehr, verwenden Sie nach Möglichkeit schreibgeschützte Konten, gewähren Sie rollenbasierte Zugriffsrechte und sichern Sie den Überwachungsserver und die Backups. Bevorzugen Sie SNMPv3, sofern unterstützt, mit kompatiblen Authentifizierungs- und Datenschutzeinstellungen; das SNMPv3-Benutzersicherheitsmodell definiert diese Sicherheitsdienste. Befolgen Sie die CISA-Richtlinien zum Schutz von Protokollen und stellen Sie Management-Schnittstellen niemals direkt dem öffentlichen Internet zur Verfügung.
5. Testabdeckung, Warnmeldungen und Wiederherstellung
Stellen Sie sicher, dass die Sonden die Geräte von den relevanten Standorten aus erreichen, die Anmeldeinformationen funktionieren und der Verlauf für die Fehlerbehebung und Kapazitätsplanung gespeichert wird. Testen Sie Warnmeldungen mit den Empfängern; dokumentieren Sie Verantwortliche und Wartungspläne. Überprüfen Sie veraltete Geräte, Lücken und fehlerhafte Regeln nach Netzwerkänderungen. Halten Sie einen getesteten Wiederherstellungsplan für die Überwachungsplattform bereit.
Drei Netzwerküberwachungstools zur Bewertung
Diese Produkte decken gängige Anforderungen ab. Die Eignung hängt von Ihrer Umgebung, Ihrem Bereitstellungsmodell, den Lizenzbedingungen und den verfügbaren Fachkräften ab. Prüfen Sie die Tarife und die Geräteunterstützung bei den jeweiligen Anbietern.
Werkzeug
Wo es passen könnte
Überprüfen Sie dies während der Auswertung
SolarWinds Netzwerkleistungsmonitor
Multi-Vendor-Umgebungen, die Gerätemetriken, Karten, Warnmeldungen, Berichte oder Pfad-Fehlerbehebung benötigen. Der Anbieter listet Verfügbarkeit, Latenz, Paketverlust, Auslastung und Gerätezustand auf.
Prüfen Sie die Geräte- und Protokollunterstützung, die Bereitstellung, die Aufbewahrungsfristen und die benötigten Module. Siehe SolarWinds NPM .
Paessler PRTG Netzwerkmonitor
Teams überwachen Geräte, Datenverkehr, Server und Dienste mithilfe von Karten, Dashboards und Benachrichtigungen. PRTG stellt überwachte Werte als Sensoren dar.
Ermitteln Sie den Bedarf an Sensoren und Sonden für Ihren Abdeckungsplan. Siehe Paessler PRTG .
ManageEngine OpManager
Organisationen, die eine umfassende Erkennung und Leistungsüberwachung ihrer Netzwerkgeräte und Server anstreben. Die Dokumentation beschreibt die Unterstützung für SNMP, CLI und WMI.
Prüfen Sie Protokollzugriff, Vorlagen, Rollensteuerung, Add-ons und die Verwaltung von Remote-Standorten. Siehe OpManager .
Wählen Sie mit einem kleinen Piloten
Führen Sie eine Pilotstudie an einem repräsentativen Standort, einem kritischen Dienst und mit verschiedenen Geräten durch. Testen Sie Erkennung, Genauigkeit der Messwerte, Benachrichtigungen, Wartungsmanagement, Berichte, Berechtigungen und Wiederherstellung. Fragen Sie die Dashboard-Nutzer, welche Informationen fehlen. Eine kurze Pilotstudie zeigt, ob die Plattform besser zu Ihrem Netzwerk passt als eine Funktionsliste.