Startseite
» NETZWERK-ADMIN
»
So beheben Sie das Problem, dass Matrix Synapse während der Synchronisierung nicht genügend Speicher zur Verfügung steht.
So beheben Sie das Problem, dass Matrix Synapse während der Synchronisierung nicht genügend Speicher zur Verfügung steht.
Die aktuellste stabile Matrix Synapse-Version ist seit dem 6. Oktober 2026 Version 1.162.0 (veröffentlicht am 29. September 2026). Falls Ihrem Homeserver während der Client-Synchronisierung der Speicherplatz ausgeht, empfiehlt sich zunächst ein Upgrade auf eine aktuelle, unterstützte Version. Die dauerhafte Lösung liegt jedoch meist eher in der Bedienung als in einer einzelnen Einstellung. Synapse speichert Raumdaten und Metadaten absichtlich im Arbeitsspeicher, um häufige Anfragen zu beschleunigen. Die offizielle Administratordokumentation warnt davor, dass eine zu starke Reduzierung des Caches die Speicherauslastung durch einen Rückstau langsamer Anfragen sogar noch verschlimmern kann.
Dieser Leitfaden beschreibt den sicheren Weg für neue Administratoren: Verstehen, was „Synchronisierung“ bedeutet, bestätigen, dass der Prozess tatsächlich an eine Speichergrenze stößt, unnötigen Cache-Druck reduzieren, bei Bedarf besonders hohen anfänglichen Synchronisierungsverkehr abkoppeln und das Ergebnis überwachen. Ziel ist nicht nur die Verkleinerung des residenten Speichers, sondern die Vermeidung von Speichermangel-Abstürzen bei gleichzeitiger Aufrechterhaltung der Reaktionsfähigkeit des Homeservers.
Was „Sync“ in Matrix Synapse bedeutet
Ein Matrix-Client ruft die Client-Server-API wiederholt auf, /_matrix/client/v3/syncum neue Ereignisse wie Nachrichten, Raumstatus, Kontodaten, Anwesenheitsinformationen und Geräteaktualisierungen zu empfangen. Eine normale, fortlaufende Synchronisierung beinhaltet üblicherweise ein sinceToken, sodass Synapse nur die Änderungen nach dem vorherigen Synchronisierungspunkt zurückgeben muss.
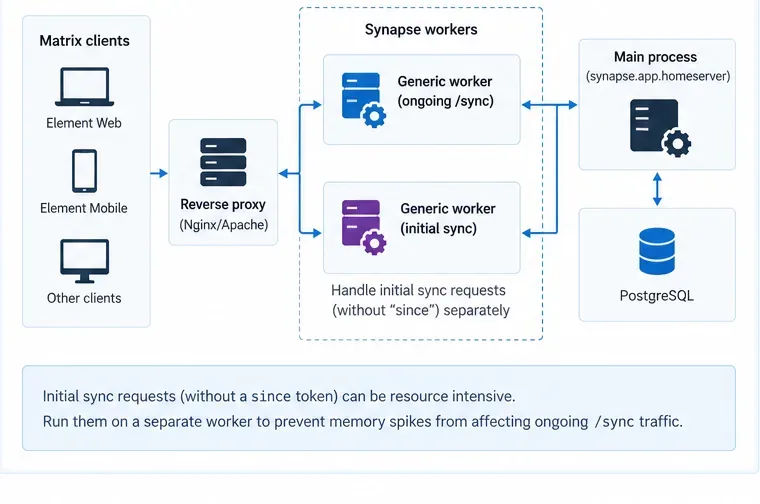
Eine initiale Synchronisierung funktioniert anders. Es handelt sich um die erste Synchronisierung eines Geräts oder einer Sitzung, für die kein vorheriges sinceToken vorhanden ist. Die offizielle Synapse-Worker-Dokumentation beschreibt diese Anfragen als potenziell sehr ressourcenintensiv. Auf größeren Heimservern unterstützt Synapse das separate Routing der initialen Synchronisierung von der laufenden Synchronisierung, sodass einige wenige aufwändige Erstsynchronisierungen die anderen nicht beeinträchtigen.
Notieren Sie Ihre Synapse-Version und die Installationsmethode.
Sichern Sie homeserver.yamldie Worker-Konfigurationsdateien, die Reverse-Proxy-Konfiguration und die PostgreSQL-Datenbank gemäß Ihrem normalen Sicherungsverfahren.
Beachten Sie, ob Synapse als ein einzelner Prozess, in Containern oder als Hauptprozess plus Worker-Prozesse ausgeführt wird.
Ermitteln Sie das tatsächliche Speicherlimit. Ein Container, eine systemd-Unit, ein Kubernetes-Pod oder eine VM kann ein niedrigeres Limit haben als der physische Server.
Vergewissern Sie sich, dass PostgreSQL für den Produktivbetrieb verwendet wird. Die aktuelle Synapse-Installationsdokumentation gibt an, dass SQLite nur für Testzwecke geeignet ist und sich für Produktionsumgebungen, insbesondere in großen Räumen, als ungeeignet erweist.
Schritt 1: Bestätigen Sie, dass Speichererschöpfung tatsächlich der Fehler ist.
Ändern Sie zunächst nicht die Cache-Werte. Ermitteln Sie zuerst, welcher Synapse-Prozess Speicher belegt und ob er vom Betriebssystem oder durch eine Containerbegrenzung beendet wird.
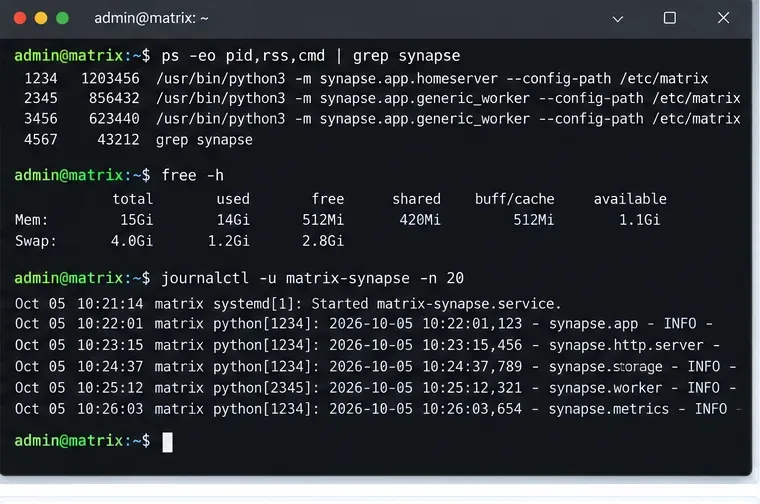
Beginnen Sie mit der Prozess-RSS, dem verfügbaren Speicher, dem Swap-Druck und den aktuellen Synapse-Dienstprotokollen, um festzustellen, ob es sich um eine echte Speichererschöpfung oder einen anderen Synchronisierungsfehler handelt.
Auf einem Linux-Host liefern Befehle wie die folgenden einen schnellen ersten Überblick:
Wenn Sie Docker, Podman, Kubernetes oder einen anderen Scheduler verwenden, überprüfen Sie auch das Speicherlimit des Containers oder Pods. Selbst ein Host mit mehreren Gigabyte freiem Speicher kann Synapse beenden, wenn der Prozess durch ein deutlich niedrigeres Cgroup-Limit eingeschränkt ist.
Achten Sie auf wiederkehrende Muster. Steigt der Speicherverbrauch nur an, wenn sich ein bestimmter Benutzer auf einem neuen Gerät anmeldet? Nimmt er den ganzen Tag über allmählich zu? Vermehrt sich ein generischer Worker, während der Hauptprozess stabil bleibt? Diese Beobachtungen unterscheiden einen Anstieg beim anfänglichen Synchronisieren von einem allgemeinen Cache-Wachstum oder einem Anfragerückstand.
Schritt 2: Überprüfen Sie die Cache-Einstellungen, bevor Sie sie verringern.
Ein Cache sind Daten, die Synapse im Arbeitsspeicher (RAM) speichert, um wiederholtes Neuberechnen oder Laden derselben Informationen zu vermeiden. Synapse verfügt über mehrere Caches sowie einen Ereignis-Cache. Die Konfigurationsreferenz dokumentiert derzeit einen Standardwert caches.global_factorvon 0,5, einen event_cache_sizeStandardwert von 10.000 vor Anwendung des globalen Faktors, eine zeitbasierte Cache-Ablaufzeit und eine sync_response_cache_durationStandard-Cache-Gültigkeitsdauer von 2 Minuten.
Die naheliegende Lösung ist, den globalen Faktor so niedrig wie möglich einzustellen. Davon ist jedoch abzuraten. Die FAQ für Synapse-Administratoren warnt ausdrücklich davor, dass ein zu kleiner Cache ein ohnehin schon langsames System noch weiter verlangsamen kann. Dadurch können sich Anfragen stauen und der Speicherverbrauch explodiert aufgrund des Anfragerückstands anstatt durch die Cache-Einträge.
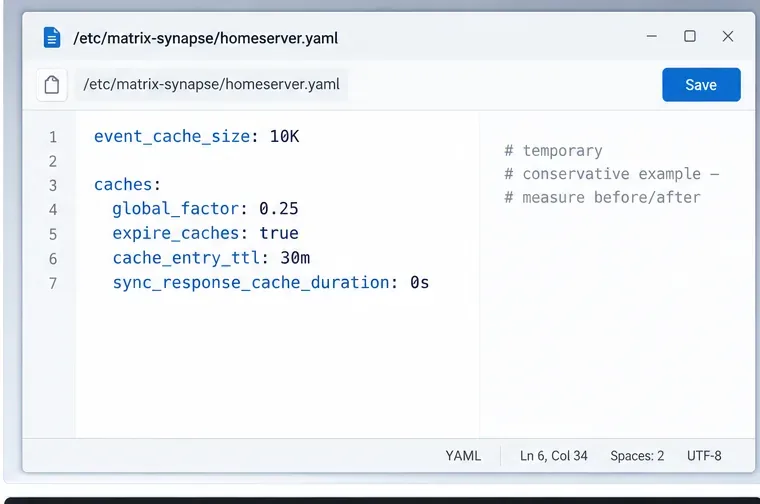
Nehmen Sie Cache-Änderungen vorsichtig vor und messen Sie das Ergebnis; das Beispiel veranschaulicht, wo die relevanten Einstellungen zu finden sind, und stellt keinen allgemeingültigen Produktionswert dar.
Wenn die Profilerstellung zeigt, dass der Cache-Speicher tatsächlich der Hauptverbraucher ist und der Anfragedurchsatz weiterhin gut ist, versuchen Sie eine moderate Reduzierung anstatt einer drastischen. Zum Beispiel:
Dies ist ein Beispiel zur Fehlerbehebung und kein empfohlener Wert für jeden Server. Die Einstellung sync_response_cache_durationauf Null deaktiviert das Zwischenspeichern abgeschlossener /syncAntworten. Dadurch kann Speicherplatz gespart werden, wenn viele Synchronisierungsantworten gespeichert werden, allerdings kann dies den Aufwand für neu verbundene Clients erhöhen. Testen Sie dies unter Ihrer tatsächlichen Arbeitslast.
Synapse bietet außerdem Cache-Autotuning mit den Optionen `--cache-autotuning` max_cache_memory_usage, target_cache_memory_usage`--cache-autotuning` und ` --cache-autotuning` min_cache_ttl. Laut offizieller Dokumentation benötigt diese Funktion jemalloc , einen alternativen Speicherallokator, und alle drei Einstellungen müssen angegeben werden. Aktivieren Sie nicht nur einen oder zwei Werte; die Dokumentation warnt davor, dass eine unvollständige Konfiguration zu instabilem Verhalten führen kann.
Schritt 3: Stellen Sie sicher, dass die Datenbank keinen Anfragerückstand erzeugt.
Speicherprobleme während der Synchronisierung werden nicht immer durch die Menge der zwischengespeicherten Daten verursacht. Eine langsame Datenbank kann viele Anfragen gleichzeitig bearbeiten, und jede laufende Anfrage belegt Speicher. Daher kann eine Reduzierung der Cache-Größe bei einem ohnehin schon langsamen Speichersystem kontraproduktiv sein.
Für den Produktivbetrieb folgen Sie der offiziellen Synapse-PostgreSQL-Anleitung . Prüfen Sie die CPU-Auslastung der Datenbank, die Speicherlatenz, die Verbindungsauslastung, langlaufende Abfragen und ob der PostgreSQL-Server selbst Auslagerungsvorgänge durchführt. Steigt die Synchronisierungslatenz gleichzeitig mit dem belegten Arbeitsspeicher, untersuchen Sie den Backlog, bevor Sie die Caches erneut reduzieren.
Wenn Sie kürzlich auf große öffentliche Räume umgestiegen sind, sich größeren Gemeinschaften angeschlossen oder viele aktive Benutzer hinzugefügt haben, ist die Arbeitslast möglicherweise einfach über eine zuvor funktionierende Konfiguration hinausgewachsen. In diesem Fall sind Datenbankoptimierung und Worker-Isolation oft wichtiger als die geringfügige Reduzierung der Cache-Speicherung.
Schritt 4: Isolieren Sie die initiale Synchronisierung auf größeren Homeservern
Synapse kann als monolithischer Prozess mit einem zentralen Homeserver-Prozess laufen oder die Arbeit in Worker aufteilen . Worker sind zusätzliche Synapse-Prozesse, die dieselbe PostgreSQL-Datenbank nutzen. Das Worker-Modell ist für größere Installationen gedacht, die einzelne Workloads unabhängig skalieren müssen.
Bei größeren, auf PostgreSQL basierenden Bereitstellungen sollte die aufwändige initiale Synchronisierung getrennt von der laufenden Synchronisierung durchgeführt werden, damit beim ersten Login nicht der gleiche Worker-Pool wie bei normalen Client-Aktualisierungen beansprucht wird.
Die Dokumentation des Workers besagt, dass ein generischer Worker sowohl `sync` /syncals auch `sync` verarbeiten kann /initialSync. Sie empfiehlt außerdem, eine separate Behandlung für Synchronisierungsanfragen ohne sinceParameter in Betracht zu ziehen, da diese initialen Synchronisierungsanfragen sehr ressourcenintensiv sein können.
Eine praktische Architektur ist:
Der Reverse-Proxy empfängt den Datenverkehr der Matrix-Clients.
Laufende /syncAnfragen werden an einen oder mehrere generische Bearbeiter weitergeleitet.
Die ersten Synchronisierungsanfragen gehen an eine separate generische Workergruppe.
Der Hauptprozess umfasst weiterhin die Bearbeitung der nicht delegierten Aufgaben.
Alle Synapse-Prozesse nutzen PostgreSQL gemeinsam.
Der Synapse-Replikationslistener darf nicht öffentlich im Internet übertragen werden. Die aktuelle Worker-Dokumentation weist darauf hin, dass der Replikationsverkehr unverschlüsselt und unauthentifiziert ist, sofern kein Replikationsgeheimnis konfiguriert ist.
Für einen kleinen Heimserver sind Worker nicht der richtige erste Schritt. Synapse empfiehlt für kleinere Instanzen den Monolith-Modus. Fügen Sie Worker erst dann hinzu, wenn Sie wissen, dass eine bestimmte Arbeitslast Isolation oder horizontale Skalierung erfordert.
Schritt 5: Cache-Faktoren sicher neu laden und das Ergebnis beobachten
Synapse ermöglicht das Neuladen von Cache-Faktoren SIGHUP. Die Konfigurationsreferenz enthält folgendes Beispiel:
kill -HUP PID_OF_SYNAPSE_PROCESS
Wenn der mitgelieferte systemd-Dienst dies unterstützt, systemctl reload matrix-synapsekann dieselbe Operation ausgeführt werden. In einer Worker-Umgebung muss laut offizieller Dokumentation die entsprechende Worker-Konfiguration aktualisiert werden und jeder Worker muss das Reload-Signal einzeln erhalten.
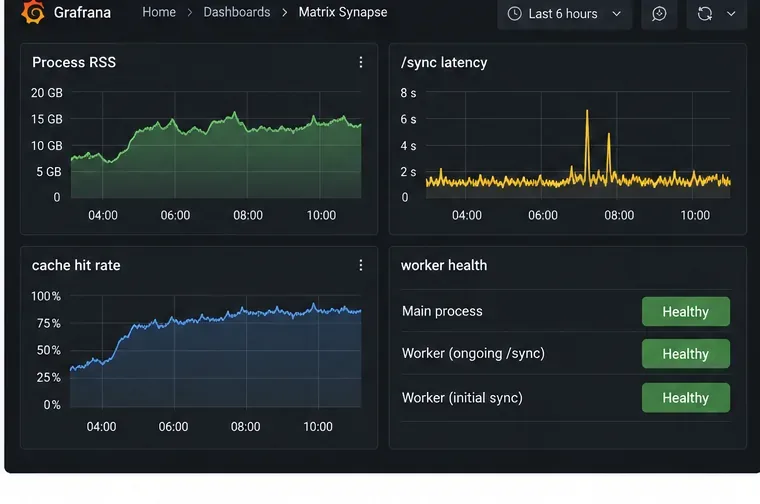
Nach jeder Änderung sollte dem Server ausreichend Zeit gegeben werden, sich wieder auf ein normales Auslastungsmuster einzustellen. Überwachen Sie dabei gleichzeitig den Arbeitsspeicherverbrauch, die Anfragelatenz, die Datenbanklast und die Stabilität der aktiven Worker. Ein sinkender Arbeitsspeicherverbrauch bei gleichzeitig verdoppelter Synchronisierungslatenz deutet nicht auf eine erfolgreiche Fehlerbehebung hin.
Schritt 6: Prometheus-Metriken für wiederholbare Diagnose aktivieren
Bei mehr als einem einmaligen Vorfall sollten Sie Synapse-Metriken aktivieren und diese mit Prometheus erfassen. Die offizielle Überwachungsanleitung beschreibt dies enable_metrics: trueund einen dedizierten internen Metrik-Listener. Platzieren Sie den Metrik-Endpunkt auf einer internen Schnittstelle oder schützen Sie ihn am Reverse-Proxy; er sollte nicht unnötig offengelegt werden.
Speicher- und Synchronisierungslatenz sollten gemeinsam überwacht werden. Das gewünschte Ergebnis ist ein stabiler Speicher mit akzeptabler Reaktionszeit, nicht der kleinstmögliche RSS-Wert.
Verwenden Sie die offizielle Synapse Prometheus-Überwachungsanleitung für die aktuelle Listener-Syntax. Bei Worker-Bereitstellungen muss jeder Worker separat überwacht werden, da Worker-Metriken nicht automatisch in den Hauptprozess aggregiert werden.
Häufige Fehler, die es zu vermeiden gilt
Senken Sie den SYNAPSE_CACHE_FACTOR, bis der Server langsamer wird.
Ein kleinerer Cache benötigt zwar weniger Speicher pro Eintrag, erhöht aber den Datenbank- und Rechenaufwand. Wenn dadurch eine Warteschlange unfertiger Anfragen entsteht, kann der gesamte Speicherbedarf steigen statt sinken. Reduzieren Sie den Faktor daher schrittweise und achten Sie stets auf die Latenz.
Angenommen, jede /sync-Anfrage kostet gleich viel
Eine fortlaufende Synchronisierung mit sinceToken und eine initiale Synchronisierung ohne Token weisen sehr unterschiedliche Ressourcenprofile auf. Trennen Sie diese in Ihrer Diagnose, bevor Sie den gesamten Server skalieren.
Verwendung von Workern, während man noch SQLite verwendet
Synapse-Worker nutzen eine gemeinsame PostgreSQL-Datenbank. Laut Worker-Dokumentation dient SQLite lediglich Demonstrations- oder Testzwecken und ist nicht die Grundlage für einen produktiven Einsatz mit Workern.
Swap als primäre Lösung verwenden
Ein geringer Swap-Speicher kann einen abrupten Prozessabbruch verhindern, doch starker Swap-Speicher verlangsamt die Synchronisierung erheblich und kann denselben Rückkopplungseffekt im Backlog erzeugen. Swap sollte als Schutz vor kurzfristigen Lastspitzen und nicht zur Kapazitätsplanung eingesetzt werden.
Wenn Sie gleichzeitig Caches verkleinern, Worker-Routing ändern, PostgreSQL-Einstellungen anpassen und ein Containerlimit erhöhen, können Sie nicht feststellen, welche Änderung das Problem behoben hat. Nehmen Sie daher jeweils nur eine kontrollierte Änderung vor und vergleichen Sie die entsprechenden Metriken.
Ein praktischer Entscheidungsweg
Was Sie beobachten
Wahrscheinliche nächste Aktion
Speicherspitzen treten auf, wenn sich Benutzer auf neuen Geräten anmelden.
Identifizieren Sie die initiale Synchronisierung und erwägen Sie, diese bei größeren Bereitstellungen auf einem Worker zu isolieren.
Der Speicherverbrauch steigt stetig an, während die Cache-Trefferrate hoch und die Latenz normal ist.
Reduzieren Sie die Cache-Kapazität vorsichtig und testen Sie erneut.
Speicher- und Synchronisierungslatenz steigen gemeinsam
Bevor Sie die Caches weiter verkleinern, sollten Sie den Datenbank- oder Speicherrückstand untersuchen.
Nur ein Arbeiter erreicht seine Leistungsgrenze
Passen Sie das Speicherbudget des jeweiligen Workers an oder skalieren Sie die Workergruppe anstatt des gesamten Homeservers.
Der Host verfügt über freien Arbeitsspeicher, aber Synapse wurde beendet.
Überprüfen Sie die Speichergrenzen von Containern, Cgroups, Systemd oder Kubernetes.
Abschließende Checkliste
Verwenden Sie eine aktuell unterstützte Synapse-Version; Version 1.162.0 ist die neueste stabile Version (Stand: 6. Oktober 2026).
Für den Produktiveinsatz verwenden Sie PostgreSQL.
Prüfen Sie, welcher Prozess tatsächlich RSS verbraucht und welches Speicherlimit dafür gilt.
Unterscheiden Sie zwischen normaler inkrementeller Synchronisierung und initialer Synchronisierung.
Lassen Sie die Cache-Ablaufzeit aktiviert und optimieren Sie die Cache-Faktoren schrittweise.
Aktivieren Sie die automatische Cache-Optimierung nur, wenn jemalloc verwendet wird und alle erforderlichen Werte konfiguriert sind.
Bei größeren Installationen sollte die anfängliche Synchronisierung isoliert oder generische Synchronisierungs-Worker hinzugefügt werden, wenn die Messwerte dies rechtfertigen.
Speicher und Latenz sollten nach jeder Änderung gemeinsam überwacht werden.
Synapse ist bewusst speicherintensiv, da Caching Teil seiner Performance-Strategie ist. Die richtige Lösung für synchronisierungsbedingte Speichermangelprobleme (OOM) besteht daher in einem ausgewogenen Vorgehen: Unnötige Cache-Speicherung entfernen, Datenbank- oder Anfragerückstände abbauen und außergewöhnliche Arbeitslasten isolieren, ohne die Caches zu beeinträchtigen, die für eine schnelle normale Synchronisierung sorgen. Dieser Ansatz ist zuverlässiger, als den höchsten RSS-Wert als alleiniges Problem zu betrachten.