Startseite
» NETZWERK-ADMIN
»
So konfigurieren Sie S3-Objektspeicher für ownCloud Infinite Scale
So konfigurieren Sie S3-Objektspeicher für ownCloud Infinite Scale
ownCloud Infinite Scale kann S3-kompatiblen Objektspeicher für Dateiblobs nutzen, während die Metadaten auf einem POSIX-konformen Dateisystem gespeichert werden. Dieses Prinzip ist grundlegend: S3 ist kein direkter Ersatz für jedes lokale Datenverzeichnis. Im unterstützten s3ngLayout speichert der Objektspeicher den Binärinhalt der Dateien, während die Metadaten auf einem POSIX-Speicher wie einem lokalen Dateisystem oder NFS verbleiben.
Dieser Leitfaden orientiert sich an der aktuellen ownCloud Infinite Scale-Speicherdokumentation (Stand: Oktober 2026). Er richtet sich an Administratoren, die mit dem s3ngTreiber noch nicht vertraut sind und eine Konfiguration benötigen, die sie verstehen können, bevor sie diese an Docker Compose, systemd, Kubernetes oder eine andere Bereitstellungsmethode anpassen.
S3 ist eine Objektspeicher-API, die ursprünglich von Amazon eingeführt wurde. Ein S3-kompatibler Dienst speichert Daten als Objekte in einem Bucket und stellt Operationen über HTTP-basierte APIs bereit. ownCloud Infinite Scale verwendet den s3ngSpeichertreiber, um Dateiblobs in einem solchen Bucket abzulegen.
POSIX-Speicher bedeutet ein Dateisystem, das das von Infinite Scale für Metadaten erwartete Dateisystemverhalten bereitstellt. Bei diesem Speichertyp s3ngwerden Metadaten nicht in den S3-Bucket verschoben. ownCloud dokumentiert explizit, dass Blobs in S3 gespeichert werden, während Metadaten auf dem POSIX-Speicher verbleiben.
Diese Unterscheidung verhindert einen häufigen Fehler: Infinite Scale auf einen Bucket zu verweisen und anzunehmen, dass sich nun der gesamte Serverzustand dort befindet. Das ist nicht der Fall. Ihr Backup- und Wiederherstellungsplan muss sowohl die POSIX-seitigen Metadaten als auch die S3-seitigen Blobs abdecken.
Schritt 1: Bucket, Metadatenspeicher, Anmeldeinformationen und Netzwerkpfad vorbereiten
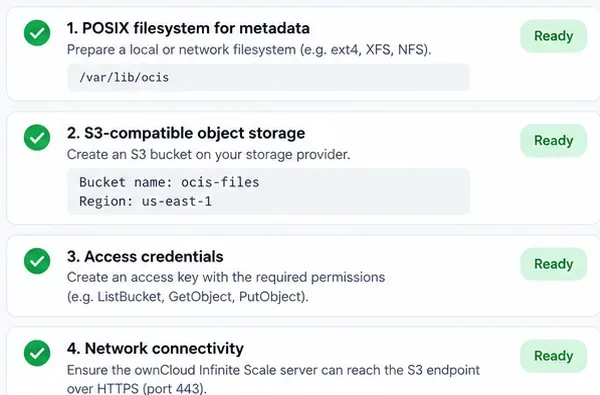
Bevor Sie Infinite Scale ändern, bereiten Sie bitte vier Dinge vor:
Ein dedizierter S3-Bucket.
Ein POSIX-konformer Pfad für s3ngMetadaten. Bei einer Bereitstellung mit mehreren Knoten empfiehlt ownCloud, den gemeinsam genutzten Speicher sorgfältig zu überdenken; NFS wird häufig verwendet, wenn mehrere Infinite Scale-Instanzen Zugriff auf den Metadatenpfad benötigen.
Ein Zugriffsschlüssel und ein geheimer Schlüssel mit ausschließlich den Bucket-Berechtigungen, die Infinite Scale benötigt.
Netzwerkerreichbarkeit vom Infinite Scale-Host oder -Container zum S3-Endpunkt, normalerweise über HTTPS.
Bevor Sie die Infinite Scale-Konfiguration bearbeiten, bereiten Sie den POSIX-Metadatenpfad, den S3-Bucket, die Anmeldeinformationen und die Netzwerkverbindung vor.
Machen Sie den Bucket nicht öffentlich. Infinite Scale authentifiziert sich mit Anmeldeinformationen am Bucket; öffentlicher Zugriff ist weder erforderlich noch wünschenswert. Vermeiden Sie außerdem die Wiederverwendung allgemeiner Administratoranmeldeinformationen, wenn eine dedizierte Dienstidentität erstellt werden kann.
Bei Verwendung von Amazon S3 entsprechen Endpunkt und Region den AWS-Konventionen. Bei Verwendung eines anderen S3-kompatiblen Anbieters informieren Sie sich bitte in der Dokumentation des Anbieters über dessen Endpunktformat, Regionsverhalten, TLS-Anforderungen und Richtliniensyntax. ownCloud weist ausdrücklich darauf hin, dass sich das Verhalten, beispielsweise bei Verschlüsselungsdetails, je nach Anbieter unterscheiden kann.
Schritt 2: Aktivieren Sie den s3ng-Treiber und geben Sie die S3-Verbindungseinstellungen an.
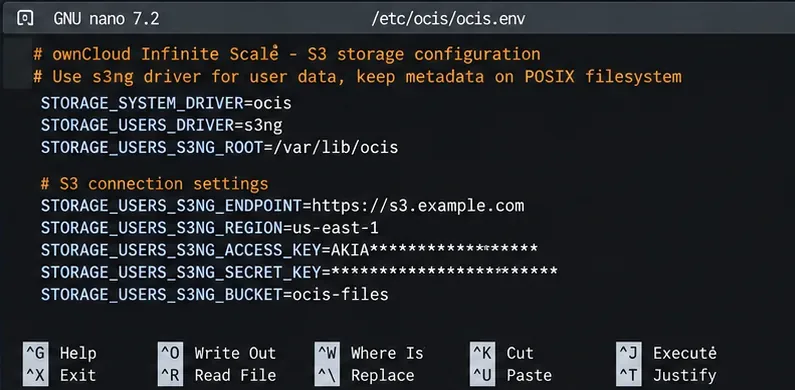
Die Kernspeichereinstellung ist STORAGE_USERS_DRIVER=s3ng. Der Dienst „Speicherbenutzer“ ist die Infinite Scale-Komponente, die für die Speicherung von Benutzerdateien zuständig ist. Die offizielle Konfiguration belässt den Systemspeichertreiber ebenfalls im normalen ocisBackend.
Ein minimaler Satz von Umgebungsvariablen sieht folgendermaßen aus:
Die essentiellen s3ng-Umgebungsvariablen verbinden den Storage-Users-Dienst mit S3 und erhalten dabei die Metadaten auf POSIX-Speichern.
Die Beispielwerte sind Platzhalter. Verwenden Sie den Endpunkt, die Region, den Bucket und die Anmeldeinformationen, die Sie von Ihrem Anbieter erhalten haben. Speichern Sie den geheimen Schlüssel nicht in einem öffentlichen Git-Repository. Verwenden Sie bei der Container-Orchestrierung vorzugsweise den Mechanismus zur Geheimnisverwaltung der Plattform, anstatt Anmeldeinformationen direkt in eine Compose-Datei oder ein Manifest einzubetten.
Die Art der Bereitstellung bestimmt, wo diese Variablen abgelegt werden. Bei einer Docker-Compose-Bereitstellung werden sie entweder im environmentAbschnitt des Infinite-Scale-Dienstes platziert oder aus einer Umgebungsvariablendatei geladen. Eine systemd-Bereitstellung kann eine Umgebungsvariablendatei oder eine Unit-Konfiguration verwenden. Kubernetes fügt sie üblicherweise über ein Secret und ein Deployment oder StatefulSet ein. Die Variablennamen sind entscheidend; die umgebende Syntax hängt von Ihrer Plattform ab.
Schritt 3: Erteilen Sie dem Bucket die von Infinite Scale benötigten Berechtigungen.
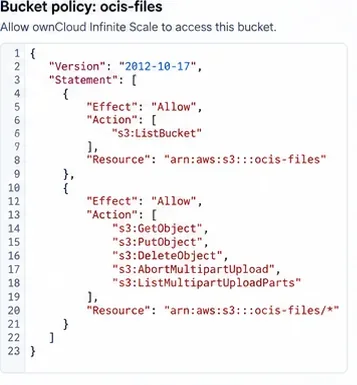
Eine Bucket-Richtlinie ist eine Regel für Identitäts- und Zugriffsmanagement (IAM), die steuert, welche Aktionen eine authentifizierte Identität für einen Bucket und dessen Objekte ausführen darf. ownCloud veröffentlicht ein erforderliches Richtlinienmuster für den s3ngTreiber.
Ersetzen Sie bucket-namein der folgenden Richtlinie durch Ihren tatsächlichen Bucket-Namen:
Die Richtlinienstruktur muss das Auflisten von Buckets sowie die vom s3ng-Treiber benötigten Objekt- und Multipart-Upload-Operationen ermöglichen. Verwenden Sie für Ihre Bereitstellung die exakte Richtlinie aus der offiziellen Dokumentation.
Beheben Sie einen Zugriffsfehler nicht, indem Sie s3:*die Berechtigungen für alle Buckets im Konto erteilen. Verwenden Sie zunächst die dokumentierten Bucket-bezogenen Berechtigungen und passen Sie diese erst an, wenn Ihr S3-Anbieter eine anbieterspezifische Entsprechung erfordert.
Schritt 4: Starten Sie Infinite Scale neu und überprüfen Sie den Speicherpfad.
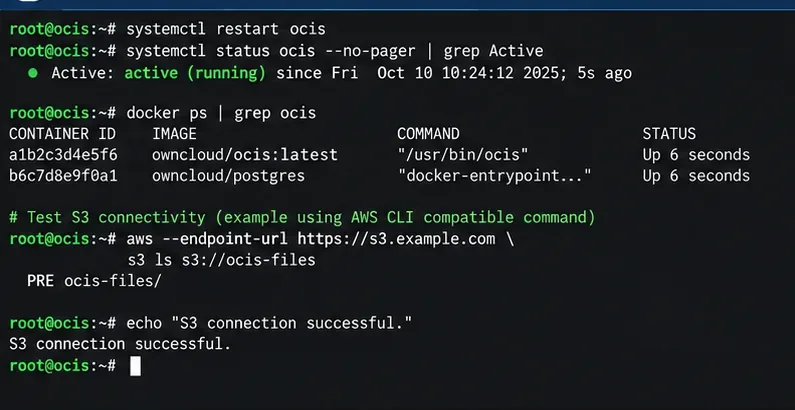
Wenden Sie die Konfiguration mithilfe des normalen Neustartverfahrens Ihrer Bereitstellung an. Beispielsweise kann eine systemd-Installation den Befehl `systemd start` verwenden systemctl restart ocis, während eine Compose-Bereitstellung die betroffenen Service-Container neu erstellt oder neu startet. Überprüfen Sie die Protokolle unmittelbar nach dem Start auf Authentifizierungs-, DNS-, TLS-, Regions- oder Berechtigungsfehler.
Nach Anwendung der Konfiguration starten Sie die entsprechenden Infinite Scale-Dienste neu und überprüfen Sie, ob der Host den vorgesehenen Bucket erreichen und sich dort authentifizieren kann.
Eine Bucket-Auflistung mit der CLI Ihres S3-Anbieters beweist zwar, dass Host und Zugangsdaten den Bucket erreichen können, aber nicht, dass Infinite Scale Blobs korrekt schreibt. Der aussagekräftigere End-to-End-Test besteht darin, Infinite Scale zu starten, eine kleine Datei über die ownCloud-Weboberfläche hochzuladen, sie wieder herunterzuladen und die Service-Logs auf Fehler zu überprüfen.
Wenn Ihre installierte Infinite Scale-Version den von ownCloud dokumentierten Befehl zur Blobstore-Wartung enthält, können Sie diesen ebenfalls verwenden ocis storage-users blobstore check. ownCloud beschreibt diesen Befehl als einen Upload-/Download-/Löschvorgang im konfigurierten Blobstore. Die versionsspezifische Syntax finden Sie in der offiziellen Dokumentation zur Blobstore-Verifizierung .
Erwarten Sie nicht, dass die ursprünglichen Dateinamen als normale S3-Objekte angezeigt werden.
Ein häufiges Missverständnis besteht darin, beim Durchsuchen des Buckets eine vertraute Benutzerordnerstruktur zu erwarten Documents/report.pdf. Infinite Scale behandelt S3 als Blob-Speicher, nicht als benutzerseitiges Dateisystem. Das dokumentierte s3ngSchlüsselformat basiert auf Space-IDs und Blob-IDs, während der lesbare Namensraum aus Metadaten rekonstruiert wird.
Das bedeutet, dass Sie Objekte im Bucket nicht manuell umbenennen, neu organisieren oder löschen sollten, nur weil deren Schlüssel ungewöhnlich aussehen. Verwalten Sie Benutzerdateien über ownCloud. Direkte Bucket-Manipulationen können die Verknüpfung zwischen Metadaten und Blobs beeinträchtigen.
Große Uploads: Überprüfen Sie die Größe der mehrteiligen Teile vor der Produktion.
S3 verwendet Multipart-Upload , um große Objekte in Teile aufzuteilen. ownCloud dokumentiert STORAGE_USERS_S3NG_PUT_OBJECT_PART_SIZEdie Steuerung der Teilgröße. Der dokumentierte Standardwert beträgt 16 MiB, wenn kein expliziter Wert angegeben wird.
Amazon S3 erlaubt maximal 10.000 Teile in einem Multipart-Upload. Bei einer Teilegröße von 16 MiB entspricht dies etwa 160 GiB, bevor die Teileanzahlbegrenzung zum Problem wird. Wenn Ihre Benutzer regelmäßig größere Dateien hochladen, berechnen Sie die erforderliche Teilegröße vor der Inbetriebnahme, anstatt auf einen Fehler bei einer großen Übertragung zu warten.
Der Kompromiss ist einfach: Größere Speicherkapazitäten unterstützen größere Dateien mit weniger Anfragen, verändern aber auch Speicherbedarf, Pufferung, Wiederholungsversuche und Übertragungseigenschaften. ownCloud weist außerdem darauf hin, dass eingehende Dateidaten während der Pufferung temporären Speicherplatz benötigen. Daher muss die Kapazitätsplanung mehr als nur den Remote-Bucket berücksichtigen.
Häufige Probleme und was Sie zuerst überprüfen sollten
Symptom
Wahrscheinliches Gebiet
Zuerst prüfen
Zugriff verweigert
Anmeldeinformationen oder Bucket-Richtlinie
Bestätigen Sie den Zugriffsschlüssel, den geheimen Schlüssel, den Bucket-ARN und die erforderlichen Aktionen.
Bucket nicht gefunden
Bucket-Name, Endpunkt oder Region
Überprüfen Sie den genauen Bucket-Namen und die anbieterspezifische Endpunkt-/Regionskombination.
TLS- oder Zertifikatsfehler
HTTPS-Vertrauen
Prüfen Sie, ob das Endpunktzertifikat innerhalb des Infinite Scale-Hosts/Containers gültig und vertrauenswürdig ist.
Kleine Dateien funktionieren, aber sehr große Dateien schlagen fehl.
Mehrteilige Größenbestimmung
Prüfen Sie STORAGE_USERS_S3NG_PUT_OBJECT_PART_SIZEdie Mehrteilbeschränkungen Ihres Anbieters.
Dateien verschwinden, nachdem nur S3 wiederhergestellt wurde.
Unvollständige Datensicherung
POSIX-Metadaten und S3-Blobs als einen konsistenten Datensatz wiederherstellen.
Sichern Sie S3-Blobs und POSIX-Metadaten zusammen
Bei s3ngder Verwendung von S3 stellt der Bucket nur die Hälfte des Speicherzustands dar. Laut der Backup-Dokumentation von ownCloud muss eine verteilte S3-Konfiguration Konfigurationsdaten, Systemdaten, Metadaten und Blobs enthalten. Die Wiederherstellungsdokumentation setzt ebenfalls voraus, dass diese Datensätze konsistent wiederhergestellt werden.
Für einen Produktionsdienst dokumentieren Sie die Metadaten-Einbindung, den Bucket, die Anmeldeinformationen bzw. die Rolle, die Konfigurationsdateien und das Backup-Verfahren im selben Runbook. Testen Sie die Wiederherstellung, bevor Sie sich auf das Design verlassen. Die relevanten offiziellen Referenzen sind der ownCloud-Backup-Leitfaden und die Hinweise zur Wiederherstellung .
Empfohlener Ausgangspunkt
Für eine erste Bereitstellung sollte das Design einfach gehalten werden: Verwenden Sie einen dedizierten S3-Bucket für Blobs, einen persistenten POSIX-Metadatenpfad, eine dedizierte Dienstidentität mit den dokumentierten Bucket-Berechtigungen, HTTPS zum Objektspeicherendpunkt und die Standardeinstellungen für Multipart-Daten, es sei denn, Ihre erwarteten Dateigrößen erfordern eine Änderung.
Nach der Konfiguration sollten Sie drei Ebenen separat prüfen: Netzwerk- und Anmeldeinformationen für den Bucket, Start von Infinite Scale ohne Speicherfehler und einen tatsächlichen Upload/Download über ownCloud. Sobald diese Prüfungen erfolgreich verlaufen, fahren Sie mit Monitoring, Backups, Lebenszyklusregeln und Leistungsoptimierung fort. Diese Vorgehensweise vereinfacht die Fehlersuche erheblich, da jeder Test eine andere Frage beantwortet, anstatt „S3 funktioniert“ als ein einziges Alles-oder-Nichts-Ergebnis zu behandeln.