Inicio
» ADMINISTRADOR DE RED
»
Buenas prácticas de monitorización de redes: qué monitorizar y qué herramientas utilizar.
Buenas prácticas de monitorización de redes: qué monitorizar y qué herramientas utilizar.
La monitorización eficaz de la red comienza con un inventario verificado, métricas centradas en el servicio y alertas procesables. Identifique los dispositivos y servicios críticos, determine el rendimiento normal y, a continuación, elija una plataforma compatible con su infraestructura y que su equipo pueda mantener. Esto ayuda a detectar problemas incipientes sin necesidad de registrar cada pequeña fluctuación en un informe detallado.
Lo que la monitorización de la red debería indicarle
La monitorización de la red realiza un seguimiento de la accesibilidad de los dispositivos y servicios, así como de su rendimiento a lo largo del tiempo. Generalmente abarca el estado de los dispositivos y las interfaces, el tráfico, los recursos del servidor y las comprobaciones de los servicios. El registro de seguridad tiene una función diferente: un sistema de gestión de red (NMS) explica la disponibilidad y el rendimiento, mientras que los registros centralizados o un sistema de gestión de información de seguridad de la información (SIEM) ayudan a investigar eventos como inicios de sesión sospechosos y cambios de configuración. Muchos equipos utilizan ambos. El NIST define la monitorización continua como una herramienta para la toma de decisiones sobre riesgos; es fundamental revisar la cobertura de la red a medida que el entorno cambia.
mejores prácticas de monitorización de redes
1. Crea un inventario antes de configurar las alertas.
Enumere los enrutadores, conmutadores, cortafuegos, equipos inalámbricos, servidores críticos, enlaces en la nube y servicios de atención al cliente. Para cada uno, registre la ubicación, el propietario, la prioridad comercial, la dirección de administración y las dependencias. Utilice la detección para inicializar el inventario, verifíquelo y agregue los dispositivos que no se detecten automáticamente. Agrupe por sitio o servicio. Actualice la lista después de cada cambio para mantener una cobertura completa.
Un ejemplo de vista de topología vincula el estado del dispositivo con las dependencias ascendentes y descendentes.
2. Monitorear las señales que explican el impacto del usuario.
Comience con un conjunto compacto de mediciones vinculadas a servicios críticos:
Disponibilidad: estado del dispositivo y la interfaz, además de comprobaciones de servicios esenciales como DNS, aplicaciones web, correo electrónico o acceso VPN.
Calidad de la ruta: latencia, pérdida de paquetes y fluctuación (jitter) en los casos en que la voz o el vídeo en tiempo real dependen de ella.
Tráfico y capacidad: utilización de la interfaz, rendimiento, errores y descartes. Mantenga un historial para poder distinguir un pico puntual de un problema de capacidad recurrente.
Estado del dispositivo: estado de la CPU, la memoria, la temperatura, la alimentación o el ventilador, siempre que el equipo muestre esas lecturas.
Sistemas de soporte: almacenamiento del servidor y estado del servicio cuando una interrupción de la aplicación podría deberse a causas externas a la capa de red.
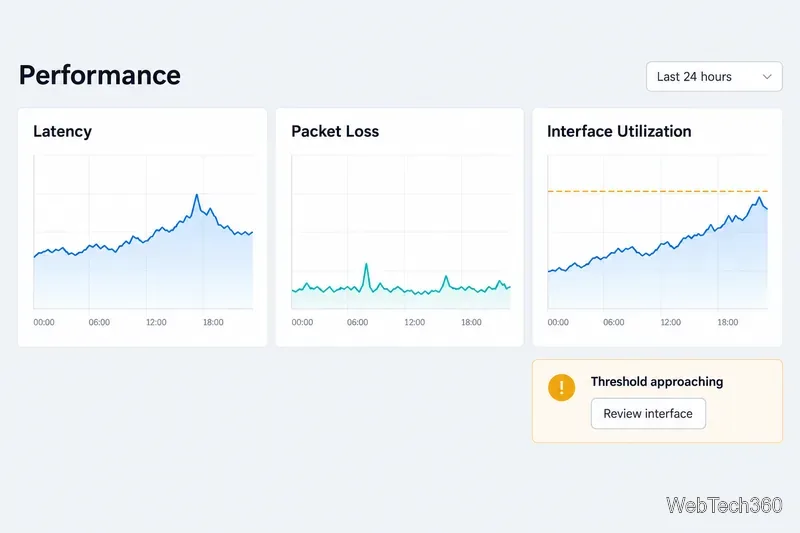
Establezca valores de referencia por sitio y servicio en lugar de utilizar un umbral universal. Compare el comportamiento actual con los períodos de mayor actividad habituales y observe si hay presión sostenida o cambios repentinos.
Un ejemplo de panel de rendimiento ayuda a diferenciar la variación normal de la presión sostenida sobre un enlace.
3. Haga que las alertas sean procesables y reduzca los duplicados.
Alerta sobre condiciones que requieren acción: interrupciones, fallos en las comprobaciones de servicio o incumplimientos prolongados de los umbrales. Utiliza una regla de retardo o recuperación para filtrar fluctuaciones transitorias. Incluye el dispositivo o la interfaz, el servicio o sitio afectado, la hora de la primera detección, los valores observados y esperados, y un manual de procedimientos. Enruta las alertas a un responsable y define el procedimiento de escalamiento.
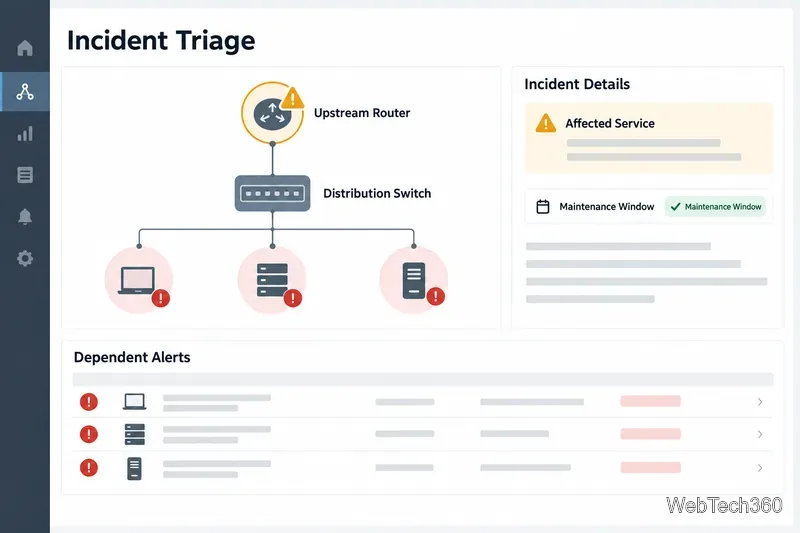
Agrupe las alertas descendentes cuando un fallo ascendente las explique; programe ventanas de mantenimiento para los trabajos planificados. Esto ayuda a los equipos de respuesta a encontrar las causas probables con mayor rapidez. Revise las reglas de supresión después de los cambios de topología para que los fallos independientes sigan siendo visibles.
Un ejemplo de vista de incidentes muestra cómo las alertas dependientes pueden orientar a los equipos de respuesta hacia el primer enlace que falló.
4. Proteger el sistema de monitoreo
La supervisión de credenciales y registros puede revelar información confidencial de la infraestructura. Restrinja el tráfico de administración, utilice cuentas de solo lectura siempre que sea posible, otorgue acceso basado en roles y proteja el servidor de supervisión y las copias de seguridad. Priorice SNMPv3 cuando sea compatible, con la autenticación y la configuración de privacidad adecuadas; el modelo de seguridad basado en usuarios de SNMPv3 define estos servicios de seguridad. Siga las directrices de CISA para la protección de registros y nunca exponga las interfaces de administración directamente a internet.
5. Cobertura de pruebas, alertas y recuperación
Confirme que las sondas llegan a los dispositivos desde las ubicaciones pertinentes, que las credenciales funcionan y que se conserva el historial para la resolución de problemas y la planificación de capacidad. Pruebe las alertas con sus destinatarios; documente a los responsables y los programas de mantenimiento. Revise los dispositivos obsoletos, las brechas y las reglas problemáticas después de los cambios en la red. Mantenga un plan de recuperación probado para la plataforma de monitoreo.
Tres herramientas de monitoreo de red para evaluar
Estos productos cubren necesidades comunes. La idoneidad depende de su entorno, modelo de implementación, licencias y habilidades disponibles. Verifique los planes y la compatibilidad con dispositivos con cada proveedor.
Herramienta
Dónde podría encajar
Comprobar durante la evaluación
Monitor de rendimiento de red de SolarWinds
Entornos con múltiples proveedores que requieren métricas de dispositivos, mapas, alertas, informes o solución de problemas de ruta. El proveedor proporciona información sobre disponibilidad, latencia, pérdida de paquetes, utilización y estado del dispositivo.
Verifique la compatibilidad con dispositivos y protocolos, la implementación, la retención y los módulos necesarios. Consulte SolarWinds NPM .
Monitor de red Paessler PRTG
Equipos que supervisan dispositivos, tráfico, servidores y servicios mediante mapas, paneles de control y notificaciones. PRTG representa los valores supervisados como sensores.
Calcule las necesidades de sensores y sondas para su plan de cobertura. Consulte Paessler PRTG .
ManageEngine OpManager
Organizaciones que buscan detectar y monitorizar el rendimiento de dispositivos y servidores de red. La documentación describe la compatibilidad con SNMP, CLI y WMI.
Verifique el acceso al protocolo, las plantillas, los controles de roles, los complementos y la administración de sitios remotos. Consulte OpManager .
Elija con un piloto pequeño
Prueba un sitio representativo, un servicio crítico y una combinación de dispositivos. Evalúa la detección, la precisión de las métricas, las alertas, la gestión del mantenimiento, los informes, los permisos y la recuperación. Pregunta a los usuarios del panel qué información falta. Una prueba piloto breve te permitirá comprobar si la plataforma se adapta mejor a tu red que una simple lista de funciones.