Inicio
» MS OFFICE
»
How to Fix Collabora Online High CPU Usage from loolwsd / coolwsd
How to Fix Collabora Online High CPU Usage from loolwsd / coolwsd
When Collabora Online suddenly uses most of a server's CPU, the most important first step is not to restart it repeatedly or immediately impose a very low CPU limit. First determine whether the load comes from normal document work, one pathological document session, too much parallel work, an idle session that is not being cleaned up, or a version-specific regression. The process name may be coolwsd on current releases and loolwsd on older installations.
Illustrative scenario: imagine an 8-vCPU server running Collabora Online behind Nextcloud. Only a few people appear to be editing documents, but the Collabora container sits around 250% to 350% CPU for several minutes. This is a hypothetical example used throughout this guide, not a measured benchmark or a report from a real deployment.
As of October 2026, Collabora's current stable branch is 26.04, and the official release notes list Collabora Online 26.04.3.3 as released on September 14, 2026. Current configuration templates use the coolwsd name. Collabora's migration tooling still documents the older /etc/loolwsd/loolwsd.xml path for installations from the 6.4 era or earlier, which is why administrators may still encounter both names.
1. Confirm which process is actually consuming CPU
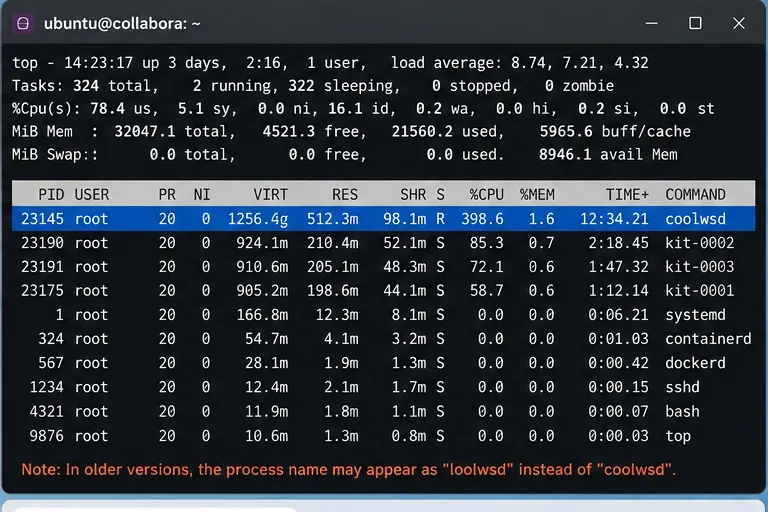
Start at the operating-system or container level. A high number beside coolwsd does not automatically mean the coordinating daemon itself is doing all of the expensive document work. Collabora also runs kit/forkit processes for document sessions, so you want the process tree and per-process CPU usage before changing configuration.
ps -eo pid,ppid,pcpu,pmem,etime,cmd --sort=-pcpu | head -n 25
top -H -p $(pgrep -d, -f 'coolwsd|loolwsd|coolkit|loolkit|forkit')
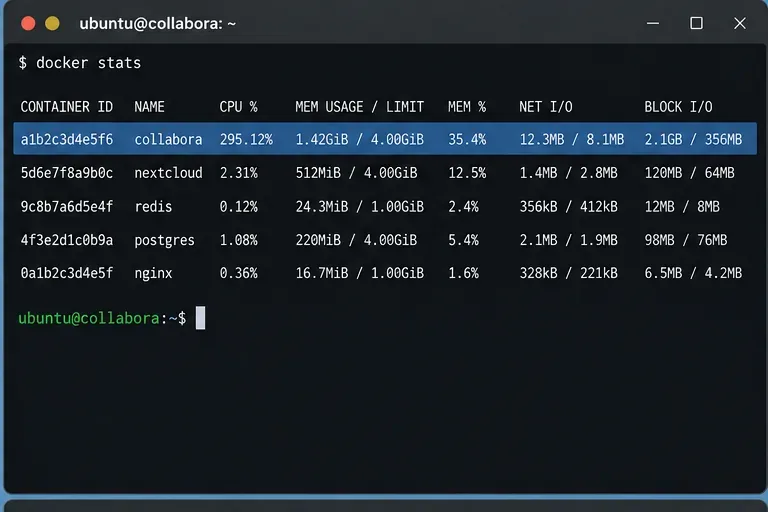
For Docker, also check the container as a whole:
docker stats --no-stream
A process-level view helps separate the main Collabora daemon from document-related kit processes before any tuning is attempted.Container-level CPU is useful for confirming that Collabora is the source of host load, but it does not identify the document or child process responsible.
In the illustrative scenario, suppose the container is near 300% CPU and one kit process is consistently at the top of the process list. That points you toward a specific active document session rather than a generic assumption that the entire server is overloaded.
2. Check Collabora's own metrics instead of relying only on top
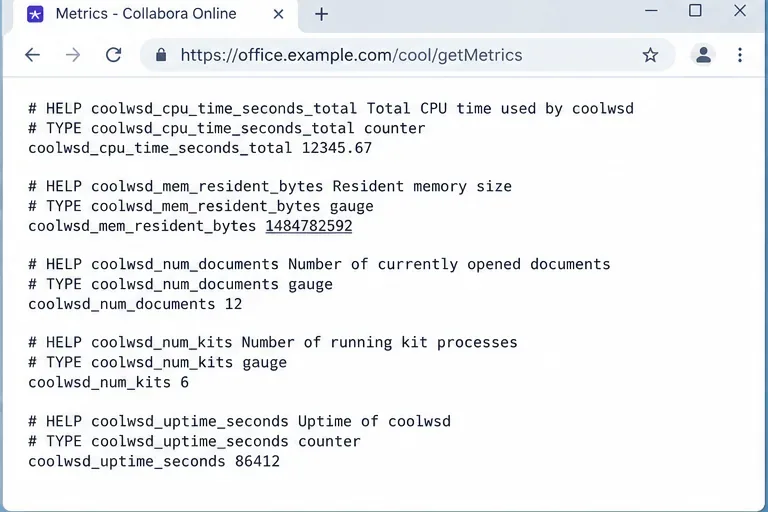
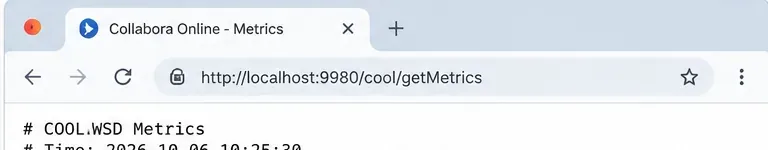
Collabora Online exposes Prometheus-compatible metrics at /cool/getMetrics. The current SDK manual says this endpoint can report CPU and memory use, running kit processes, views, and other server-usage data. It uses the same authentication as the admin console unless metrics are explicitly configured for unauthenticated access.
No exponga públicamente el punto final de métricas solo para simplificar la resolución de problemas. La configuración oficial de Helm incluye incluso ejemplos de /cool/getMetricsURL de bloqueo y administración en un ingress. Utilice una ruta interna autenticada siempre que sea posible.
El punto final de métricas de Collabora proporciona contexto del lado del servidor que complementa las mediciones de CPU de Linux o Docker.
Busque una relación entre el uso de la CPU y los documentos o vistas activos. Si el uso de la CPU aumenta y disminuye con la actividad de edición legítima, podría haber un problema de capacidad o concurrencia. Si la CPU se mantiene alta sin actividad interactiva correspondiente, investigue sesiones inactivas, un documento problemático, tareas repetidas en segundo plano o un problema de software.
3. Lea los registros en el momento exacto en que aumenta el uso de la CPU.
Para la instalación de paquetes gestionada por systemd:
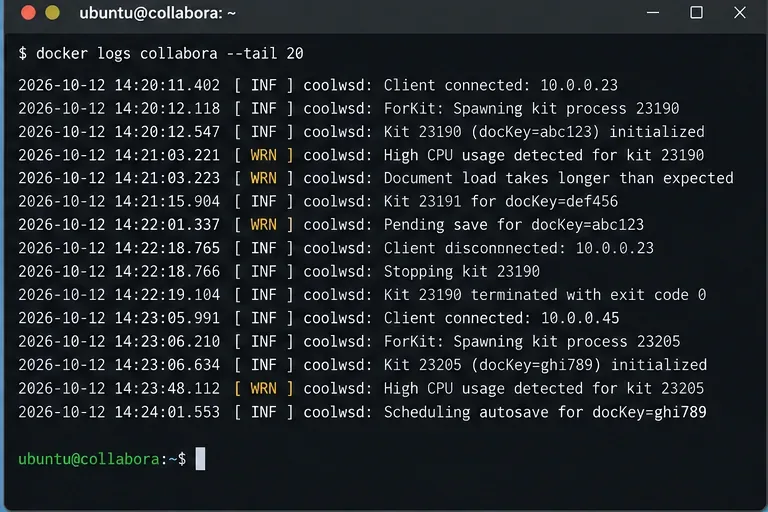
Si su servicio o contenedor tiene un nombre diferente, sustitúyalo. Busque cargas de documentos repetidas, creación de kits repetida, errores al guardar, bloqueos, bucles de reconexión o la aparición repetida de la misma clave de documento. Un breve período de mayor uso de CPU durante la apertura, el recálculo, la representación, la conversión o la exportación de documentos puede ser normal. La señal de alerta más clara es un uso sostenido de CPU sin progreso útil o la repetición del mismo fallo.
Correlaciona los registros con el momento del pico de uso de la CPU para que puedas distinguir la actividad normal de los documentos del trabajo repetitivo o bloqueado.
4. Reproduzca el pico con un documento a la vez.
Regresa al servidor hipotético. Si un proceso del kit está activo, cierra o aísla el documento sospechoso y observa si disminuye el uso de la CPU. Luego, abre ese mismo archivo durante un período de baja actividad mientras monitoreas la lista de procesos y las métricas. Repite el proceso con un documento de prueba sencillo.
Esta comparación resulta más útil que reiniciar inmediatamente todo el servicio:
Si solo un archivo desencadena el pico de forma fiable, el contenido del archivo, las fórmulas, los objetos incrustados, la carga de trabajo de renderizado o un error específico del documento son sospechosos más probables.
Si cada archivo provoca una saturación similar cuando varios usuarios están activos, investigue la capacidad del servidor y la concurrencia.
Si el uso de la CPU sigue siendo alto después de que cese toda la actividad del usuario, concéntrese en la limpieza, los kits obsoletos, las tareas repetidas en segundo plano o una regresión.
Si el problema comenzó inmediatamente después de una actualización, registre las versiones antigua y nueva antes de cambiar muchas otras variables.
5. Reduzca la concurrencia por documento cuando un documento pueda monopolizar los núcleos.
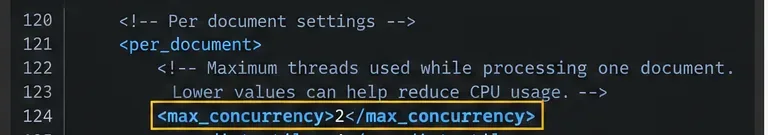
La plantilla de configuración actual de Collabora per_document.max_concurrencyespecifica el número máximo de subprocesos que se pueden usar al procesar un documento. El valor predeterminado de la plantilla es 4. En un servidor pequeño, o cuando un único documento complejo puede sobrecargar la máquina, reducir este valor puede hacer que el uso de la CPU sea más predecible.
Reducir la concurrencia por documento implica una compensación: puede disminuir la intensidad con la que un documento utiliza la CPU, pero las operaciones pesadas pueden tardar más tiempo.
No copie el número 2 a ciegas. Si los usuarios manejan habitualmente hojas de cálculo o presentaciones extensas y el servidor cuenta con suficientes núcleos, un valor inferior podría simplemente ralentizar el trabajo. Modifique una configuración, reproduzca la misma carga de trabajo y compare el uso de la CPU, la capacidad de respuesta y el tiempo de finalización.
6. Verifique la configuración de limpieza y de sesión inactiva antes de hacerlas más agresivas.
La plantilla actual coolwsd.xmlincluye lógica de limpieza para documentos inactivos que consumen muchos recursos. Al momento de redactar este documento, la plantilla muestra un intervalo de verificación de limpieza de 10 000 ms, un período de comportamiento anómalo de 60 segundos, un umbral de inactividad de 300 segundos y un umbral de CPU del 85 % para que un documento se convierta en candidato a limpieza. También incluye un tiempo de espera de inactividad por documento de 3600 segundos.
La misma plantilla incluye tiempos de espera por vista. Los valores actuales indican 300 segundos antes de que una vista del navegador que no esté en primer plano se atenúe y deje de actualizarse, y 900 segundos antes de que una vista inactiva reciba un tratamiento similar. Estos tiempos de espera no equivalen a la descarga inmediata de toda la sesión del documento.
Los controles de limpieza y de visualización en segundo plano pueden reducir el trabajo improductivo, pero deben ajustarse con cautela para que las sesiones de edición prolongadas no se vean interrumpidas.
Evite establecer un umbral de CPU extremadamente bajo solo para mejorar el aspecto del gráfico. La limpieza está diseñada para detectar documentos defectuosos o inactivos que consumen muchos recursos, no para interrumpir la edición activa ordinaria cuando esta se vuelve computacionalmente costosa.
7. Reinicie solo después de guardar un cambio de configuración controlado.
Primero, realiza una copia de seguridad de la configuración activa. Las instalaciones de paquetes suelen usar /etc/coolwsd/coolwsd.xml. Las implementaciones de Docker pueden pasar opciones como variables de entorno o anulaciones de línea de comandos, o montar un archivo de configuración en el contenedor. Confirma qué fuente está activa antes de editar nada.
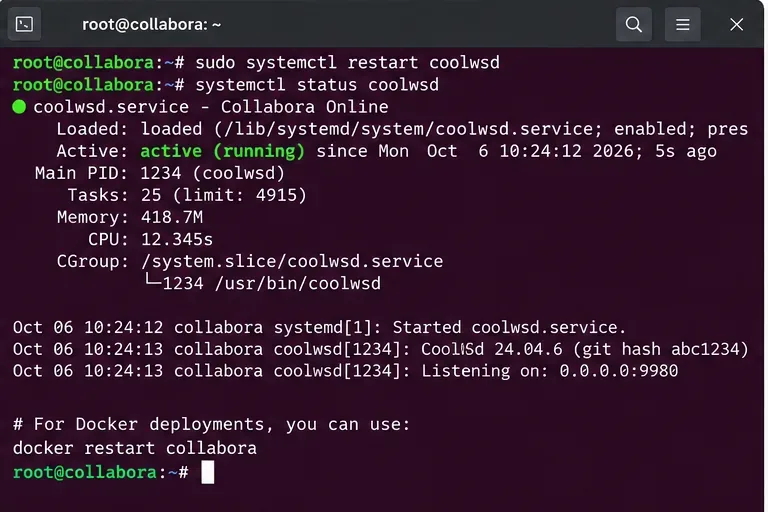
Reinicie el sistema únicamente después de realizar un cambio de configuración deliberado y con copia de seguridad, y verifique que el servicio funcione correctamente antes de que los usuarios reanuden las pruebas.
Si reiniciar el sistema soluciona temporalmente el problema de la CPU, pero este reaparece repetidamente, se trata de información de diagnóstico, no de una solución permanente. Continúe hasta que pueda explicar qué carga de trabajo o estado provoca la recurrencia.
8. Comparar antes y después bajo la misma carga de trabajo.
Utilice el mismo documento, aproximadamente el mismo número de usuarios y la misma secuencia de operaciones. Mida durante varios minutos en lugar de comparar un instante puntual. En el escenario ilustrativo, el éxito significaría que el servidor ya no se satura durante la carga de trabajo reproducida, mientras que la apertura, edición, guardado y colaboración de documentos siguen funcionando correctamente.
Utilice el mismo punto final de métricas después de cada cambio controlado para que la comparación antes y después se base en datos de servidor comparables.
Observación
Posible próxima acción
Un documento o kit se mantiene caliente
Reproduzca el problema con ese archivo, conserve los registros y realice la prueba en la versión micro estable actual.
La CPU realiza un seguimiento del número de usuarios activos.
En lugar de tratar la carga como una fuga, revise la capacidad, la concurrencia y el dimensionamiento del despliegue.
El uso de la CPU se mantiene alto después de que los usuarios se van.
Inspeccione los documentos inactivos, el comportamiento de limpieza, los trabajos en segundo plano repetidos y los kits huérfanos o que se reinician.
Spike comenzó inmediatamente después de una actualización.
Anote las versiones exactas y consulte las notas de la versión actual y los problemas conocidos antes de modificar muchos valores de configuración.
Un valor menor de max_concurrency reduce el uso de CPU, pero la edición se vuelve lenta.
Auméntalo gradualmente o aumenta la capacidad de la CPU; esta configuración implica una compensación, no una solución universal.
¿Cuándo conviene actualizar en lugar de optimizar?
Si el problema comenzó con una versión específica de Collabora y puede reproducirlo con un archivo u operación concretos, es posible que la optimización de la configuración solo oculte un defecto de software. Collabora recomienda usar la última versión de la rama estable actual. A fecha de 7 de octubre de 2026, la página oficial de notas de la versión 26.04 indica que la última versión de Collabora Online disponible es la 26.04.3.3.
Para los usuarios de CODE, recuerden que Collabora describe la Edición de Desarrollo como apropiada para equipos pequeños, uso doméstico, desarrollo y para probar nuevas funcionalidades, pero aclara que no está diseñada para entornos de producción. Por lo tanto, un incidente en producción en CODE podría justificar la migración al producto Collabora Online compatible, en lugar de intentar sin cesar solucionar el comportamiento de la edición de desarrollo.
Qué no hacer
No asuma que un coolwsdnúmero elevado demuestra una fuga de memoria o un bucle infinito.
No active de forma permanente el registro de depuración o de seguimiento durante un incidente de CPU a menos que realmente lo necesite; el registro detallado añade su propia sobrecarga y presión de almacenamiento.
No exponga la consola de administración ni el punto final de métricas a Internet pública solo por comodidad de monitorización.
No reduzca los umbrales de limpieza hasta que se estén finalizando las sesiones activas normales.
No utilice cuotas de CPU como primer paso de diagnóstico. Un límite estricto puede proteger a los usuarios vecinos en un servidor compartido, pero podría convertir un problema de CPU en una renderización lenta de documentos y tiempos de espera agotados sin revelar la causa.
Orden de solución de problemas recomendada
Confirme si el proceso ocupado es coolwsd, un proceso anterior loolwsdo un proceso de kit/prekit infantil.
Registra la CPU, la memoria, los documentos activos y las vistas de Docker o del host.
Correlacione los registros con la ventana temporal exacta del pico.
Reproduzca el resultado con un documento sospechoso y, a continuación, con un documento de control sencillo.
Realiza la prueba per_document.max_concurrencyúnicamente si un documento está utilizando demasiada CPU en paralelo.
Revisa la configuración de limpieza y de inactividad sin hacerla innecesariamente agresiva.
Reinicie el sistema después de cada cambio de configuración controlado y verifique el estado del servicio.
Compare la misma carga de trabajo antes y después, y luego verifique la versión estable actual si el comportamiento parece específico de la versión.
El objetivo práctico no es obligar a Collabora Online a usar la menor cantidad de CPU posible, sino lograr que el consumo de CPU sea comprensible y proporcional al trabajo útil, manteniendo al mismo tiempo un rendimiento aceptable en la edición y la colaboración.