Accueil
» ADMINISTRATEUR RÉSEAU
»
Bonnes pratiques de surveillance réseau : que surveiller et quels outils utiliser
Bonnes pratiques de surveillance réseau : que surveiller et quels outils utiliser
Une surveillance réseau efficace repose sur un inventaire vérifié, des indicateurs de performance axés sur les services et des alertes exploitables. Cartographiez les périphériques et services critiques, définissez les performances normales, puis choisissez une plateforme compatible avec votre infrastructure et facile à gérer pour votre équipe. Cela permet de détecter les problèmes naissants sans avoir à documenter chaque fluctuation.
Que doit vous indiquer la surveillance du réseau ?
La surveillance réseau permet de vérifier l'accessibilité des périphériques et des services et d'observer leurs performances dans le temps. Elle couvre généralement l'état des périphériques et des interfaces, le trafic, les ressources serveur et les contrôles de service. La journalisation de sécurité a une fonction différente : un système de gestion de réseau (NMS) explique la disponibilité et les performances, tandis que les journaux centralisés ou un SIEM facilitent l'investigation d'événements tels que les connexions suspectes et les modifications de configuration. De nombreuses équipes utilisent les deux. Le NIST définit la surveillance continue comme une veille permanente pour la prise de décisions éclairées en matière de risques ; il s'agit de revoir la couverture réseau en fonction de l'évolution de l'environnement.
meilleures pratiques de surveillance du réseau
1. Constituez un inventaire avant de configurer les alertes
Répertoriez les routeurs, commutateurs, pare-feu, équipements sans fil, serveurs critiques, liaisons cloud et services destinés aux clients. Pour chaque élément, indiquez son emplacement, son propriétaire, sa priorité métier, son adresse de gestion et ses dépendances. Utilisez la découverte automatique pour initialiser l'inventaire, puis vérifiez-le et ajoutez les appareils introuvables. Regroupez les éléments par site ou service. Mettez à jour la liste après chaque modification afin de garantir une couverture complète.
Un exemple de vue topologique relie l'état du périphérique aux dépendances en amont et en aval.
2. Surveiller les signaux qui expliquent l'impact sur l'utilisateur
Commencez par un ensemble concis de mesures liées aux services critiques :
Disponibilité : état du périphérique et de l'interface, ainsi que vérification des services essentiels tels que le DNS, les applications Web, la messagerie électronique ou l'accès VPN.
Qualité du signal : latence, perte de paquets et gigue, éléments essentiels à la transmission vocale ou vidéo en temps réel.
Trafic et capacité : utilisation des interfaces, débit, erreurs et rejets. Conservez l’historique pour distinguer un pic ponctuel d’un problème de capacité récurrent.
État de l'appareil : processeur, mémoire, température, alimentation ou état du ventilateur lorsque l'équipement fournit ces informations.
Systèmes de support : stockage serveur et état de santé des services lorsqu’une panne d’application peut être causée en dehors de la couche réseau.
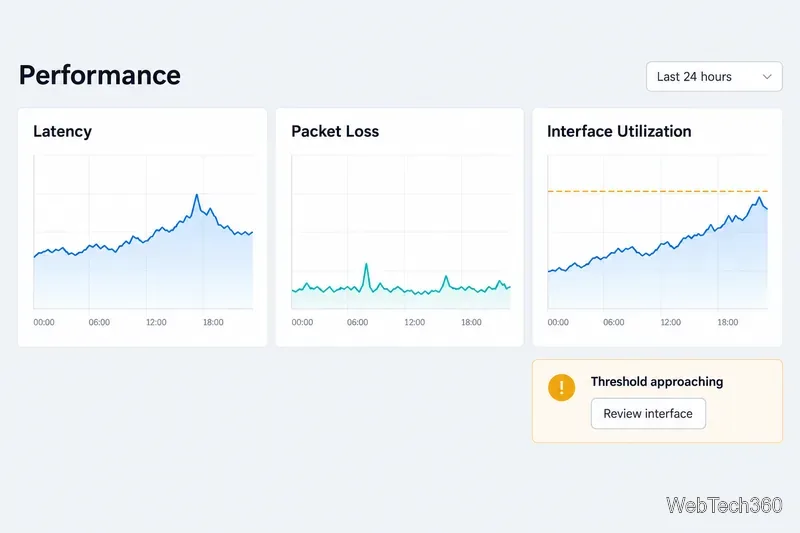
Établissez des valeurs de référence par site et par service plutôt que d'utiliser un seuil unique. Comparez le comportement actuel aux périodes de forte activité habituelles et surveillez toute pression prolongée ou tout changement soudain.
Un exemple de tableau de bord de performance permet de distinguer les variations normales des pressions soutenues sur une liaison.
3. Rendre les alertes exploitables et réduire les doublons
Générez des alertes en cas de panne, d'échec de contrôle de service ou de dépassement prolongé de seuil. Utilisez une règle de délai ou de récupération pour filtrer les anomalies transitoires. Indiquez le périphérique ou l'interface concerné(e), le service ou le site affecté(e), l'heure de première détection, les valeurs observées et attendues, ainsi qu'une procédure d'intervention. Acheminez les alertes vers un responsable et définissez la procédure d'escalade.
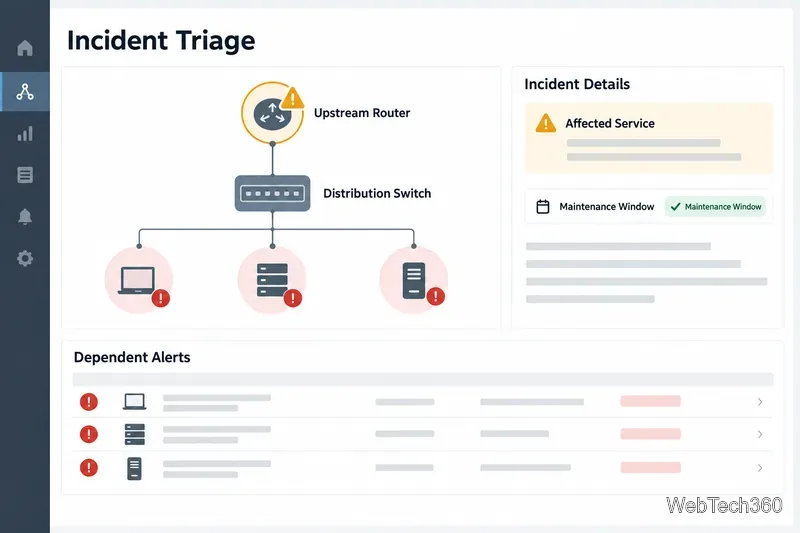
Regroupez les alertes en aval lorsqu'une défaillance en amont les explique ; planifiez des fenêtres de maintenance pour les interventions planifiées. Cela permet aux équipes d'intervention d'identifier plus rapidement les causes probables. Revoyez les règles de suppression après les modifications de topologie afin que les défaillances indépendantes restent visibles.
Un exemple de vue d'incident montre comment les alertes dépendantes peuvent orienter les intervenants vers le premier lien défaillant.
4. Protéger le système de surveillance
La surveillance des identifiants et des journaux peut révéler des informations sensibles sur l'infrastructure. Limitez le trafic d'administration, utilisez des comptes en lecture seule lorsque cela est possible, accordez un accès basé sur les rôles et sécurisez le serveur de surveillance et les sauvegardes. Privilégiez SNMPv3 lorsqu'il est disponible, avec des paramètres d'authentification et de confidentialité compatibles ; le modèle de sécurité basé sur l'utilisateur SNMPv3 définit ces services de sécurité. Suivez les recommandations de la CISA pour la protection des journaux et n'exposez jamais les interfaces d'administration directement sur Internet.
5. Couverture des tests, alertes et récupération
Vérifiez que les sondes atteignent les appareils depuis les emplacements appropriés, que les identifiants sont valides et que l'historique est conservé pour le dépannage et la planification de la capacité. Testez les alertes auprès de leurs destinataires ; documentez les responsables et les calendriers de maintenance. Examinez les appareils obsolètes, les lacunes et les règles erronées après les modifications du réseau. Conservez un plan de reprise d'activité testé pour la plateforme de surveillance.
Trois outils de surveillance réseau à évaluer
Ces produits répondent aux besoins courants. Leur adéquation dépend de votre environnement, de votre modèle de déploiement, de vos licences et des compétences disponibles. Vérifiez les offres et la compatibilité des appareils auprès de chaque fournisseur.
Outil
Là où cela peut convenir
Vérifier lors de l'évaluation
Moniteur de performances réseau SolarWinds
Environnements multi-fournisseurs nécessitant des indicateurs de performance, des cartes, des alertes, des rapports ou le dépannage des chemins d'accès aux périphériques. Le fournisseur fournit des informations sur la disponibilité, la latence, la perte de paquets, l'utilisation et l'état des périphériques.
Vérifiez la compatibilité des périphériques et des protocoles, le déploiement, la conservation et les modules nécessaires. Consultez SolarWinds NPM .
Moniteur de réseau Paessler PRTG
Les équipes surveillent les appareils, le trafic, les serveurs et les services à l'aide de cartes, de tableaux de bord et de notifications. PRTG représente les valeurs surveillées comme des capteurs.
Les organisations qui recherchent des solutions de découverte et de surveillance des performances pour leurs périphériques réseau et serveurs trouveront dans la documentation la prise en charge des protocoles SNMP, CLI et WMI.
Vérifiez l'accès aux protocoles, les modèles, les contrôles de rôle, les modules complémentaires et la gestion des sites distants. Voir OpManager .
Choisissez avec un petit pilote
Mettez en place un projet pilote sur un site représentatif, un service critique et un ensemble d'appareils. Testez la détection des utilisateurs, la précision des indicateurs, les alertes, la gestion de la maintenance, les rapports, les autorisations et la restauration. Interrogez les utilisateurs du tableau de bord sur les informations manquantes. Un court projet pilote vous permettra de déterminer si la plateforme est plus adaptée à votre réseau qu'une simple liste de fonctionnalités.