Come configurare l'archiviazione oggetti S3 per ownCloud Infinite Scale
ownCloud Infinite Scale può utilizzare l'archiviazione a oggetti compatibile con S3 per i blob di file, mantenendo al contempo i metadati dei file su un filesystem conforme a POSIX. Questa distinzione è il primo concetto da comprendere: S3 non è un sostituto diretto per ogni directory di dati locale. Nella s3ngconfigurazione supportata, l'archiviazione a oggetti contiene il contenuto binario dei file, mentre i metadati rimangono su un'archiviazione POSIX come un filesystem locale o NFS.
Questa guida si basa sulla documentazione aggiornata di ownCloud Infinite Scale Storage, disponibile a ottobre 2026. È pensata per gli amministratori che non hanno familiarità con il s3ngdriver e desiderano una configurazione comprensibile prima di adattarla a Docker Compose, systemd, Kubernetes o altri metodi di implementazione.
S3 è un'API di archiviazione a oggetti originariamente introdotta da Amazon. Un servizio compatibile con S3 archivia i dati come oggetti all'interno di un bucket ed espone le operazioni tramite API basate su HTTP. ownCloud Infinite Scale utilizza il s3ngdriver di archiviazione per inserire i blob di file in un bucket di questo tipo.
Lo storage POSIX si riferisce a un filesystem che fornisce il comportamento del filesystem previsto da Infinite Scale per i metadati. Con s3ng, i metadati non vengono spostati nel bucket S3. ownCloud documenta esplicitamente che i blob vengono spostati su S3 mentre i metadati rimangono sullo storage POSIX.
Questa distinzione previene un errore comune: puntare Infinite Scale a un bucket e presumere che l'intero stato del server risieda lì. Non è così. Il piano di backup e ripristino deve coprire sia i metadati lato POSIX che i blob lato S3.
Passaggio 1: Preparare il bucket, l'archiviazione dei metadati, le credenziali e il percorso di rete.
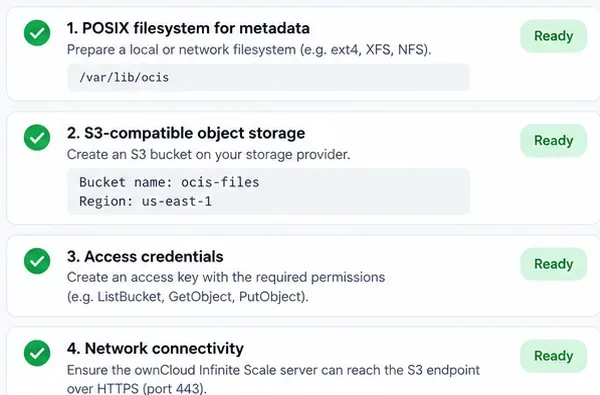
Prima di modificare Infinite Scale, prepara quattro cose:
Un bucket S3 dedicato.
Un percorso conforme a POSIX per s3ngi metadati. Per una distribuzione multi-nodo, ownCloud raccomanda di valutare attentamente lo storage condiviso; NFS viene comunemente utilizzato quando più istanze di Infinite Scale necessitano di accedere al percorso dei metadati.
Una chiave di accesso e una chiave segreta con solo le autorizzazioni del bucket richieste da Infinite Scale.
Raggiungibilità di rete dall'host o dal container di Infinite Scale all'endpoint S3, normalmente tramite HTTPS.
Prima di modificare la configurazione di Infinite Scale, preparare il percorso dei metadati POSIX, il bucket S3, le credenziali e la connettività di rete.
Non rendere pubblico il bucket. Infinite Scale si autentica al bucket tramite credenziali; l'accesso pubblico non è né necessario né auspicabile. Evita inoltre di riutilizzare credenziali di amministratore generiche quando è possibile creare un'identità di servizio dedicata.
Se si utilizza Amazon S3, l'endpoint e la regione seguono le convenzioni AWS. Se si utilizza un altro provider compatibile con S3, è necessario verificare il formato dell'endpoint, il comportamento della regione, i requisiti TLS e la sintassi delle policy nella documentazione di tale provider. ownCloud avverte specificamente che il comportamento, ad esempio i dettagli di crittografia, può variare tra i diversi provider.
Passaggio 2: Abilitare il driver s3ng e fornire le impostazioni di connessione S3
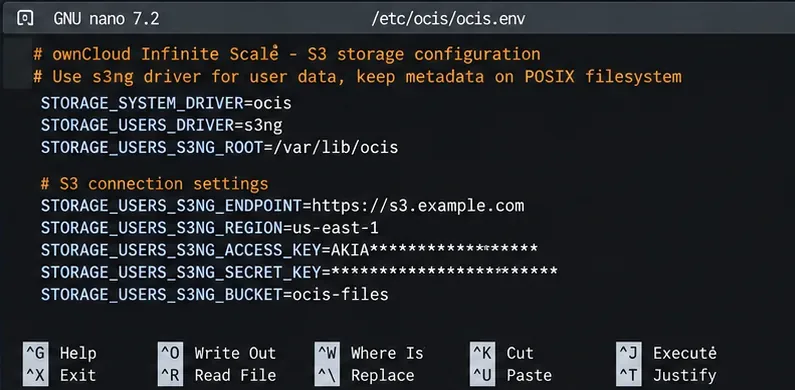
L'impostazione di archiviazione principale è STORAGE_USERS_DRIVER=s3ng. Il servizio Storage-Users è il componente di Infinite Scale responsabile dell'archiviazione dei file utente. La configurazione ufficiale mantiene anche il driver di archiviazione di sistema sul ocisbackend normale.
Un set minimo di variabili d'ambiente si presenta così:
Le variabili d'ambiente essenziali di s3ng connettono il servizio Storage-Users a S3 preservando al contempo i metadati sull'archivio POSIX.
I valori di esempio sono segnaposto. Utilizza l'endpoint, la regione, il bucket e le credenziali forniti dal tuo provider. Non caricare la chiave segreta in un repository Git pubblico. Nell'orchestrazione dei container, è preferibile utilizzare il meccanismo di gestione dei segreti della piattaforma piuttosto che incorporare le credenziali direttamente in un file Compose o nel manifest.
Il metodo di distribuzione determina la posizione di queste variabili. Una distribuzione con Docker Compose può inserirle nella environmentsezione del servizio Infinite Scale o caricarle da un file di ambiente. Una distribuzione con systemd può utilizzare un file di ambiente o la configurazione dell'unità. Kubernetes, in genere, le inietta tramite un Secret e un Deployment o uno StatefulSet. I nomi delle variabili sono la parte importante; la sintassi circostante dipende dalla piattaforma.
Passaggio 3: Concedi al bucket le autorizzazioni necessarie a Infinite Scale
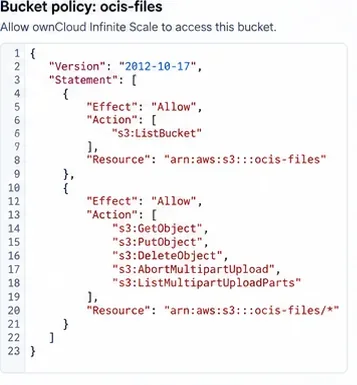
Una policy di bucket è una regola di Identity and Access Management (IAM) che controlla quali azioni un'identità autenticata può eseguire su un bucket e sui relativi oggetti. ownCloud pubblica un modello di policy obbligatorio per il s3ngdriver.
Sostituisci bucket-namenella seguente policy il nome reale del tuo bucket:
La struttura della policy deve consentire l'elenco dei bucket, nonché le operazioni di caricamento di oggetti e multipart richieste dal driver s3ng. Utilizzare la policy esatta presente nella documentazione ufficiale per la propria implementazione.
Non risolvere un errore di accesso negato concedendo s3:*i permessi a tutti i bucket dell'account. Inizia con le autorizzazioni documentate a livello di bucket, quindi adattale solo se il tuo provider S3 richiede un equivalente specifico.
Passaggio 4: riavviare Infinite Scale e verificare il percorso di archiviazione
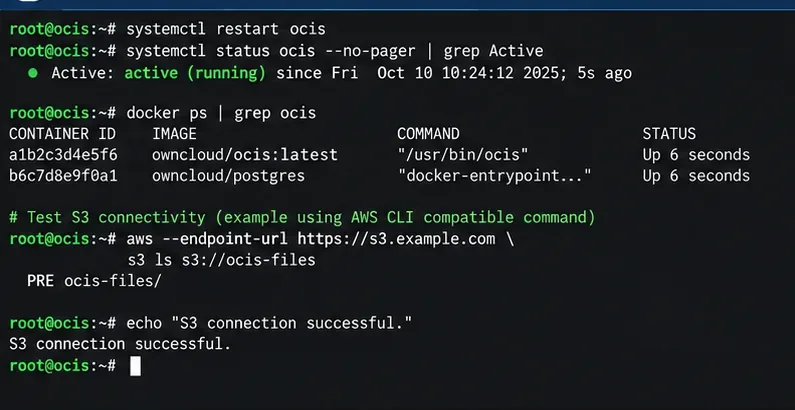
Applica la configurazione utilizzando la normale procedura di riavvio per la tua distribuzione. Ad esempio, un'installazione systemd potrebbe utilizzare systemctl restart ocis, mentre una distribuzione Compose ricreerebbe o riavvierebbe i container del servizio interessati. Controlla i log immediatamente dopo l'avvio per eventuali errori di autenticazione, DNS, TLS, regione o autorizzazioni.
Dopo aver applicato la configurazione, riavviare i servizi Infinite Scale pertinenti e verificare che l'host possa raggiungere e autenticarsi al bucket previsto.
Un elenco di bucket tramite la CLI del provider S3 dimostra che l'host e le credenziali possono raggiungere il bucket, ma di per sé non dimostra che Infinite Scale stia scrivendo correttamente i blob. Il test end-to-end migliore consiste nell'avviare Infinite Scale, caricare un piccolo file tramite l'interfaccia web di ownCloud, scaricarlo nuovamente e analizzare i log del servizio per individuare eventuali errori.
Se la versione di Infinite Scale installata include il comando di manutenzione del blobstore documentato da ownCloud, è possibile utilizzarlo anche in questo caso ocis storage-users blobstore check. ownCloud descrive questo comando come un'operazione di caricamento/download/eliminazione bidirezionale sul blobstore configurato. Consultare la documentazione ufficiale di verifica del blobstore per la sintassi specifica della versione.
Non aspettarti che i nomi dei file originali appaiano come normali oggetti S3
Uno degli errori più comuni è quello di esplorare il bucket e aspettarsi una struttura ad albero di cartelle utente familiare, come ad esempio Documents/report.pdf. Infinite Scale tratta S3 come un archivio di blob, non come un filesystem accessibile all'utente. Il s3ngformato della chiave documentato si basa sugli ID degli spazi e sugli ID dei blob, mentre lo spazio dei nomi leggibile dall'uomo viene ricostruito a partire dai metadati.
Ciò significa che non dovresti rinominare, riorganizzare o eliminare manualmente gli oggetti all'interno del bucket solo perché le loro chiavi sembrano sconosciute. Gestisci i file utente tramite ownCloud. La manipolazione diretta del bucket può interrompere la relazione tra metadati e blob.
Caricamento di grandi dimensioni: verificare le dimensioni della parte multiparte prima della produzione
S3 utilizza il caricamento multipart per suddividere gli oggetti di grandi dimensioni in parti. La documentazione di ownCloud STORAGE_USERS_S3NG_PUT_OBJECT_PART_SIZEdefinisce le modalità di controllo delle dimensioni delle parti. Il valore predefinito documentato è di 16 MiB quando non viene specificato alcun valore esplicito.
Amazon S3 consente un massimo di 10.000 parti in un singolo caricamento multipart. Con una dimensione di parte di 16 MiB, ciò corrisponde a circa 160 GiB prima che il limite di parti diventi un problema. Se i tuoi utenti caricano regolarmente file di grandi dimensioni, calcola la dimensione di parte necessaria prima della messa in produzione, anziché aspettare che un trasferimento di grandi dimensioni fallisca.
Il compromesso è semplice: parti più grandi supportano file massimi più grandi con un minor numero di richieste, ma modificano anche le caratteristiche di memoria, buffering, tentativi e trasferimento. ownCloud osserva inoltre che i dati dei file in arrivo necessitano di archiviazione temporanea durante il buffering, quindi la pianificazione della capacità deve includere più del solo bucket remoto.
Problemi comuni e cosa controllare per prima cosa
Sintomo
area probabile
Prima verifica
Accesso negato
Credenziali o politica del secchio
Conferma la chiave di accesso, la chiave segreta, l'ARN del bucket e le azioni richieste.
Cesto non trovato
Nome del bucket, endpoint o regione
Verificare il nome esatto del bucket e la combinazione endpoint/regione specifica del provider.
Errore TLS o del certificato
Affidabilità HTTPS
Verificare che il certificato dell'endpoint sia valido e considerato attendibile all'interno dell'host/container di Infinite Scale.
I file di piccole dimensioni funzionano, ma i file di grandi dimensioni non funzionano.
Dimensionamento multiparte
Verifica STORAGE_USERS_S3NG_PUT_OBJECT_PART_SIZEi limiti previsti per le spedizioni multiparte dal tuo fornitore.
I file scompaiono dopo il ripristino del solo S3
Backup incompleto
Ripristina i metadati POSIX e i blob S3 come un unico set di dati coerente.
Eseguire il backup simultaneo di blob S3 e metadati POSIX.
Con s3ng, il bucket rappresenta solo metà dello stato di archiviazione. La documentazione di backup di ownCloud afferma che una configurazione S3 distribuita deve includere configurazione, dati di sistema, metadati e blob. Allo stesso modo, la documentazione di ripristino richiede che questi set di dati vengano ripristinati in modo coerente.
Per un servizio di produzione, documentare il montaggio dei metadati, il bucket, le credenziali o il ruolo, i file di configurazione e la procedura di backup nello stesso runbook. Testare il ripristino prima di fare affidamento sulla progettazione. I riferimenti ufficiali pertinenti sono la guida al backup di ownCloud e le considerazioni sul ripristino .
Punto di partenza consigliato
Per una prima implementazione, mantieni la configurazione semplice: utilizza un bucket S3 dedicato per i blob, un percorso persistente per i metadati POSIX, un'identità di servizio dedicata con le autorizzazioni del bucket documentate, HTTPS per l'endpoint di object storage e le impostazioni multipart predefinite, a meno che le dimensioni previste dei file non richiedano una modifica.
Dopo la configurazione, convalida separatamente i tre livelli: accesso di rete e credenziali al bucket, avvio di Infinite Scale senza errori di archiviazione e un effettivo caricamento/download tramite ownCloud. Una volta superati questi controlli, passa al monitoraggio, ai backup, alle regole del ciclo di vita e all'ottimizzazione delle prestazioni. Questa sequenza semplifica notevolmente la risoluzione dei problemi, poiché ogni test risponde a una domanda diversa anziché considerare "S3 funziona" come un singolo risultato binario.