Come monitorare le metriche di Jitsi Videobridge con Prometheus e Grafana
Quando una riunione Jitsi inizia a presentare problemi, un amministratore potrebbe ricevere segnalazioni di audio intermittente o video bloccato, ma non avere un modo rapido per capire se il bridge è sovraccarico, irraggiungibile o semplicemente sta gestendo un traffico superiore al normale. Jitsi Videobridge (JVB) espone metriche operative che Prometheus può raccogliere e Grafana può visualizzare. Questa guida illustra una configurazione pratica, partendo da un controllo dell'endpoint locale e terminando con una dashboard verificabile.
Esempio: Immaginate una piccola organizzazione che esegue un'istanza di JVB su un host Linux e Prometheus e Grafana sullo stesso host. Questo è un esempio illustrativo, non la descrizione di un'implementazione o di un test reale. Se i vostri servizi vengono eseguiti in container separati o su server diversi, sostituite gli indirizzi interni raggiungibili e mantenete le stesse restrizioni di rete.
Cosa monitorerai
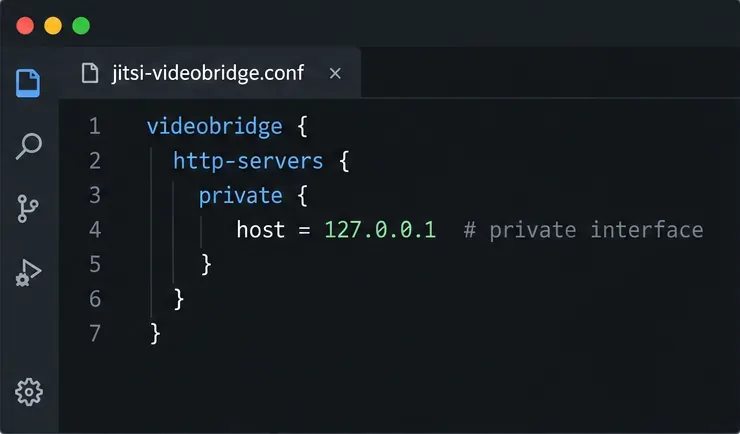
La documentazione attuale del progetto JVB descrive un endpoint Prometheus/OpenMetrics integrato /metricssull'interfaccia HTTP privata del bridge. Elenca statistiche come conferenze attive, endpoint, bitrate in entrata e in uscita, velocità dei pacchetti e stress del bridge. L'esposizione di Prometheus non contiene necessariamente tutte le statistiche disponibili tramite gli altri formati di reporting di JVB, quindi è consigliabile considerare l'endpoint fornito dalla versione installata come fonte di riferimento. La configurazione di riferimento attualmente abilita la risorsa REST di Prometheus e associa l'interfaccia HTTP privata all'interfaccia di loopback; la porta HTTP privata predefinita documentata è la 8080. Pacchetti e modelli di distribuzione precedenti potrebbero differire.
Passaggio 1: Verificare che JVB fornisca le metriche
Sulla macchina JVB, identificare innanzitutto la configurazione attiva. Un pacchetto comune di Debian o Ubuntu utilizza /etc/jitsi/videobridge/jvb.conf, ma Jitsi fa notare che il file effettivo è quello che viene passato al processo bridge. Le distribuzioni in container potrebbero invece montare una configurazione generata. Non dare per scontato che un file di esempio sia quello letto dal servizio in esecuzione.
Esempio: l'interfaccia HTTP privata JVB è associata all'interfaccia di loopback, quindi solo i processi locali possono raggiungerla.
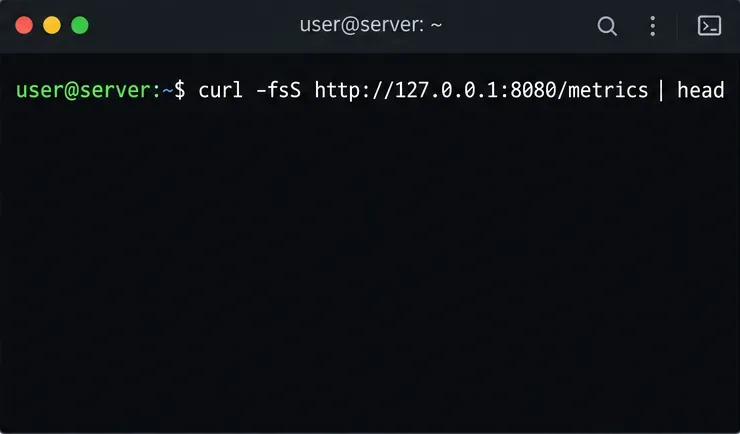
Utilizzando la porta e il binding di loopback predefiniti dell'esempio, eseguire questo comando sull'host JVB:
curl -fsS http://127.0.0.1:8080/metrics | head
Verifica l' /metricsendpoint locale prima di configurare Prometheus.
Una risposta positiva è un testo semplice contenente famiglie di metriche Prometheus, spesso con righe # HELPe # TYPEseguite da esempi. L'illustrazione mostra solo il comando; non è una prova di una risposta del server in tempo reale. Un rifiuto della connessione in genere significa che JVB è arrestato, in ascolto su un altro indirizzo o porta, oppure che la configurazione installata disabilita quel listener HTTP. Un errore HTTP 404 suggerisce che il server ha risposto, ma il percorso non è disponibile in quella build o configurazione API. Controlla i log di JVB e la configurazione della versione installata, invece di abilitare l'API di controllo Colibri non correlata solo per far funzionare il percorso Prometheus.
È possibile esaminare i nomi e i tipi delle metriche direttamente con:
JVB documenta che le metriche disponibili in Prometheus non rispecchiano fedelmente le statistiche in formato JSON. Documenta inoltre che gli istogrammi relativi alle dimensioni delle conferenze sono disponibili solo in formato Prometheus. Prima di scrivere query PromQL o importare dashboard che utilizzano nomi specifici, verificate quali metriche vengono effettivamente restituite dalla versione installata.
Quando Prometheus è in esecuzione sullo stesso host di JVB, lascia l'interfaccia privata attiva 127.0.0.1. Questo evita di aprire un altro listener sulla tua rete. Nell'ipotetica configurazione sullo stesso host, il target 127.0.0.1:8080può essere raggiunto direttamente da Prometheus.
Se Prometheus è in esecuzione altrove, il binding di loopback predefinito di JVB non accetterà connessioni da esso. È possibile configurare il listener privato in modo che si colleghi a un'interfaccia interna raggiungibile da Prometheus, quindi limitare il firewall o la rete del container in modo che solo l'host di Prometheus possa connettersi alla porta privata. Non esporre le porte 8080 o 8443 a Internet pubblico: Jitsi descrive esplicitamente questa interfaccia come privata e afferma che i suoi endpoint non sono destinati all'accesso pubblico. Se l'ambiente richiede la crittografia in transito, l'interfaccia privata supporta TLS se configurata con un keystore; in alternativa, utilizzare un proxy TLS interno strettamente controllato. Evitare di copiare un binding pubblico generico senza 0.0.0.0una restrizione di accesso associata.
Dopo aver modificato un'impostazione del listener, utilizzare il meccanismo di configurazione supportato dalla propria distribuzione e riavviare o ricaricare JVB solo se richiesto da tale versione. Un riavvio può interrompere le chiamate in una distribuzione a singolo bridge, quindi pianificarlo di conseguenza. In Docker, modificare la configurazione persistente lato host o l'ambiente utilizzato per generarla, non un file container temporaneo. Verificare il listener dalla macchina Prometheus curlprima di continuare.
Passaggio 3: Aggiungere un'attività di scraping di Prometheus
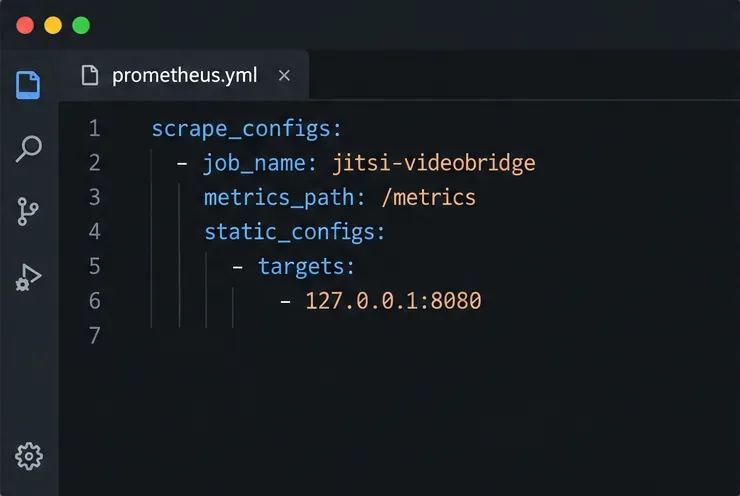
Aggiungi un job di scraping al file di configurazione di Prometheus. Per l'esempio same-host, la sezione pertinente è:
La destinazione dello scraping deve essere raggiungibile dal processo Prometheus; sostituire l'indirizzo di loopback con l'indirizzo privato quando i servizi si trovano su host separati.
La configurazione di Prometheus utilizza scrape_configse supporta target statici per implementazioni di piccole dimensioni e a dimensione fissa. Se JVB si trova in un container diverso, 127.0.0.1punta al container di Prometheus stesso; in alternativa, utilizza il nome del servizio e la porta di JVB su una rete Docker privata condivisa. Per un host remoto, utilizza il suo nome DNS privato o indirizzo e mantieni restrittiva la regola del firewall. La documentazione di riferimento sulla configurazione di Prometheus illustra i job di scraping, i target e le impostazioni degli intervalli.
Prima di applicare una modifica, convalida l'intero file con l'utility Prometheus inclusa nell'installazione:
Se la convalida ha esito positivo, ricarica Prometheus utilizzando il metodo configurato per il tuo servizio oppure riavvialo se il ricaricamento non è abilitato. Non dedurre il successo dalla sola presenza di un file YAML valido; un target sintatticamente valido potrebbe comunque risultare irraggiungibile.
Passaggio 4: Collegare Grafana a Prometheus
In Grafana, aggiungi l'origine dati Prometheus integrata e inserisci l'URL raggiungibile da Grafana stesso. Su un singolo host, questo URL potrebbe essere http://localhost:9090quello indicato se Grafana è in esecuzione direttamente su tale host. Quando Grafana è in esecuzione in un container, localhostsi intende il container di Grafana, non l'host o il container di Prometheus; in una rete condivisa, utilizza il nome del servizio Prometheus. Salva e testa l'origine dati. La guida di Grafana per l'origine dati Prometheus descrive le impostazioni di connessione, mentre la documentazione relativa all'origine dati spiega come Grafana interroga un backend di metriche.
Apri Esplora, seleziona Prometheus ed esegui il comando up{job="jitsi-videobridge"}. Si tratta di un controllo dello stato di integrità dello scraping di Prometheus, non di una metrica di Jitsi. Un valore pari a 1 indica che Prometheus ha eseguito correttamente lo scraping del target per la valutazione corrente; 0 indica che un target configurato non funziona correttamente. Se la query non restituisce alcuna serie, verifica il nome esatto del job, il ricaricamento della configurazione, il rilevamento del target e l'intervallo di tempo selezionato.
Utilizza la upserie generica di Prometheus per verificare lo stato di salute dello scraping prima di interrogare le metriche specifiche di JVB.
Passaggio 5: Creare una dashboard utile e verificare i dati
Una volta upverificato il corretto funzionamento, utilizza il browser delle metriche di Grafana Explore o il browser delle espressioni di Prometheus per trovare le serie JVB esposte dalla tua release. Inizia con una serie di domande operative:
Quante conferenze e endpoint sono attivi e come cambiano questi conteggi nel corso della giornata?
Le serie di bitrate o di velocità dei pacchetti RTP in entrata e in uscita cambiano all'aumentare del carico della riunione?
La serie di sollecitazioni del ponte aumenta con il numero di punti di ancoraggio, oppure è già elevata a un carico moderato?
Sono disponibili metriche relative ai thread della JVM e alla garbage collection? E cambiano in base ai report sulle chiamate lente?
Utilizza i nomi e le unità delle metriche stampati dal tuo /metricsendpoint. La documentazione di Jitsi sulle statistiche descrive esempi come conferences, endpoints, bit_rate_download, bit_rate_upload, e stress_levelnel suo elenco di statistiche supportate, ma avverte che non tutte le statistiche sono attualmente esposte nel formato Prometheus. Non incollare questi nomi in una query finché non hai confermato che la famiglia Prometheus esiste nella tua build. Per i contatori cumulativi, usa funzioni PromQL come rate()su un intervallo; per indicatori istantanei come il conteggio corrente delle conferenze, rappresenta graficamente direttamente il valore campionato. Mantieni le unità documentate quando etichetti i pannelli, poiché i campi bitrate e velocità dei pacchetti utilizzano unità diverse.
Crea una dashboard con alcuni pannelli di serie temporali, unità chiare e un intervallo di tempo che includa le acquisizioni più recenti. Evita di trattare una serie mancante come zero: l'assenza di dati può indicare un errore di ortografia, una metrica non supportata o un errore di acquisizione. Per gli avvisi, inizia con la disponibilità target e aggiungi le soglie solo dopo aver osservato un traffico normale per la tua implementazione. Un valore universale di "stress elevato" può essere fuorviante perché la capacità dipende dall'host, dal mix di media e dalla configurazione.
Verifica la configurazione completata
Esegui questa sequenza dalla più semplice alla più specifica:
Sul server host JVB, richiedere http://127.0.0.1:8080/metricse confermare che la risposta contenga il testo metrico.
Dall'host o dal container Prometheus, richiedete lo stesso endpoint utilizzando l'indirizzo privato configurato. Un successo locale non dimostra la raggiungibilità remota.
Nella vista Obiettivi di Prometheus, verifica che l' jitsi-videobridgeobiettivo sia attivo e, se non lo è, controlla l'ultimo errore di scraping.
In Grafana Explore, conferma up{job="jitsi-videobridge"}che il risultato sia 1, quindi interroga un nome di metrica JVB copiato dall'endpoint live.
Apri una dashboard relativa a un intervallo di tempo che includa diversi intervalli di acquisizione dati e verifica che unità di misura, etichette e timestamp siano corretti.
Se l'endpoint funziona localmente ma Prometheus segnala un errore di connessione, ricontrollare l'indirizzo di binding, la porta, il firewall e la rete del container. Se il target è attivo ma le query JVB sono vuote, verificare il nome esportato esatto, l'intervallo di tempo selezionato e se tale statistica è presente nell'output di Prometheus. Se le dashboard mostrano dati ma la qualità della riunione continua a essere compromessa, le metriche aiutano a restringere l'indagine; tuttavia, da sole non identificano il problema della rete Wi-Fi locale, del browser o della rete dell'ultimo miglio di un partecipante.
Questa configurazione segue la documentazione ufficiale di Jitsi, Prometheus e Grafana, aggiornata al 6 ottobre 2026. Poiché la configurazione di riferimento di Jitsi e le schermate di Grafana sono soggette a evoluzione, confronta gli esempi con la documentazione e i file relativi alle versioni esatte che utilizzi.