Home
» AMMINISTRAZIONE DI RETE
»
Come risolvere l'errore "Memoria insufficiente in Matrix Synapse durante la sincronizzazione"
Come risolvere l'errore "Memoria insufficiente in Matrix Synapse durante la sincronizzazione"
Al 6 ottobre 2026, l'ultima versione stabile di Matrix Synapse è la 1.162.0, pubblicata il 29 settembre 2026. Se il vostro homeserver esaurisce la memoria durante la sincronizzazione dei client, un primo tentativo sensato è quello di aggiornare a una versione supportata più recente, ma la soluzione definitiva di solito è di natura operativa piuttosto che una singola impostazione magica. Synapse mantiene intenzionalmente in memoria i dati e i metadati delle stanze più recenti per velocizzare le richieste più comuni, e la documentazione ufficiale per gli amministratori avverte che ridurre la cache in modo troppo aggressivo può in realtà peggiorare la pressione sulla memoria creando un accumulo di richieste lente.
Questa guida illustra il percorso che un nuovo amministratore può seguire in sicurezza: comprendere cosa significa "sincronizzazione", verificare che il processo stia effettivamente raggiungendo un limite di memoria, ridurre la pressione evitabile sulla cache, separare il traffico di sincronizzazione iniziale insolitamente intenso quando necessario e monitorare il risultato. L'obiettivo non è semplicemente ridurre le dimensioni del set residente, bensì evitare arresti anomali dovuti a memoria insufficiente, mantenendo al contempo il server domestico reattivo.
Cosa significa “sincronizzazione” in Matrix Synapse
Un client Matrix chiama ripetutamente l'API Client-Server /_matrix/client/v3/syncper ricevere nuovi eventi come messaggi, stato della stanza, dati dell'account, informazioni sulla presenza e aggiornamenti del dispositivo. Una normale sincronizzazione continua di solito include un sincetoken, quindi Synapse deve restituire solo le modifiche successive al punto di sincronizzazione precedente.
La sincronizzazione iniziale è diversa. Si tratta della prima sincronizzazione per un dispositivo o una sessione e non ha un sincetoken precedente. La documentazione ufficiale di Synapse descrive queste richieste come potenzialmente molto dispendiose in termini di risorse. Sui server domestici più grandi, Synapse supporta l'instradamento della sincronizzazione iniziale separatamente dalla sincronizzazione continua, in modo che alcune sincronizzazioni iniziali dispendiose non interferiscano con tutti gli altri.
Annota la versione di Synapse e il metodo di installazione.
Esegui il backup homeserver.yamldei file di configurazione del worker, della configurazione del reverse proxy e del database PostgreSQL secondo la tua normale procedura di backup.
Indica se Synapse viene eseguito come un singolo processo, in container o come un processo principale più processi worker.
Verifica il limite di memoria effettivo. Un container, un'unità systemd, un pod Kubernetes o una macchina virtuale potrebbero avere un limite inferiore rispetto al server fisico.
Confermate che PostgreSQL sia in uso per l'ambiente di produzione. La documentazione di installazione di Synapse attualmente disponibile afferma che SQLite è destinato ai test e offre prestazioni scadenti per i carichi di lavoro di produzione, soprattutto in ambienti con grandi dimensioni.
Passaggio 1: Confermare che l'esaurimento della memoria sia il vero problema.
Non iniziare modificando i valori della cache. Prima di tutto, identifica quale processo Synapse sta consumando memoria e se viene terminato dal sistema operativo o da un limite del container.
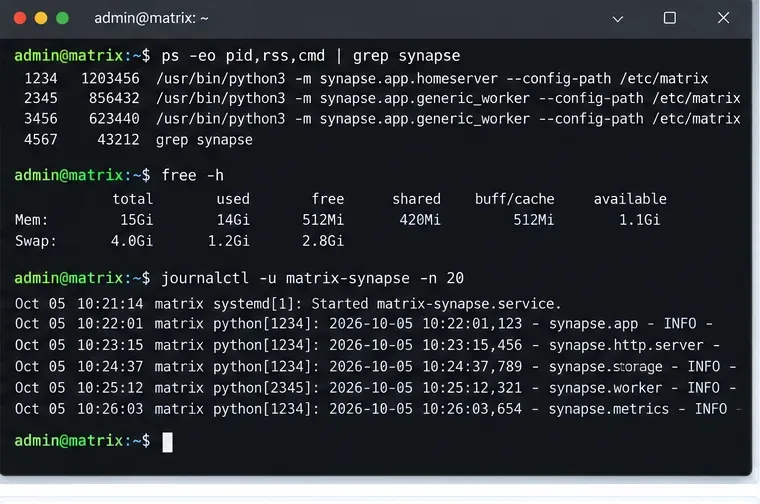
Inizia controllando i dati RSS dei processi, la memoria disponibile, la pressione di swap e i log recenti del servizio Synapse, in modo da capire se il problema è effettivamente dovuto all'esaurimento della memoria o a un altro tipo di errore di sincronizzazione.
Su un host Linux, comandi come i seguenti forniscono una prima rapida panoramica:
Se utilizzi Docker, Podman, Kubernetes o un altro scheduler, verifica anche il limite di memoria del container o del pod. Un host con diversi gigabyte liberi può comunque arrestare Synapse se il processo è limitato a un limite cgroup molto inferiore.
Cerca uno schema ripetibile. L'utilizzo della memoria aumenta solo quando un utente specifico effettua l'accesso da un nuovo dispositivo? Aumenta gradualmente durante tutta la giornata? Un processo di lavoro generico cresce mentre il processo principale rimane stabile? Queste osservazioni permettono di distinguere un picco di sincronizzazione iniziale da una crescita generale della cache o da un accumulo di richieste.
Passaggio 2: Verifica le impostazioni della cache prima di ridurle
Una cache è un insieme di dati che Synapse conserva nella RAM in modo da non dover ricalcolare o ricaricare ripetutamente le stesse informazioni. Synapse dispone di diverse cache, oltre a una cache degli eventi. La documentazione di configurazione attualmente riporta un valore predefinito caches.global_factordi 0,5, un event_cache_sizevalore predefinito di 10.000 prima dell'applicazione del fattore globale, una scadenza della cache basata sul tempo e un sync_response_cache_durationvalore predefinito di 2 minuti.
La soluzione più allettante è impostare il fattore globale al valore più basso possibile. Non fatelo ciecamente. Le FAQ per gli amministratori di Synapse avvertono esplicitamente che una cache troppo piccola può rallentare ulteriormente un sistema già lento, causando l'accumulo di richieste e un'esplosione dell'utilizzo della memoria dovuta al backlog anziché alle voci della cache.
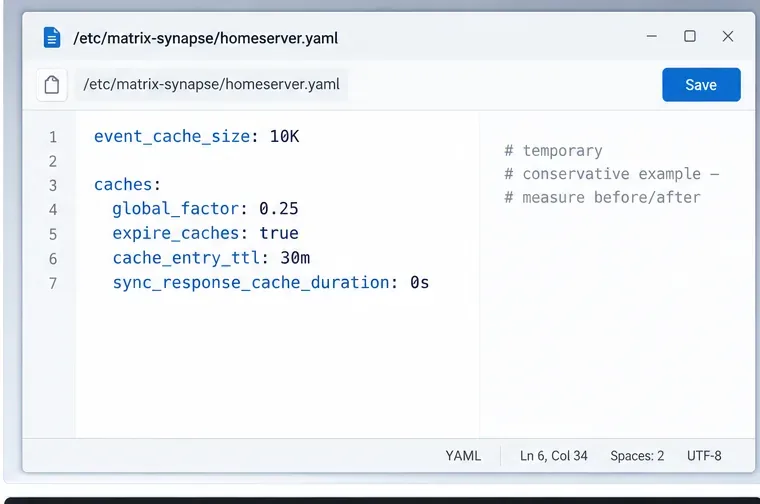
Apporta modifiche alla cache con cautela e misura il risultato; l'esempio illustra dove si trovano le impostazioni rilevanti, piuttosto che un valore di produzione universale.
Se la profilazione mostra che la memoria cache è effettivamente il principale consumatore e il throughput delle richieste rimane elevato, prova una riduzione moderata anziché una drastica. Ad esempio:
Questo è un esempio di risoluzione dei problemi, non un valore consigliato per ogni server. Impostando il valore sync_response_cache_durationa zero si disabilita la memorizzazione nella cache delle /syncrisposte completate. Ciò può consentire di risparmiare memoria quando vengono conservate molte risposte di sincronizzazione, ma potrebbe comportare un maggiore carico di lavoro per i client che si riconnettono. Si consiglia di testarlo con il proprio carico di lavoro effettivo.
Synapse offre anche l'ottimizzazione automatica della cache con max_cache_memory_usage, target_cache_memory_usage, e min_cache_ttl. La documentazione ufficiale afferma che questa funzionalità richiede jemalloc , un allocatore di memoria alternativo, e che tutte e tre le impostazioni devono essere fornite. Non abilitare solo uno o due valori; la documentazione avverte che una configurazione incompleta può causare un comportamento instabile.
Passaggio 3: Assicurarsi che il database non stia creando un accumulo di richieste.
I problemi di memoria durante la sincronizzazione non sono sempre causati dalla quantità di dati memorizzati nella cache. Un database lento può mantenere attive molte richieste contemporaneamente, e ogni richiesta in corso consuma memoria. Per questo motivo, ridurre le dimensioni della cache può rivelarsi controproducente su un sistema di archiviazione già lento.
Per l'ambiente di produzione, segui la guida ufficiale di Synapse PostgreSQL . Verifica l'utilizzo della CPU del database, la latenza di archiviazione, la saturazione delle connessioni, le query a lunga esecuzione e se il server PostgreSQL stesso sta utilizzando lo swap. Se la latenza di sincronizzazione aumenta contemporaneamente all'utilizzo della memoria residente, analizza il backlog prima di ridurre nuovamente le cache.
Se di recente vi siete trasferiti in sale riunioni più grandi, vi siete federati in comunità molto più ampie o avete aggiunto molti utenti attivi, il carico di lavoro potrebbe semplicemente aver superato le capacità di una configurazione precedente. In tal caso, l'ottimizzazione del database e l'isolamento dei worker sono spesso più importanti di una piccola riduzione della cache.
Passaggio 4: isolare la sincronizzazione iniziale sui server domestici più grandi
Synapse può essere eseguito come un singolo monolite , ovvero un unico processo principale del server domestico, oppure può suddividere il lavoro in worker , che sono processi Synapse aggiuntivi che condividono lo stesso database PostgreSQL. Il modello worker è pensato per installazioni più grandi che necessitano di scalare i singoli carichi di lavoro in modo indipendente.
Nelle implementazioni di grandi dimensioni basate su PostgreSQL, è consigliabile instradare la costosa sincronizzazione iniziale separatamente dalla sincronizzazione continua, in modo che il primo accesso non consumi lo stesso pool di risorse di lavoro degli aggiornamenti normali del client.
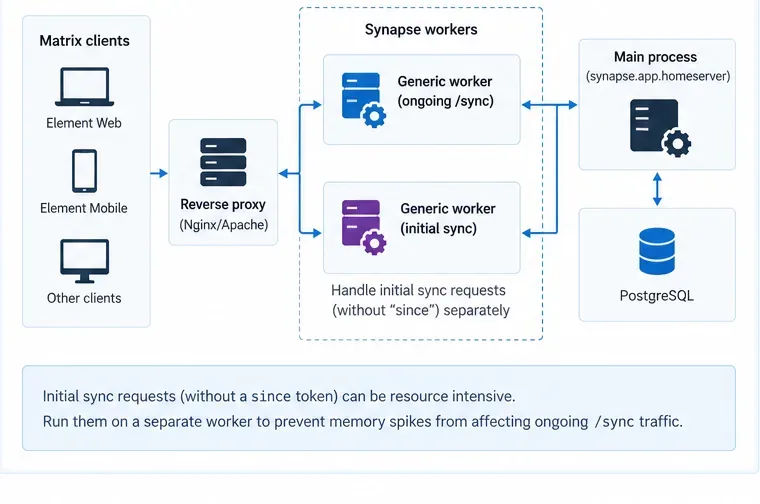
La documentazione del worker afferma che un worker generico può gestire /synce /initialSync. Raccomanda inoltre di considerare una gestione separata per le richieste di sincronizzazione senza un sinceparametro perché queste richieste di sincronizzazione iniziale possono essere molto dispendiose in termini di risorse.
Un'architettura pratica è:
Il proxy inverso riceve il traffico del client Matrix.
Le richieste in corso /syncvengono indirizzate a uno o più worker generici.
Le richieste di sincronizzazione iniziali vengono inviate a un gruppo di lavoratori generici separato.
Il processo principale continua a gestire le responsabilità non delegate.
Tutti i processi Synapse condividono PostgreSQL.
Non esporre il listener di replica di Synapse a Internet pubblico. La documentazione attuale del worker avverte che il traffico di replica non è crittografato né autenticato a meno che non venga configurato un segreto di replica.
L'utilizzo di worker non è la soluzione ideale per un piccolo server domestico. Le linee guida di Synapse raccomandano la modalità monolitica per le istanze di dimensioni ridotte. Aggiungete i worker solo quando avete la certezza che un particolare carico di lavoro necessiti di isolamento o di scalabilità orizzontale.
Passaggio 5: Ricaricare i fattori della cache in modo sicuro e osservare il risultato
Synapse consente di ricaricare i fattori della cache con SIGHUP. Il riferimento di configurazione fornisce questo esempio:
kill -HUP PID_OF_SYNAPSE_PROCESS
Se il servizio systemd incluso lo supporta, systemctl reload matrix-synapseè possibile eseguire la stessa operazione. In una distribuzione worker, la documentazione ufficiale afferma che la configurazione del worker pertinente deve essere aggiornata e che ogni worker deve ricevere il segnale di ricaricamento individualmente.
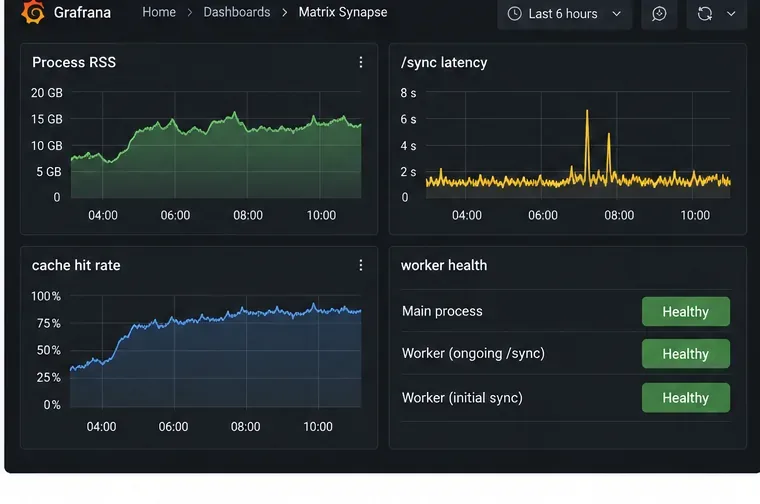
Dopo ogni modifica, concedete al server il tempo necessario per raggiungere un normale flusso di traffico. Monitorate contemporaneamente la memoria residente, la latenza delle richieste, il carico del database e lo stato di salute dei processi attivi. Un grafico della memoria che diminuisce mentre la latenza di sincronizzazione raddoppia non è indice di una soluzione efficace.
Passaggio 6: Abilitare le metriche di Prometheus per una diagnosi ripetibile
Per qualsiasi evento che vada oltre un singolo incidente, attiva le metriche di Synapse e raccoglile con Prometheus. La guida ufficiale al monitoraggio documenta la enable_metrics: trueconfigurazione di un listener interno dedicato per le metriche. Mantieni l'endpoint delle metriche su un'interfaccia interna o proteggilo tramite il reverse proxy; non deve essere esposto inutilmente.
Monitorare contemporaneamente la memoria e la latenza di sincronizzazione. Il risultato utile è una memoria stabile con un tempo di risposta accettabile, non il valore RSS più basso possibile.
Per la sintassi corrente del listener, consultare la guida ufficiale al monitoraggio di Synapse Prometheus . Nelle implementazioni worker, monitorare ogni worker separatamente poiché le metriche dei worker non vengono aggregate automaticamente nel processo principale.
Errori comuni da evitare
Abbassare SYNAPSE_CACHE_FACTOR fino a quando il server non diventa più lento
Una cache più piccola utilizza meno memoria per ogni voce, ma aumenta il carico di lavoro del database e i calcoli. Se questo carico aggiuntivo crea una coda di richieste in sospeso, la memoria totale può aumentare anziché diminuire. Riduci gradualmente questo fattore e monitora sempre la latenza.
Supponendo che ogni richiesta /sync costi lo stesso
Una sincronizzazione in corso con un sincetoken e una sincronizzazione iniziale senza token hanno profili di risorse molto diversi. Separale nella diagnosi prima di scalare l'intero server.
Utilizzo dei worker mentre si è ancora su SQLite
I worker di Synapse condividono un database PostgreSQL. La documentazione dei worker afferma che SQLite è destinato a scopi dimostrativi o di test e non costituisce la base per una distribuzione in produzione basata su worker.
Utilizzo dello scambio come soluzione principale
Una piccola quantità di swap può prevenire l'interruzione improvvisa di un processo, ma un utilizzo eccessivo dello swap rallenta drasticamente la sincronizzazione e può creare lo stesso circolo vizioso di accumulo di dati. Considerate lo swap come una protezione contro picchi di utilizzo di breve durata, non come uno strumento di pianificazione della capacità.
Modificare contemporaneamente diverse impostazioni di memoria
Se si riducono contemporaneamente le cache, si modifica il routing dei worker, si alterano le impostazioni di PostgreSQL e si aumenta il limite dei container, non si saprà quale modifica ha risolto il problema. È consigliabile apportare una modifica controllata alla volta e confrontare le stesse metriche.
Un percorso decisionale pratico
Ciò che osservi
Probabile prossima azione
Picchi di memoria quando gli utenti accedono da nuovi dispositivi
Identifica la sincronizzazione iniziale e valuta la possibilità di isolarla su un worker per implementazioni su larga scala.
La memoria aumenta costantemente mentre il tasso di successo della cache è elevato e la latenza è normale.
Riduci gradualmente la capacità della cache ed esegui nuovamente il test.
La latenza di memoria e di sincronizzazione aumenta contemporaneamente
Prima di ridurre ulteriormente le dimensioni delle cache, è necessario esaminare eventuali problemi relativi al database o allo spazio di archiviazione.
Solo un lavoratore raggiunge il suo limite
Regola il budget di memoria di quel worker oppure ridimensiona quel gruppo di worker anziché l'intero homeserver.
L'host ha RAM libera ma Synapse è terminato
Verifica i limiti di memoria del container, del cgroup, di systemd o di Kubernetes.
Lista di controllo finale
Utilizzare una versione di Synapse attualmente supportata; la versione 1.162.0 è l'ultima versione stabile disponibile al 6 ottobre 2026.
Per l'ambiente di produzione, utilizzare PostgreSQL.
Verifica quale processo sta effettivamente consumando i dati RSS e quale limite di memoria gli viene applicato.
Distinguere la sincronizzazione incrementale normale dalla sincronizzazione iniziale.
Mantieni attiva la scadenza della cache e regola gradualmente i fattori di cache.
Non abilitare l'ottimizzazione automatica della cache a meno che non si utilizzi jemalloc e tutti i valori richiesti non siano configurati.
Per implementazioni di grandi dimensioni, isolare la sincronizzazione iniziale o aggiungere worker di sincronizzazione generici quando le misurazioni lo giustificano.
Monitora contemporaneamente la memoria e la latenza dopo ogni modifica.
Synapse è volutamente esigente in termini di memoria perché la memorizzazione nella cache fa parte della sua strategia di ottimizzazione delle prestazioni. La soluzione corretta per gli errori di memoria insufficiente (OOM) legati alla sincronizzazione è quindi un equilibrio: rimuovere la memorizzazione non necessaria nella cache, eliminare il backlog del database o delle richieste e isolare i carichi di lavoro eccezionali senza sovraccaricare le cache che mantengono veloce la sincronizzazione normale. Questo approccio è più affidabile rispetto a considerare il valore RSS più alto come il problema in sé.