Un homeserver Matrix Synapse può sembrare in perfette condizioni per giorni e poi improvvisamente lasciare PostgreSQL a consumare la maggior parte della RAM disponibile. I sintomi tipici sono ben noti: lo swap inizia a crescere, le sincronizzazioni dei client rallentano, i processi di federazione si accumulano e un server altrimenti modesto diventa difficile da amministrare. Il primo passo importante è non presumere che PostgreSQL abbia una perdita di memoria. Un elevato utilizzo della memoria può derivare da diverse fonti indipendenti, tra cui la cache del buffer condiviso, la memoria di lavoro per query, molti backend di database, i processi di manutenzione e query inefficienti causate da statistiche obsolete o da frequenti modifiche alle tabelle.
La documentazione di Synapse raccomanda PostgreSQL per gli ambienti di produzione ed espone controlli per il pool di connessioni al database, come cp_mine cp_max. PostgreSQL, tuttavia, avverte che impostazioni come work_mempossono essere utilizzate da più operazioni all'interno di una singola query e da molte sessioni contemporaneamente. Questa combinazione spiega perché un'impostazione che sembra innocua isolatamente può diventare dispendiosa durante un periodo di picco. La soluzione più sicura è misurare prima, ridurre la concorrenza non necessaria in secondo luogo, e infine ottimizzare la memoria e il comportamento di manutenzione solo dove i dati lo indicano.
Passaggio 1: Verificare che PostgreSQL sia effettivamente la fonte del problema di memoria.
Partiamo dal livello del sistema operativo. Su Linux, confrontiamo la memoria totale, la memoria disponibile, lo swap e i processi che occupano più spazio:
free -h
ps aux --sort=-%mem | head -n 15
Non giudicate il server da una singola riga di processo. PostgreSQL utilizza sia memoria condivisa che memoria privata nei processi di backend, quindi la domanda utile è se l'host sia effettivamente sotto pressione: poca memoria disponibile, swap in aumento, terminazioni per esaurimento della memoria (OOM) o latenza costante. Registrate i valori durante un periodo di inattività e di nuovo durante un periodo di carico elevato. Questa base di riferimento renderà misurabili le modifiche successive, anziché basarvi su supposizioni.
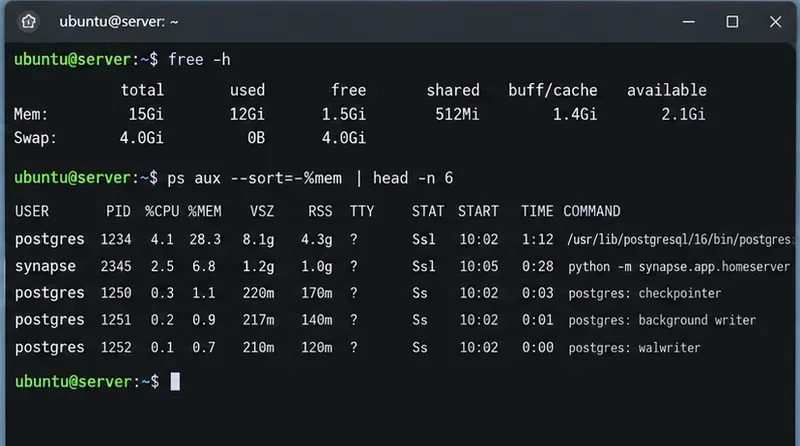
Didascalia: Un primo controllo della memoria confronta la RAM disponibile a livello host con i processi PostgreSQL e Synapse prima di qualsiasi modifica alla configurazione.
Successivamente, esamina le impostazioni di PostgreSQL che con maggiore probabilità influiscono sulla memoria:
SHOW shared_buffers;
SHOW work_mem;
SHOW maintenance_work_mem;
SHOW autovacuum_work_mem;
SHOW max_connections;
La documentazione sul consumo di risorse di PostgreSQL descrive la distinzione fondamentale. shared_buffersLa cache è una cache condivisa a livello di server. Al contrario, work_memrappresenta un limite per le singole operazioni di ordinamento o hash prima che vengano scritte su file temporanei; una query complessa può includere diverse di queste operazioni e molte sessioni possono eseguirle contemporaneamente. PostgreSQL attualmente documenta 4 MB come work_memvalore predefinito e precisa che l'utilizzo totale può essere molte volte superiore a tale valore.
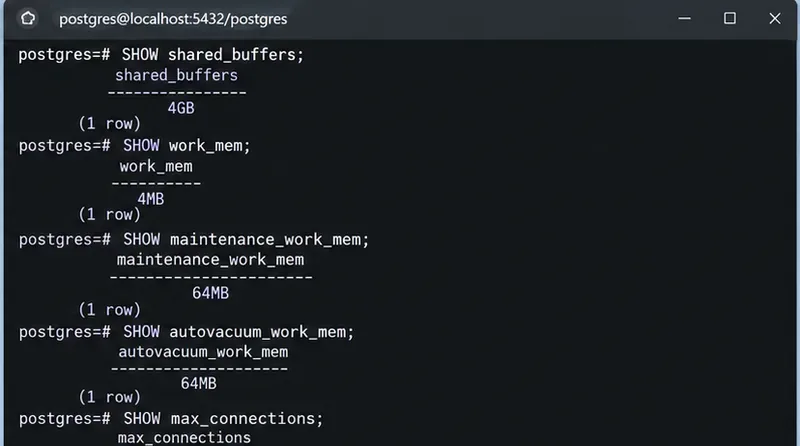
Didascalia: Leggete le impostazioni attive relative alla memoria di PostgreSQL prima di modificarle; il valore pericoloso è spesso la combinazione di impostazioni e concorrenza, piuttosto che un singolo numero.
Passaggio 2: Contare le connessioni al database Synapse e trovare i lavori attivi
Un pool di connessioni di grandi dimensioni non si consuma automaticamente work_memper ogni connessione, ma ogni backend PostgreSQL ha il proprio processo e la propria memoria privata, e un maggior numero di query simultanee crea maggiori opportunità di allocazione di memoria per operazione. Verifica quante connessioni sono effettivamente aperte e in quale stato si trovano:
SELECT state,
       usename,
       application_name,
       count(*) AS connections
FROM pg_stat_activity
GROUP BY state, usename, application_name
ORDER BY connections DESC;
Successivamente, esamina le query attive di lunga durata:
SELECT pid,
       usename,
       state,
       now() - query_start AS running_for,
       wait_event_type,
       wait_event,
       left(query, 180) AS query
FROM pg_stat_activity
WHERE state <> 'idle'
ORDER BY query_start;
La documentazione ufficialepg_stat_activity spiega i campi relativi a sessione e attività. Un numero elevato di sessioni inattive è diverso da un numero ridotto di query attive che consumano molta memoria, quindi anche la soluzione dovrebbe essere diversa. Se il problema è il numero di connessioni, è necessario intervenire sulla dimensione del pool di indirizzi. Se il problema è causato da poche query che consumano molta memoria, ridurre la dimensione del pool potrebbe semplicemente mascherare il sintomo.
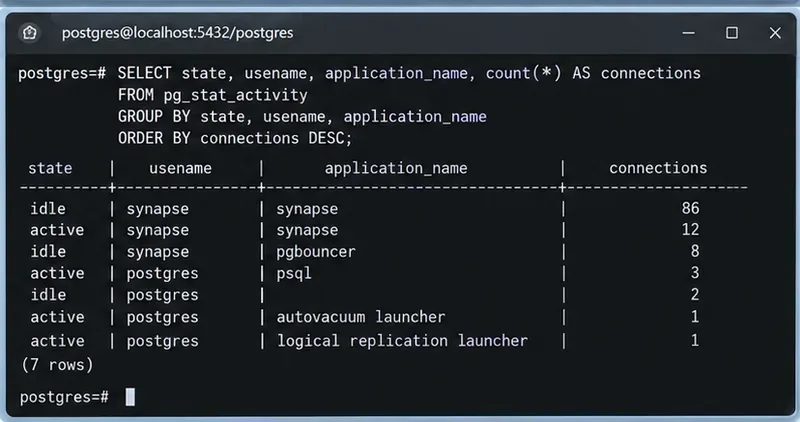
Didascalia: Il raggruppamento pg_stat_activitysemplifica la distinzione tra numerosi backend inattivi e un insieme più ristretto di sessioni di database attive.
Passaggio 3: Dimensionare correttamente il pool di connessioni Synapse PostgreSQL
Synapse passa la maggior parte degli argomenti del database a PostgreSQL mentre utilizza le opzioni che iniziano con per il suo pool di connessioni Twisted. La guidacp_ attuale di Synapse PostgreSQL mostra un esempio con e . Considera questi come valori di esempio, non come un obiettivo universale.cp_min: 5cp_max: 10
Controlla il databaseblocco in homeserver.yaml:
database:
  name: psycopg2
  args:
    user: synapse_user
    password: "your-secret"
    dbname: synapse
    host: 127.0.0.1
    cp_min: 5
    cp_max: 10
Se in precedenza hai aumentato il valore cp_maxin modo aggressivo e pg_stat_activityquesto mostra un numero elevato di connessioni Synapse perlopiù inattive, riducilo gradualmente e monitora la latenza delle richieste. In un'implementazione Synapse basata su worker, ricorda che la richiesta di database proviene da più processi Synapse, quindi valuta il numero totale di connessioni anziché un singolo worker. Il manuale di configurazione di Synapse conferma che cp_le opzioni configurano il pool di connessioni.
Dopo aver modificato la configurazione, riavvia il processo o i processi Synapse interessati in base al metodo di implementazione, quindi esegui nuovamente la query di conteggio delle connessioni. Non ridurre il pool fino a quando le richieste non iniziano ad accumularsi in coda solo per risparmiare pochi megabyte. Un pool troppo piccolo può trasformare la concorrenza del database in latenza dell'applicazione.
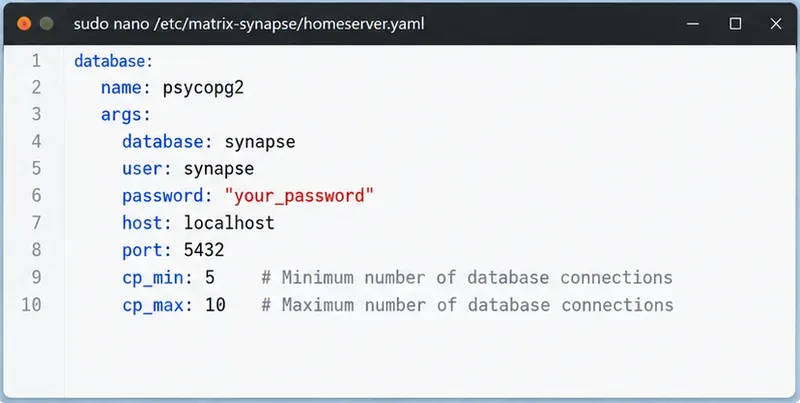
Didascalia: Synapse espone cp_mine cp_maxnella configurazione del database PostgreSQL, consentendo agli amministratori di limitare la concorrenza non necessaria nel backend.
Passaggio 4: Ottimizzare la memoria di PostgreSQL in modo conservativo
Una volta che il numero di connessioni è ragionevole, rivedi le impostazioni di memoria di PostgreSQL nel contesto della RAM effettivamente disponibile per il database. PostgreSQL afferma che su un server di database dedicato con almeno 1 GB di RAM, circa il 25% della memoria di sistema è un buon punto di partenza shared_buffers. Questa indicazione è esplicitamente per un server di database dedicato. Se Synapse, reverse proxy, Redis, il monitoraggio e PostgreSQL condividono una piccola macchina virtuale, PostgreSQL non ha il controllo dell'intera macchina, quindi pianifica il budget di conseguenza.
L'impostazione che più probabilmente sorprenderà gli amministratori è work_mem. Evitate di moltiplicare work_memper max_connectionse di considerarlo come una prenotazione fissa; PostgreSQL non lo prealloca in questo modo. Pensate invece in termini di operazioni di query simultanee. Una singola query può utilizzare diversi nodi di ordinamento o di hash e le operazioni di hash possono utilizzare un multiplo di work_mem. Se impostate work_mema un numero molto elevato a livello globale perché un report era lento, un picco di federazione o un periodo di intensa sincronizzazione possono produrre un picco di memoria molto maggiore del previsto.
Un approccio sensato consiste nel mantenere il valore globale conservativo e aumentarlo solo per una specifica sessione amministrativa quando una query nota trae vantaggio da una maggiore quantità di memoria. Prima di modificare i valori, conserva la configurazione esistente e prendi nota di quali parametri richiedono il riavvio di PostgreSQL. shared_buffers, ad esempio, è un'impostazione di avvio del server. Le modifiche dovrebbero essere pianificate in modo da poter confrontare il comportamento di memoria, latenza e file temporanei prima e dopo.
Controlla anche maintenance_work_meme autovacuum_work_mem. PostgreSQL nota che i worker di autovacuum possono allocare memoria di manutenzione contemporaneamente. Se autovacuum_work_memviene lasciato al suo comportamento ereditato, un insolitamente grande maintenance_work_mempuò rendere costosi diversi worker di autovacuum simultanei. Non disabilitare autovacuum per risparmiare RAM; questo di solito comporta un sintomo di memoria a breve termine a scapito di tabelle sovradimensionate, statistiche obsolete e prestazioni peggiori.
Passaggio 5: Verificare lo stato del vuoto, quindi verificare la riparazione sotto carico reale.
Synapse scrive e aggiorna grandi quantità di dati relativi a eventi e stati. PostgreSQL necessita di un'operazione di vacuum periodica per recuperare le tuple obsolete e riutilizzarle, nonché per mantenere aggiornate le statistiche del planner. La guida al vacuum periodico di PostgreSQL raccomanda l'utilizzo di autovacuum per la maggior parte delle installazioni.
Cerca tabelle con molte tuple stimate non più attive o timestamp di manutenzione obsoleti:
SELECT relname,
       n_live_tup,
       n_dead_tup,
       last_autovacuum,
       last_autoanalyze
FROM pg_stat_user_tables
ORDER BY n_dead_tup DESC
LIMIT 20;
Se una tabella specifica necessita chiaramente di attenzione, la normalizzazione VACUUM (ANALYZE)è solitamente il primo strumento manuale da prendere in considerazione:
VACUUM (ANALYZE) your_table_name;
Evitate di passare direttamente a VACUUM FULL. La documentazione ufficiale di VACUUM spiega che le normali VACUUMoperazioni di lettura e scrittura possono essere eseguite insieme alle normali operazioni di lettura e scrittura, mentre VACUUM FULLriscrive la tabella e acquisisce un ACCESS EXCLUSIVEblocco. Utilizzate quest'ultima solo quando il recupero dello spazio su disco giustifica l'interruzione pianificata.
Come capire se il cambiamento ha funzionato davvero
Verifica il risultato con lo stesso tipo di carico di lavoro che ha causato il problema. Una soluzione efficace non si limita a "Postgres utilizza immediatamente meno RAM". Le cache del database dovrebbero utilizzare la memoria. Piuttosto, verifica la disponibilità di memoria stabile, una crescita minima o nulla dello swap, l'assenza di eventi OOM (Out Of Memory), un numero di connessioni che corrisponda alla concorrenza prevista e tempi di risposta di Synapse accettabili.
- Esegui
free -hl'elenco dei processi allo stesso livello di traffico utilizzato per la tua baseline.
- Ripeti la
pg_stat_activityquery di connessione e verifica che il conteggio dei backend inattivi sia diminuito dopo aver modificato il pool di Synapse.
- Monitora la latenza delle query e della sincronizzazione dopo averla ridotta
cp_max; annulla la modifica se i tempi di attesa del database aumentano in modo significativo.
- Eseguire
pg_stat_user_tablesperiodicamente dei controlli per confermare che l'aspirazione automatica stia effettivamente visitando le tabelle più utilizzate.
- Se hai ridotto il valore
work_mem, verifica se le operazioni di grandi dimensioni ora vengono riversate eccessivamente in file temporanei prima di ridurlo ulteriormente.
Se, dopo questi controlli, PostgreSQL continua a crescere fino a quando l'host non utilizza intensamente lo swap, è consigliabile acquisire l'elenco delle query attive durante il picco e analizzare il carico di lavoro anziché ridurre ripetutamente i limiti di memoria globale. Nelle versioni di PostgreSQL supportate, pg_backend_memory_contextsè possibile ispezionare i contesti di memoria per il backend corrente; la documentazione relativa alla vista di sistema di PostgreSQL descrive la vista e le relative autorizzazioni. Questo approccio è più utile per un'indagine mirata del database rispetto al presupporre che ogni implementazione di Synapse con elevato utilizzo di memoria abbia la stessa causa.
In conclusione
Per Matrix Synapse su PostgreSQL, l'elevato utilizzo della memoria del database si risolve in modo più sicuro procedendo per livelli: verificare che l'host sia effettivamente sottoposto a pressione di memoria, contare le sessioni del database, dimensionare correttamente il pool di Synapse, mantenere un utilizzo conservativo della memoria per operazione di PostgreSQL e assicurarsi che l'autovacuum funzioni correttamente. L'obiettivo non è ridurre al minimo l'ingombro di PostgreSQL, bensì ottenere un utilizzo prevedibile della memoria senza trasformare la normale gestione della cache e della concorrenza del database in swap evitabili, eventi di esaurimento della memoria (OOM) o rallentamenti dei client Matrix.









