Il tuo server Ubuntu si riavvia dopo un aggiornamento o un'interruzione di corrente, quindi si blocca al prompt "Entering emergency mode". SSH non è disponibile, i servizi sono inattivi e la console richiede manutenzione. Questo di solito significa che systemd non è riuscito a completare una fase di avvio necessaria, spesso perché un controllo del filesystem non è andato a buon fine o non è stato possibile trovare un punto di montaggio necessario. Considera questo messaggio come un indizio: identifica l'unità difettosa prima di modificare i file o eseguire un comando di riparazione.
Questa guida si applica alle installazioni convenzionali di Ubuntu Server che utilizzano systemd. I comandi e i menu di avvio possono differire su Ubuntu Core, sistemi crittografati, immagini cloud e server gestiti dal provider. Le attuali pagine man di Ubuntu descrivono emergency.target come una shell minimale che non avvia i servizi normali né monta filesystem ordinari; a seconda di come vi si accede, il filesystem root può essere di sola lettura o di lettura/scrittura. Per questo motivo, i primi passi consistono nell'ispezione e in un backup.
1. Leggi il messaggio di errore prima di modificare qualsiasi cosa.
Accedi alla console locale o del provider se richiesto. Su una macchina fisica, collega una tastiera e un monitor; su un server virtuale, utilizza la console seriale o di ripristino del provider. Fotografa o copia l'errore completo, in particolare il nome di un'unità come systemd-fsck@dev-disk-by-uuid-....serviceo un'unità di montaggio che termina con .mount. Un UUID mancante, un controllo del filesystem non riuscito e un servizio danneggiato richiedono soluzioni diverse.
Dalla shell di emergenza, ispeziona le unità guaste e il registro di avvio corrente:
systemctl --failed
journalctl -xb
Cerca il primo errore significativo, non solo la riga finale "dependency failed". Se il log identifica un punto di montaggio, annota il punto di montaggio e l'UUID del dispositivo. Se identifica un servizio non correlato allo storage, non iniziare a modificarlo /etc/fstaba caso; esamina quella specifica unità systemctl status unit-namee i suoi recenti messaggi di log.
2. Verificare se il filesystem root consente le modifiche
Prima di modificare un file di configurazione, verifica come viene montato il filesystem root:
findmnt /
Se le opzioni mostrano ro, il filesystem root è di sola lettura. Se il filesystem è altrimenti integro e devi eseguire una piccola riparazione della configurazione, rimontalo in modalità lettura/scrittura:
mount -o remount,rw /
Eseguire findmnt /nuovamente il comando per confermare la modifica. Se il rimontaggio fallisce, interrompere l'operazione e registrare l'errore. Una directory root di sola lettura può rappresentare una risposta protettiva in caso di problemi al filesystem; forzare le scritture o tentare ripetutamente il montaggio può rendere più difficile il ripristino. Utilizzare un ambiente di ripristino o contattare l'assistenza del provider se il volume root risulta danneggiato.
3. Ispeziona i dischi e confrontali con /etc/fstab
Una causa comune è una /etc/fstabvoce obsoleta: un disco è stato rimosso, un UUID è cambiato o un percorso di montaggio è stato digitato in modo errato. Il primo elenco mostra i filesystem rilevati e i relativi identificatori:
lsblk -f
blkid
Quindi leggi la configurazione della tabella di montaggio:
cat /etc/fstab
Confronta ogni UUID configurato con l'output di lsblk -fo blkid, e verifica che il punto di montaggio e il tipo di filesystem siano corretti. Non sostituire un nome di dispositivo come /dev/sdb1basandoti solo sulla sua lettera corrente; l'ordine dei dispositivi può cambiare. Gli UUID sono spesso più stabili, ma devono comunque corrispondere al filesystem effettivo.
Il /etc/fstabfile viene tradotto in unità di montaggio systemd all'avvio. I suoi campi e le sue opzioni hanno significati specifici, quindi consulta il manuale ufficiale di fstab di Ubuntu se una voce non ti è familiare.
4. Bypassare temporaneamente un supporto opzionale mancante
Se la voce che causa l'errore punta a un disco dati non essenziale intenzionalmente assente, esegui un backup /etc/fstab, quindi commenta solo quella riga inserendo #all'inizio. Questo ti permette di verificare se il mount mancante è l'ostacolo all'avvio. Non commentare il filesystem root, /booto una voce di volume crittografato a meno che tu non conosca la struttura di archiviazione del sistema.
cp -a /etc/fstab /etc/fstab.before-emergency-fix
nano /etc/fstab
In alternativa, se il disco deve essere opzionale durante il normale funzionamento, valutare l' nofailopzione di montaggio dopo aver verificato il comportamento previsto. Utilizzarla solo per un montaggio effettivamente opzionale: aggiungerlo a un volume di sistema necessario può nascondere un reale guasto dell'unità di archiviazione. I filesystem di rete potrebbero richiedere opzioni specifiche di systemd e dipendenze di rete aggiuntive; non copiare opzioni da una configurazione non correlata.
Dopo la modifica, chiedi a systemd di ricaricare le unità generate e testa il file:
systemctl daemon-reload
mount -a
Leggi tutto l'output. Un output pulito non dimostra che ogni applicazione possa utilizzare i dati montati, ma un errore UUID, di sintassi o di montaggio segnalato indica cosa resta da correggere. Il manuale di systemd-fstab-generator spiega come systemd converte le voci di fstab in unità di montaggio.
5. Riparare un UUID, un percorso o un'opzione di montaggio errati.
Se il disco è presente ma il suo UUID è diverso, verifica di aver identificato il filesystem corretto prima di aggiornare il UUID=...campo corrispondente. Conferma che la directory del punto di montaggio esiste, che il tipo di filesystem è corretto e che le opzioni sono valide per quel filesystem. Correggi una voce alla volta, quindi esegui nuovamente systemctl daemon-reloade mount -a.
Per un disco dati rimovibile o secondario opzionale, l'impostazione di un'apposita policy di montaggio opzionale può impedire che un dispositivo assente blocchi l'avvio. Per un volume critico, riparare il dispositivo, il cavo, la mappatura di crittografia o l'identificativo anziché mascherare il guasto. Se l'unità guasta identifica un dispositivo LUKS o LVM, esaminare la mappatura e lo stato del volume correlati; non sostituire il suo UUID con una partizione con un nome simile.
6. Eseguire un controllo del filesystem solo quando la destinazione è smontata.
Se la console segnala specificamente errori del filesystem, identifica il tipo di filesystem e il dispositivo prima di ripararlo. Non eseguire un'utilità di riparazione su un filesystem montato, soprattutto se si tratta del filesystem root attivo. Il manuale di Ubuntu fsck descrive il comando wrapper; il controllo e le opzioni di riparazione corretti dipendono dal filesystem.
Per una partizione dati ext2, ext3 o ext4, verificare innanzitutto che non sia montata con findmnt. Se è montata, smontarla prima di eseguire il controllo. Un tipico controllo di ext4 da un ambiente di ripristino appropriato è:
sudo e2fsck -f /dev/DEVICE
Sostituire /dev/DEVICEsolo dopo aver individuato la partizione corretta lsblk -f. Leggere le domande e lo stato del controllo; non aggiungere un'opzione automatica "sì a tutto" senza aver compreso il rischio di perdita di dati. Per un filesystem root che non può essere smontato dalla shell di emergenza in esecuzione, avviare un ambiente di ripristino live o del provider e verificarlo offline. Btrfs, XFS e altri filesystem utilizzano strumenti e procedure di riparazione diversi. In particolare, non considerare un fsckcomando generico come prova che ogni tipo di filesystem sia stato riparato.
7. Utilizzare GRUB o il ripristino esterno solo quando la shell non è disponibile.
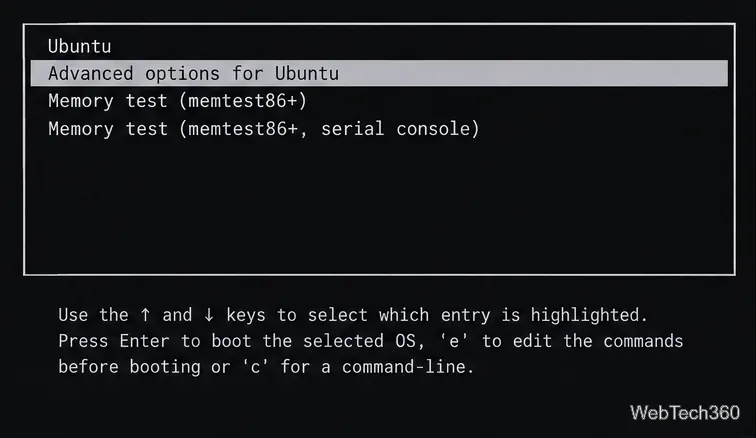
Se il server non riesce ad accedere alla shell di emergenza, apri il menu GRUB e prova la voce di ripristino della distribuzione, se disponibile. In un'installazione standard di Ubuntu, il menu si accede spesso tenendo premuto Maiusc sui sistemi BIOS legacy o premendo Esc sui sistemi UEFI, ma le macchine virtuali ospitate possono utilizzare un flusso di console diverso. Per un avvio di emergenza systemd una tantum, un amministratore può modificare la voce GRUB selezionata e aggiungerla systemd.unit=emergency.targetalla riga di comando del kernel Linux. La modifica si applica solo a quell'avvio; rimuovila prima del successivo avvio normale. Consulta la documentazione ufficiale del menu GRUB di GNU .
Se il volume di avvio non può essere montato, utilizzare un ambiente Ubuntu live o il sistema di ripristino del provider cloud per ispezionarlo. Sbloccare lo storage crittografato e attivare LVM solo se corrisponde all'installazione. Il montaggio del filesystem root di un server dalla modalità di ripristino comporta rischi aggiuntivi; evitare di scriverci sopra finché il disco e il filesystem non sono stati identificati. Ubuntu Core utilizza un proprio flusso di lavoro di ripristino e non viene riparato seguendo ciecamente i passaggi per desktop o per Server GRUB.
8. Riavvia e verifica la riparazione
Quando la causa segnalata viene corretta e i test di montaggio vengono superati, riavviare:
reboot
Dopo l'avvio, verificare che l'host raggiunga il suo target multiutente abituale, che i filesystem previsti siano montati e che i servizi importanti siano attivi:
systemctl is-system-running
systemctl --failed
findmnt --target /
Verificare i punti di montaggio dati previsti con findmnt /path/to/mounte confermare i servizi critici con systemctl status service-name. Se la modalità di emergenza ritorna, esaminare nuovamente il primo errore del nuovo avvio anziché ripetere la stessa riparazione. Un ripristino riuscito significa che il server completa un avvio normale e che lo storage e i servizi necessari sono disponibili; il semplice raggiungimento del prompt di accesso non è sufficiente.
Per informazioni sul comportamento attuale di systemd, consultare il manuale delle unità speciali di Ubuntu . Le versioni dei pacchetti e i menu di ripristino possono variare a seconda della versione di Ubuntu e della piattaforma di hosting, quindi, se un comando o un'unità differisce, fare riferimento alla documentazione della versione installata.