Home
» LINUX
»
Come configurare il clustering ad alta disponibilità (HAE) su SUSE Linux 15
Come configurare il clustering ad alta disponibilità (HAE) su SUSE Linux 15
Questa guida per principianti illustra la creazione di un cluster attivo/passivo di base a due nodi con SUSE Linux Enterprise High Availability (SLE HA) 15. Utilizza gli script di bootstrap supportati da CRM Shell: inizializza il primo nodo con crm cluster init, aggiungi il secondo con crm cluster join, verifica l'appartenenza al cluster e testa un failover pianificato dell'IP virtuale di gestione. Gli esempi seguono la documentazione di SUSE SLE HA 15 SP7, pubblicata il 24 settembre 2026; i prompt possono variare a seconda del service pack, dell'hardware e della piattaforma.
Il termine "HAE" viene spesso utilizzato informalmente per indicare l'estensione High Availability. La documentazione attuale di SUSE la chiama SUSE Linux Enterprise High Availability, o SLE HA. Questa procedura fornisce una base di cluster funzionante e l'accesso alla gestione di Hawk2. Non rende automaticamente un'applicazione, un database o i relativi dati altamente disponibili; questi necessitano di risorse Pacemaker dedicate, di una progettazione dello storage e di test specifici per il carico di lavoro.
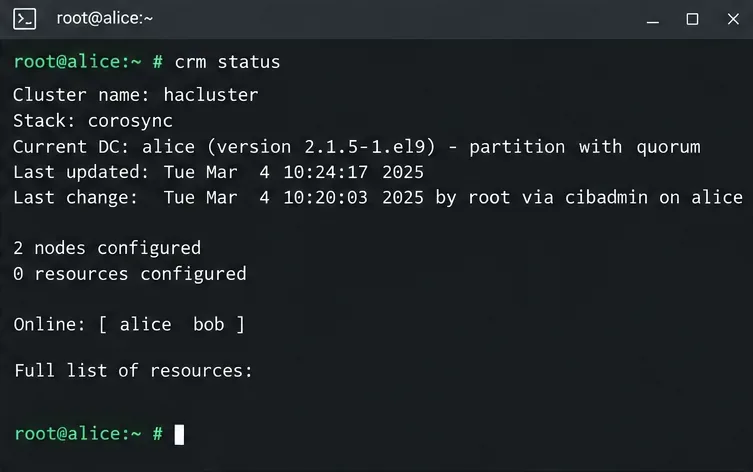
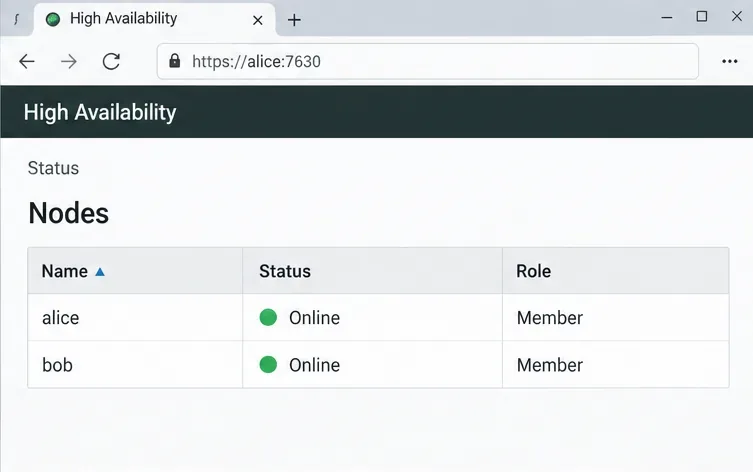
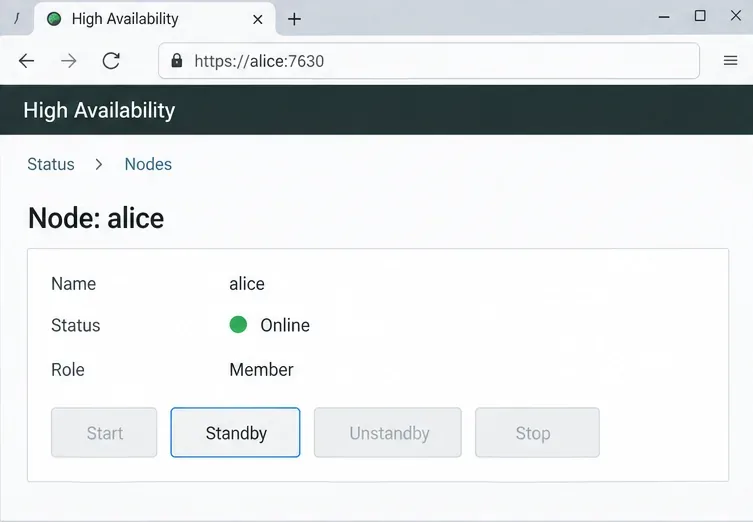
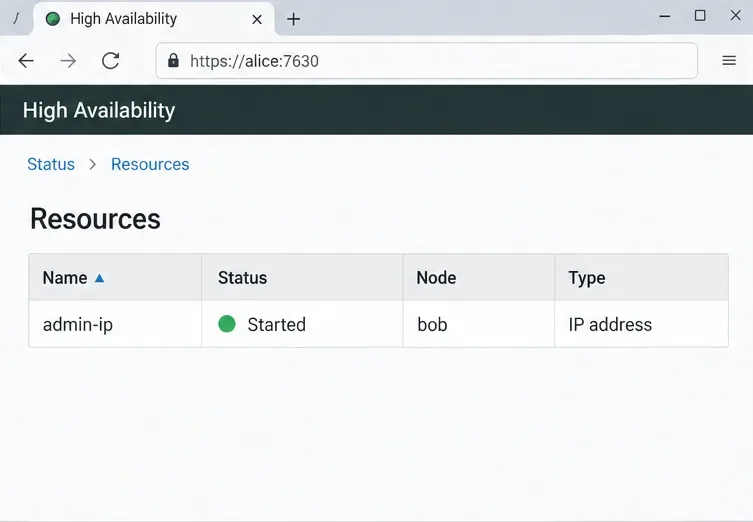
Le illustrazioni del terminale e della schermata di Hawk2 riportate di seguito mostrano viste rappresentative dell'interfaccia, non schermate di un sistema in tempo reale. Nomi e indirizzi sono solo esempi. Sostituiscili con i valori della tua rete.
Che cosa farà questo gruppo?
Un cluster è un gruppo di server, chiamati nodi , che si coordinano per mantenere in esecuzione determinati servizi. Corosync gestisce l'appartenenza ai nodi e la messaggistica del cluster. Pacemaker, il gestore delle risorse del cluster, decide dove devono essere eseguite le risorse gestite e risponde ai guasti. Una risorsa è un servizio o un indirizzo che Pacemaker può avviare, arrestare, monitorare e spostare.
In questa procedura guidata, nodo alicee nodo bobformano un cluster a due nodi. Un indirizzo IP di gestione fluttuante fornisce agli amministratori un indirizzo stabile per Hawk2, l'interfaccia web di SUSE. Se un nodo viene messo in standby, Pacemaker può spostare quell'indirizzo IP sull'altro nodo. Per un cluster di produzione a due nodi, SUSE consiglia di aggiungere QDevice/QNetd per le decisioni di quorum e richiede il fencing dei nodi.
Cosa bisogna preparare prima dell'installazione?
Due sistemi SUSE Linux Enterprise Server 15 supportati, con lo stesso service pack e la stessa architettura del processore, con accesso root o tramite un account sudo con privilegi adeguati.
Registrazione SUSE valida e autorizzazione per SLE HA su ogni nodo. L'estensione e il modello di pacchetto devono corrispondere al service pack e all'architettura di SLES.
Indirizzi statici dei nodi, risoluzione dei nomi funzionante, orologi sincronizzati e connettività affidabile tra cluster e rete. Scegliere con attenzione l'interfaccia Corosync desiderata; percorsi separati o ridondanti sono utili nelle architetture di produzione.
Un piano di fencing. Il fencing (STONITH, "Spara all'altro nodo in testa") isola o riavvia forzatamente un nodo che potrebbe non essere integro, impedendo a entrambi i lati di una divisione di rete di scrivere su dati condivisi. Un cluster supportato deve avere il fencing abilitato.
Se si utilizza SBD (STONITH Block Device), è necessario un watchdog adeguato su ciascun nodo e un sistema di archiviazione a blocchi condiviso opportunamente progettato con un percorso del dispositivo stabile. Per gli ambienti di produzione è preferibile un watchdog hardware. Se si utilizza invece un power fence fisico, configurare e testare un dispositivo STONITH supportato.
Per due nodi, se si intende configurarli tramite il flusso di bootstrap, è necessario pianificare un witness QDevice/QNetd prima dell'inizializzazione. Un witness aiuta il cluster a decidere quale lato ha il quorum in caso di perdita di connettività.
Non considerate una configurazione di laboratorio come pronta per la produzione. I requisiti di sistema di SUSE SLE HA 15 SP7 richiedono la delimitazione dell'ambiente di produzione e la relativa guida all'installazione raccomanda di testare la configurazione con due o tre nodi prima di espanderla.
Passaggio 1: Installare l'estensione SLE HA e i relativi pacchetti
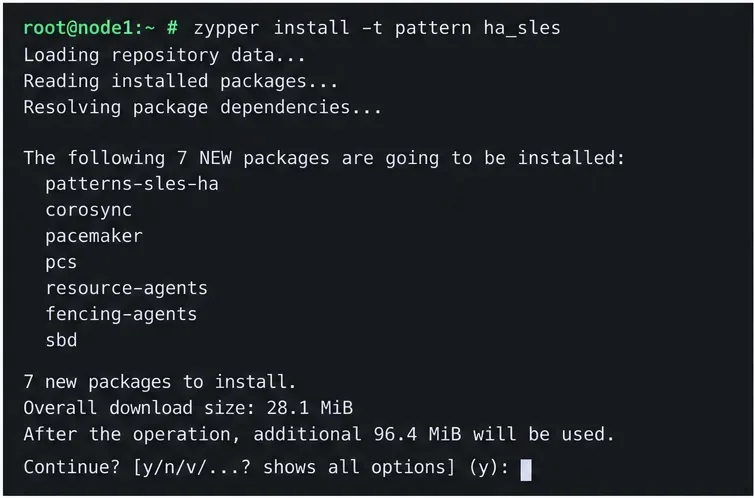
Se SLE HA non è stato selezionato durante l'installazione di SLES, abilitare l'estensione su ciascun nodo. Per un host SLES 15 SP7 x86_64 registrato, il modello documentato è il seguente:
Sostituire ADDITIONAL_REGCODEcon il codice di registrazione SLE HA. Utilizzare l'identificativo del prodotto di attivazione corrispondente al proprio service pack e alla propria architettura; non copiare l'esempio SP7 in un service pack SLES 15 diverso. Eseguire il comando package-pattern su entrambi i nodi. SUSE documenta il ha_slespattern come l'insieme di pacchetti utilizzati per configurare e gestire il cluster.
Visualizzazione nel terminale del comando di installazione del modello di alta disponibilità sul primo nodo.
Passaggio 2: Preparare nomi, orari e accesso alla rete
Assegna a entrambi i nodi nomi host stabili e indirizzi IP primari statici. Verifica che ciascun nodo sia in grado di risolvere l'altro sia tramite nome breve che tramite nome completo. La guida di configurazione di SUSE raccomanda di elencare i membri del cluster /etc/hostsquando necessario, poiché gli errori di risoluzione dei nomi possono interrompere la comunicazione interna. Ad esempio, adatta voci come queste al tuo DNS e al piano di indirizzamento:
10.20.0.11 alice.example.net alice
10.20.0.12 bob.example.net bob
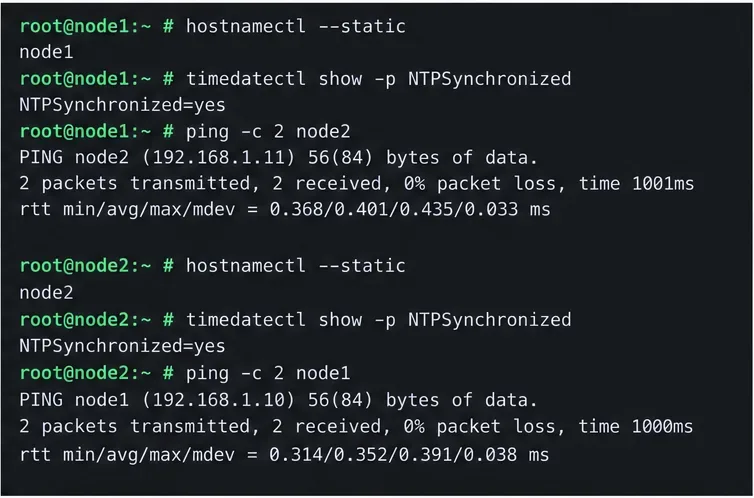
Sincronizza entrambi gli orologi con una sorgente NTP esterna al cluster e mantieni i loro fusi orari coerenti. Chrony è l'implementazione NTP predefinita su SLES 15. Verifica la connettività sulla rete che intendi utilizzare per Corosync. Gli script di bootstrap possono aprire le porte del firewall necessarie per la comunicazione del cluster, ma assicurati che i firewall dell'host e della rete consentano il traffico richiesto dalla topologia selezionata. Unicast è l'impostazione predefinita nel flusso di bootstrap; la porta predefinita documentata per Corosync è la 5405.
I controlli preliminari confermano i nomi dei nodi di esempio, gli orologi sincronizzati e la connettività peer.
Passaggio 3: Inizializzare il primo nodo
Su alice, esegui il comando bootstrap come root:
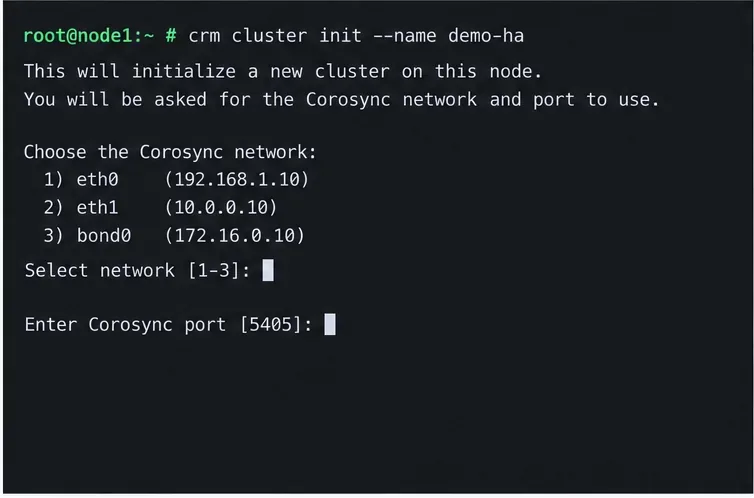
crm cluster init --name demo-ha
Esamina le richieste prima di accettarle. Seleziona l'interfaccia e l'indirizzo di rete destinati a Corosync, quindi conferma la porta. Lo script verifica la sincronizzazione dell'ora e la disponibilità del watchdog e può preparare le chiavi SSH e la relativa configurazione del cluster. Chiede se configurare SBD, un IP virtuale di amministrazione di Hawk2 e QDevice/QNetd. SBD richiede che il watchdog e il dispositivo condiviso siano già pronti. Se si configura QDevice in questa fase di bootstrap, preparare prima il server QNetd. Lo script crea un cluster a nodo singolo funzionante; non aggiunge nodi bobin questa fase.
Non scegliere un disco condiviso o un percorso di dispositivo casuale per SBD. Il percorso deve identificare lo stesso storage appropriato su ogni nodo e il suo comportamento in caso di errore e i timeout devono corrispondere alla progettazione dello storage. SUSE fa notare che softdognon è possibile riavviare una macchina se tutte le CPU sono bloccate, quindi utilizzare il watchdog hardware corretto per l'ambiente di produzione, ove disponibile.
La fase di bootstrap del primo nodo richiede la configurazione della rete di comunicazione del cluster e della porta Corosync.
Passaggio 4: Unirsi al secondo nodo
Dopo l'inizializzazione del primo nodo, accedi bobed esegui:
crm cluster join
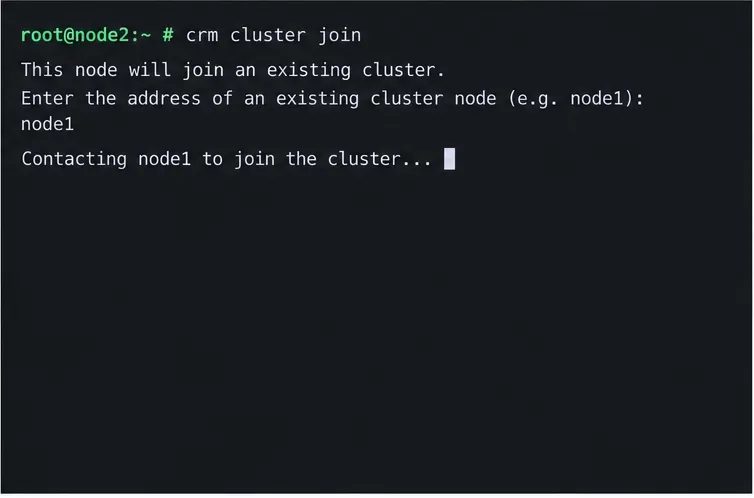
Segui le istruzioni per identificare il nodo del cluster esistente alice. Se per il primo nodo hai utilizzato un account sudo anziché root, SUSE documenta la specifica di tale account con -c, ad esempio:
sudo crm cluster join -c USER@alice
Lo script di join copia la configurazione di Corosync, configura SSH e Csync2, porta online la macchina corrente come nodo del cluster e avvia il servizio necessario per Hawk2. Non inizializzare entrambe le macchine in modo indipendente; il secondo nodo deve unirsi al cluster creato dal primo.
Esegui il flusso di lavoro di unione sul secondo nodo e indirizzalo al primo nodo inizializzato.
Passaggio 5: Verificare che entrambi i nodi siano online
Da entrambi i nodi, controlla il riepilogo del cluster:
crm status
Cerca entrambi i nomi dei nodi sotto Onlinee una partizione del cluster con quorum. Verifica la presenza di azioni non riuscite o di un nodo offline prima di procedere. Puoi anche accedere a Hawk2 utilizzando il VIP di amministrazione selezionato durante l'inizializzazione, in genere all'indirizzo https://ADMIN-VIP:7630/. Un avviso relativo al certificato di prima visita può verificarsi quando viene utilizzato un certificato autofirmato; verifica i dettagli del certificato con l'amministratore del cluster invece di ignorare un certificato sconosciuto in un ambiente di produzione.
Prima di testare il failover, un controllo dello stato del cluster dovrebbe mostrare entrambi i nodi online.L'elenco dei nodi fornisce un secondo metodo per confermare l'appartenenza al cluster.
Passaggio 6: Proteggere l'account di gestione
La procedura di bootstrap crea un haclusteraccount per Hawk2. La guida di configurazione di SUSE indica una password predefinita durante la configurazione di base, quindi cambiala immediatamente prima di lasciare il sistema accessibile:
passwd hacluster
Utilizza una password complessa e univoca e segui le politiche di gestione delle credenziali della tua organizzazione. Limita l'accesso alla rete di gestione di Hawk2, installa certificati attendibili ove necessario e non esporre l'interfaccia di gestione direttamente a Internet.
Passaggio 7: Testare in sicurezza un failover pianificato
Un test di standby pianificato verifica se l'indirizzo IP virtuale di gestione può spostarsi quando un nodo viene intenzionalmente rimosso dall'assegnazione delle risorse. Prima del test, verificare che entrambi i nodi siano integri, che il cluster abbia il quorum e di avere accesso alla console o fuori banda nel caso in cui si verifichino comportamenti imprevisti. Da un client sulla stessa rete, eseguire continuamente il ping dell'indirizzo IP virtuale di gestione, ad esempio:
ping 10.20.0.20
In Hawk2, apri il nodo che attualmente ospita l'indirizzo IP di amministrazione e seleziona Standby . Quindi controlla Stato > Risorse . La guida rapida di SUSE descrive lo spostamento della risorsa fluttuante sull'altro nodo mentre il ping continua. Al termine del test, rimetti il nodo in servizio utilizzando l'azione corrispondente in Hawk2, verifica che entrambi i nodi siano online e controlla che la risorsa si trovi nella posizione prevista.
Utilizzare un'azione di standby pianificata sul nodo attivo per testare lo spostamento delle risorse senza simulare un arresto anomalo.Dopo la modalità standby, verificare che l'IP di amministrazione sia in esecuzione sull'altro nodo.
Cosa dimostra questo test e cosa non dimostra?
Se entrambi i nodi rimangono visibili e l'indirizzo IP di amministrazione si sposta sul peer, si ha la prova che l'appartenenza di base al cluster e la risorsa IP mobile funzionano in questo scenario pianificato. Un semplice ping non dimostra che un'applicazione sia disponibile, che le sessioni client sopravvivano, che i dati condivisi siano protetti o che il cluster sia in grado di ripristinarsi da qualsiasi guasto di rete, di archiviazione, di alimentazione o del software.
Per un'applicazione, aggiungi l'agente di risorse corretto e configura l'ordinamento, la colocation, il monitoraggio, l'accesso allo storage e il fencing in base alla progettazione dell'applicazione. Non consentire mai a due nodi di scrivere contemporaneamente su storage condiviso ordinario. Prima della produzione, testa il ripristino del carico di lavoro e l'integrità dei dati in un ambiente di staging, includendo guasti realistici dei nodi e della rete.
Errori comuni da evitare
Saltando la fase di fencing: un cluster senza STONITH funzionante non può risolvere in modo sicuro lo split-brain e non soddisfa i requisiti di supporto di SUSE.
Supponendo che due nodi possano decidere autonomamente: pianificare QDevice/QNetd per un cluster con un numero pari di nodi, in particolare per un cluster a due nodi.
Utilizzo di identità di nodo instabili o non corrispondenti: utilizzare indirizzi statici, nomi host coerenti, risoluzione dei nomi sia in avanti che all'indietro e sincronizzazione dell'ora.
Utilizzo della rete errata: selezionare l'interfaccia Corosync desiderata e verificare le impostazioni del firewall su ogni percorso di rete.
Supponendo che il cluster protegga automaticamente un'applicazione: un cluster può gestire solo le risorse che sono state configurate e testate.
Definire la configurazione iniziale "pronta per la produzione" significa che l'avvio rapido è una configurazione di base. La piena prontezza per la produzione richiede test di ripristino specifici per il carico di lavoro, convalida del fencing, monitoraggio, procedure di backup e ripristino e documentazione delle operazioni.