Se un server SUSE Linux sembra bloccarsi durante il riavvio a causa di un messaggio di arresto di systemd, la prima ipotesi più utile non è che il comando di riavvio stesso sia difettoso. Nella maggior parte dei casi, systemd è in attesa che un'unità, un mount, un processo o un hook di arresto terminino. La soluzione più sicura è quindi identificare il processo esatto che è ancora in esecuzione, esaminare perché non si arresta e correggere quel componente, piuttosto che ridurre globalmente i timeout di arresto.
Questa guida utilizza un esempio ipotetico : un server denominato lab-sles01esegue SUSE Linux Enterprise Server e si blocca durante il riavvio con un messaggio simile a A stop job is running for backup.service. L'esempio è solo un'illustrazione del metodo diagnostico; non è un resoconto di un test reale né un'affermazione secondo cui una particolare versione di SUSE presenta un difetto in un servizio denominato backup.service.
La soluzione in quattro fasi in breve
| Fare un passo | Cosa fare | Cosa stai cercando di imparare |
|---|
| 1 | Registra il messaggio di arresto esatto | Quale unità o fase sta bloccando i progressi? |
| 2 | Rivedi il diario di avvio precedente | Sia che si tratti di un timeout di arresto, di un errore di smontaggio o di un arresto avvenuto in una fase successiva. |
| 3 | Ispezionare l'unità di bloccaggio e i lavori in corso | Che un servizio, un montaggio, un inibitore o una dipendenza siano responsabili |
| 4 | Risolvi la causa principale e riprova | Se una normale systemctl rebootora si completa senza ritardo |
Passaggio 1: Registrare esattamente il punto in cui si interrompe lo spegnimento.
Monitora la console locale, la console della macchina virtuale, la console BMC/IPMI o la console dell'hypervisor durante un riavvio pianificato. Una riga che specifica il nome di un'unità è molto più utile di una descrizione generica come "systemd si è bloccato". Ad esempio lab-sles01, supponiamo che la console mostri che backup.serviceil processo è ancora in fase di arresto, mentre altre unità si sono già spente.
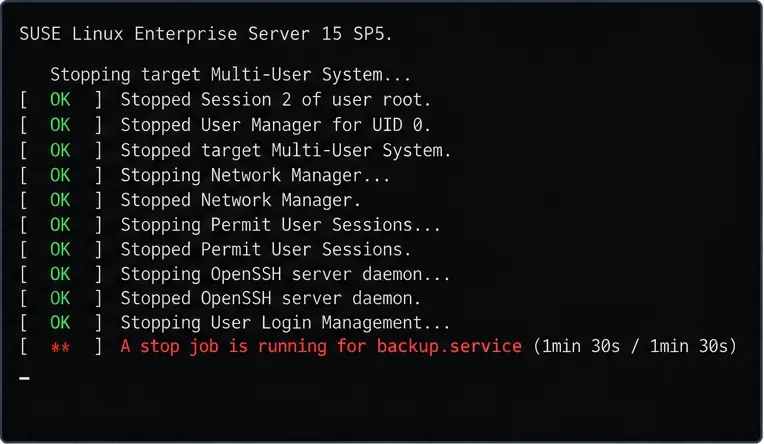
Esempio illustrativo: la console di arresto identifica backup.servicel'unità che systemd è ancora in attesa.
Se la console indica invece .mountun'unità, un file system di rete, un dispositivo o un altro servizio, segui quel nome anziché applicare un timeout di servizio generico. L'unità visualizzata nella parte inferiore della console è un indizio, ma non automaticamente la causa principale: potrebbe a sua volta essere in attesa di un processo figlio, di spazio di archiviazione, di I/O di rete o di un'altra dipendenza.
Le attuali linee guida di SUSE su systemd indicano che un riavvio o uno spegnimento prolungato possono essere causati da un servizio che non termina e raccomandano di controllare i processi di systemd. Vedere SUSE Linux Enterprise Server 16.0: Introduzione alle basi di systemd .
Passaggio 2: utilizzare il registro di avvio precedente dopo che il server restituisce
Dopo il riavvio della macchina, esamina lo spegnimento appena avvenuto. SUSE documenta gli offset di avvio nel journal: boot 0indica l'avvio corrente, -1è l'avvio precedente e così via. Inizia con:
sudo journalctl --list-boots
sudo journalctl -b -1
Per un giornale di grandi dimensioni, l'ordinamento inverso può far emergere più rapidamente gli ultimi messaggi:
sudo journalctl -b -1 -r

Esempio illustrativo: il registro di avvio precedente mostra che il servizio di backup ipotetico riceve il segnale SIGTERM e successivamente va in timeout.
Cerca frasi come Stopping, stop job, timed out, Failed with result, Unmounting, Dependency failed, o messaggi provenienti dal servizio sospetto stesso. Puoi restringere la ricerca una volta che conosci il nome dell'unità:
sudo journalctl -b -1 -u backup.service
SUSE documenta journalctl -b -1l'analisi dell'avvio precedente nella documentazione del journal di SLES 15 SP7 . Se journalctl --list-bootsnon contiene l'avvio precedente, non trarre conclusioni dalla cronologia mancante; verifica come è configurato lo storage journald e utilizza la console o il logging remoto per la successiva riproduzione.
Passaggio 3: Identificare se il bloccante è un servizio, un mount, un inibitore o un hook di arresto ritardato.
Se riesci a riprodurre il problema durante una finestra di manutenzione, tieni a disposizione una seconda console amministrativa. Prima che la connettività scompaia, esegui:
sudo systemctl list-jobs
sudo systemctl status backup.service
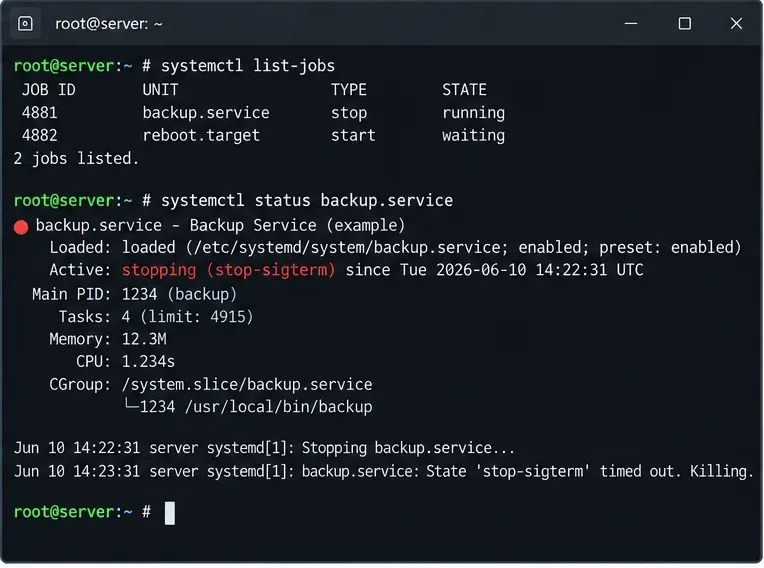
Esempio illustrativo: backup.serviceun processo di arresto è in esecuzione mentre il target di riavvio è in attesa.
La guida di debug di systemd a monte spiega che i processi indicati come runningdevono terminare prima che i processi dipendenti indicati come waitingpossano procedere. SUSE raccomanda inoltre di utilizzare systemctl list-jobsquesto comando quando lo spegnimento o il riavvio richiedono troppo tempo. Ciò rende questo comando particolarmente utile quando il server non è completamente bloccato e il PID 1 è ancora responsivo.
Se un servizio si arresta troppo lentamente
Esaminare la definizione dell'unità e il suo comportamento in fase di arresto:
sudo systemctl cat backup.service
sudo systemctl status backup.service
sudo journalctl -u backup.service -b
Verifica se il servizio ha ExecStop=un'azione in corso, se il suo processo gestisce il segnale SIGTERM e se è in attesa di risorse di archiviazione o di rete. Un database, un agente di backup o un servizio middleware potrebbero legittimamente aver bisogno di tempo per svuotare i dati, quindi terminarlo prima non risolve automaticamente il problema.
Se è coinvolto un mount o un file system di rete
Cerca le operazioni di smontaggio non riuscite e identifica la sorgente di montaggio:
findmnt
systemctl list-units --type=mount
sudo journalctl -b -1 | grep -Ei 'unmount|umount|mount|nfs|cifs'
Per NFS o CIFS, verificare la raggiungibilità del server, le sessioni obsolete e se le opzioni di montaggio soddisfano i requisiti di arresto del server. Se l'unità bloccata viene generata da /etc/fstab, correggere la configurazione di montaggio anziché applicare un timeout specifico del servizio a un'unità non correlata.
Se la richiesta di riavvio è inibita
Prima dell'avvio dello spegnimento, è possibile elencare gli inibitori di systemd attivi:
systemd-inhibit --list
I blocchi di inibizione possono bloccare o ritardare le richieste di arresto mentre un'applicazione sta eseguendo operazioni che non dovrebbero essere interrotte. Sono particolarmente utili quando la richiesta di riavvio viene ritardata prima che il sistema abbia avviato la sequenza di arresto finale. Consultare il manuale di systemd-inhibit .
Se il blocco si verifica dopo che i servizi sono già inattivi
Un blocco in una fase successiva richiede un'indagine diversa. systemd esegue i file eseguibili /usr/lib/systemd/system-shutdown/poco prima del riavvio o dello spegnimento finale e attende che terminino. Se il registro e la console mostrano che i servizi ordinari sono già stati arrestati e il blocco si verifica nella fase di spegnimento finale, è necessario esaminare quella directory e gli eventuali hook installati dal fornitore. La documentazione del servizio di spegnimento di systemd descrive questo comportamento.
Passaggio 4: Ripara il componente, quindi prova a eseguire un riavvio normale.
Torniamo all'ipotesi lab-sles01. Supponiamo che i log mostrino che il servizio backup.serviceignora la normale terminazione dopo che il suo processo di backup è già stato completato. La prima opzione è correggere il servizio o il suo comando di arresto. Se è noto che il servizio può essere terminato in sicurezza dopo un periodo limitato, un override di systemd per unità può limitare la durata dell'attesa di systemd.
Creare un override invece di modificare un'unità fornitore in /usr/lib/systemd/system:
sudo systemctl edit backup.service
Per esempio:
[Service]
TimeoutStopSec=30s
Quindi ricarica la configurazione dell'unità di systemd:
sudo systemctl daemon-reload
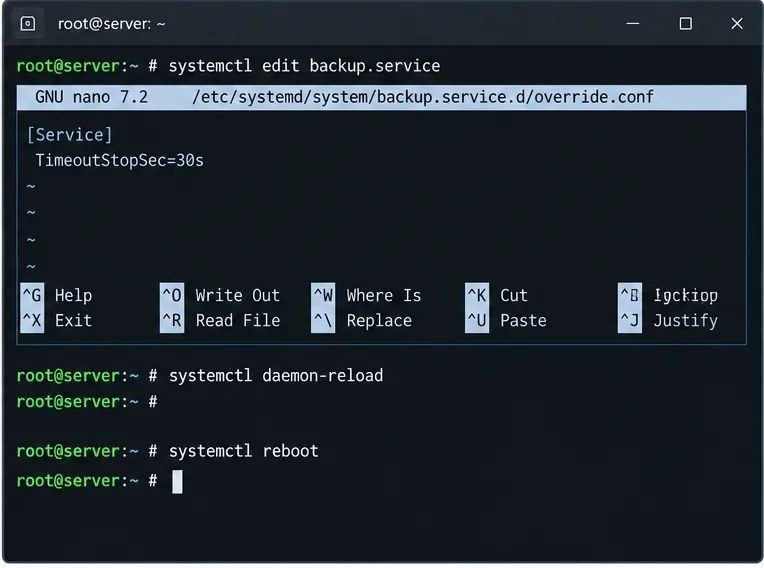
Esempio illustrativo: un timeout per servizio viene applicato solo dopo che il servizio ipotetico è stato identificato come bloccante.
Non copiare ciecamente il valore di 30 secondi. Il timeout corretto dipende da cosa il servizio reale deve effettivamente completare in modo sicuro. Ridurlo per un database, un demone di archiviazione, un servizio cluster o un processo di backup può interrompere le operazioni di pulizia legittime. Un timeout è una misura di sicurezza, non un sostituto per correggere ExecStop=un'azione non riuscita o un'applicazione che non termina correttamente.
Quando sei soddisfatto della modifica, prova a riavviare normalmente il sistema:
sudo systemctl reboot
Una volta che la macchina si è riavviata, rivedete l'avvio precedente e verificate che l'unità si sia arrestata correttamente e non sia semplicemente scomparsa dalla console.
Quando è opportuno ricorrere a un riavvio forzato?
Un riavvio forzato è un'opzione di ripristino, non una strategia di risoluzione dei problemi. La documentazione ufficiale di systemd afferma che un riavvio --forceforzato systemctl rebootsalta il normale arresto dei servizi, ma termina comunque i processi e tenta di smontare o rimontare i file system in sola lettura. Fornire --forcedue volte l'opzione è più pericoloso perché può riavviare il sistema senza terminare i processi o smontare i file system, con il rischio di perdita di dati.
Se il server è già bloccato e non esiste un modo più sicuro per ripristinare il servizio, un riavvio forzato potrebbe essere giustificato in base alle procedure operative in vigore:
sudo systemctl reboot --force
Evitate di considerare systemctl reboot --force --forceun ciclo di alimentazione virtuale o un ripristino fisico come una soluzione normale. Queste azioni possono eliminare le prove necessarie e compromettere le scritture in corso. La documentazione di systemctl a monte distingue esplicitamente i comportamenti di forzatura singola e doppia.
Cosa succede se ogni riavvio si blocca e non è possibile eseguire la risoluzione dei problemi in modalità normale?
Utilizza una console di manutenzione e avvia il sistema in modalità di ripristino. La documentazione SUSE illustra come aggiungere comandi systemd.unit=rescue.targetalla riga di comando del kernel dall'editor GRUB. La modalità di ripristino fornisce una sessione root con file system locali e servizi di base, lasciando la rete inattiva, il che può essere utile per disabilitare o riparare il servizio o la configurazione di montaggio problematici.
Consultare la Guida di amministrazione di SLES 15 SP7 per la procedura ufficiale di ripristino in modalità. Nei sistemi in cui il problema si manifesta solo dopo una specifica modifica a un pacchetto, kernel, driver o storage, esaminare anche la cronologia di manutenzione di SUSE pertinente prima di apportare modifiche permanenti al timeout.
Tabella decisionale rapida
| Ciò che vedi | Area probabile da ispezionare | Migliore azione successiva |
|---|
A stop job is running for xyz.service | Percorso di arresto del servizio | Verifica systemctl status, file dell'unità e registro di servizio |
| Messaggi ripetuti di smontaggio o di file system remoto | Montaggio, NFS, CIFS, archiviazione | Verifica findmnt, montaggio unità /etc/fstabe raggiungibilità del server |
| La richiesta di riavvio viene rifiutata o ritardata prima dello spegnimento. | Inibitore o un altro lavoro systemd | Corri systemd-inhibit --listesystemctl list-jobs |
| I servizi vengono interrotti, ma lo spegnimento definitivo non viene mai completato. | Hook di spegnimento ritardato, kernel, driver, storage | Esamina il registro di avvio precedente e/usr/lib/systemd/system-shutdown/ |
| Lo stivale normale rende impossibile la riparazione | Configurazione persistente o guasto dell'unità | Stivale consystemd.unit=rescue.target |
In conclusione
Per un server SUSE Linux che si blocca durante lo spegnimento di systemd, la soluzione definitiva consiste nell'identificare il processo per cui systemd è in attesa e correggere tale processo o una sua dipendenza. Registrare il messaggio di spegnimento, ispezionare journalctl -b -1, utilizzare systemctl list-jobse systemctl statusper isolare il blocco, e solo successivamente modificare un timeout per servizio o la configurazione di montaggio. Riservare i metodi di riavvio forzato alle situazioni di ripristino, non alle operazioni di routine.



