Home
» UFFICIO MS
»
Collabora Online vs ONLYOFFICE: Test di utilizzo delle risorse e latenza
Collabora Online vs ONLYOFFICE: Test di utilizzo delle risorse e latenza
La scelta tra Collabora Online e ONLYOFFICE Docs viene spesso inquadrata come una questione di funzionalità o di formato file, ma i team infrastrutturali si trovano solitamente a dover prendere una seconda decisione dopo l'implementazione: quanta CPU e memoria consuma ciascuna soluzione e quanto reattiva rimane la modifica all'aumentare del tempo di risposta e della concorrenza? Non esiste un valore universale affidabile per nessuno dei due prodotti, poiché la complessità dei documenti, i font, le operazioni di conversione, la latenza di archiviazione, il comportamento del browser, i proxy inversi e il numero di documenti aperti simultaneamente influenzano tutti il risultato.
A ottobre 2026, nessuno dei due fornitori pubblicava un benchmark comparativo diretto e aggiornato con l'altro. Questo è importante. Un confronto equo dovrebbe quindi distinguere due tipi di dati: le linee guida di dimensionamento dei fornitori, che indicano le risorse richieste da ciascun progetto, e un test ripetibile di latenza/risorse eseguito su hardware identico. Il piano di test riportato di seguito è progettato per produrre valori utilizzabili nella propria implementazione, senza presumere che un singolo risultato di laboratorio sia valido ovunque.
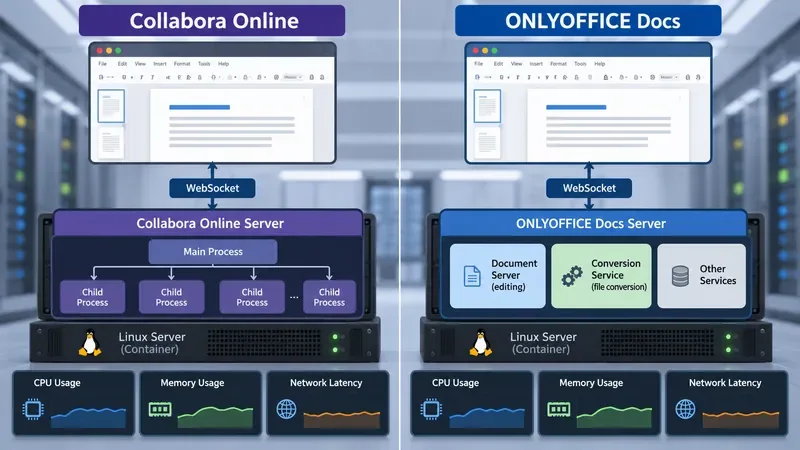
Un layout di benchmark affiancato per Collabora Online e ONLYOFFICE Docs. I pannelli di monitoraggio mostrano le metriche da raccogliere (CPU, memoria e latenza di rete) anziché i valori di benchmark misurati.
Cosa dicono effettivamente le linee guida ufficiali sulle risorse
I fornitori pubblicano informazioni utili sul dimensionamento, ma i valori non sono direttamente equivalenti. Il manuale dell'SDK di Collabora include un esempio di produzione Kubernetes/Helm che raccomanda richieste di risorse pari a 4 CPU e 6 GiB di memoria, con limiti di 8 CPU e 8 GiB. Lo stesso manuale descrive anche num_prespawn_childrenla funzionalità che mantiene i processi figli pronti in modo che le nuove sessioni possano avviarsi più velocemente a costo di una maggiore quantità di memoria. Consultare il manuale dell'SDK di Collabora Online . Il modello di configurazione attuale di Collabora espone anche un limite di proporzione di memoria e controlli di concorrenza per documento; il codice sorgente ufficiale del progetto è disponibile nel modello di configurazione di Collabora Online .
ONLYOFFICE pubblica livelli di riferimento più espliciti per Docs Community Edition in Docker. Le sue attuali linee guida indicano 4 GB di RAM o più e elencano configurazioni di riferimento con un core da 2,8 GHz per meno di 100 utenti attivi simultanei, due core per 100-200 utenti e quattro core per 200-400 utenti, mantenendo 4 GB di RAM in tali righe di riferimento. Il fornitore avverte esplicitamente che la capacità effettiva dipende dal numero, dal tipo e dalle dimensioni dei documenti. Consultare i requisiti di ONLYOFFICE Docs Community Edition per Docker .
Zona
Collabora online
Documenti ONLYOFFICE
Che cosa concludere
Dimensionamento di produzione pubblicato
L'esempio Helm dell'SDK raccomanda 4 CPU / 6 GiB richiesti, fino a un limite di 8 CPU / 8 GiB.
Il riferimento Docker parte da 4 GB di RAM; i livelli di CPU scalano in base al numero di utenti attivi simultanei.
Non si può definire nessuno dei due prodotti "più leggero" basandosi solo su questi numeri; le ipotesi di implementazione sono diverse.
Comportamento di avvio a caldo
I processi figli pre-avviati possono scambiare memoria per avviare sessioni più veloci
Diversi servizi lato server gestiscono la modifica, la conversione, i comandi e la creazione di documenti.
La memoria inattiva e la latenza di prima apertura possono riflettere l'architettura e l'ottimizzazione, non solo l'efficienza dell'editor.
Modello di concorrenza
L'elaborazione per singolo documento prevede controlli di concorrenza configurabili.
Un utente attivo simultaneo è un utente con un documento aperto, comprese le sessioni di sola visualizzazione secondo la definizione del fornitore.
Contare sistematicamente le sessioni aperte prima di confrontare la capacità.
Perché uno screenshot della memoria inattiva non è un benchmark
Un confronto comune consiste nell'avviare entrambi i container, senza aprire alcun documento, e dichiarare vincitore quello con il minor consumo di RAM. Questo metodo misura solo l'impatto minimo, tralasciando le operazioni fondamentali: aprire un file, convertirlo quando necessario, visualizzare pagine o fogli di calcolo, trasmettere le modifiche, ricalcolare i fogli di calcolo, gestire più editor e salvare il risultato nella memoria di archiviazione.
Il modello di processo di Collabora può mantenere i processi figlio pronti in anticipo. Ciò può aumentare l'impronta di inattività riducendo al contempo il ritardo prima che un documento diventi utilizzabile. ONLYOFFICE separa la modifica dei documenti da servizi come la conversione; la sua documentazione architetturale descrive l'editor di documenti, il servizio di modifica, il servizio di comando, il servizio di conversione e il servizio di creazione. Vedi Come funziona la documentazione di ONLYOFFICE . In altre parole, l'RSS di base è una metrica operativa utile, ma non è sufficiente per prevedere la velocità percepita dall'utente.
Una configurazione di test equa per risorse e latenza
Eseguire i due prodotti uno alla volta sullo stesso host o su due macchine virtuali con le stesse impostazioni. Evitare di testare un prodotto su un host già avviato con file memorizzati nella cache e l'altro immediatamente dopo l'avvio. Mantenere identici la distribuzione Linux, la versione di Docker, la quota CPU, il limite di memoria, la classe di archiviazione, il reverse proxy, la terminazione TLS, la versione del browser e il percorso di archiviazione dei documenti.
Utilizzare tre carichi di lavoro di documenti
Documento di testo: un file DOCX rappresentativo con intestazioni, tabelle, immagini, revisioni rilevate e commenti.
Foglio di calcolo: un file XLSX con formule, formattazione condizionale, diversi fogli di lavoro e dati sufficienti per attivare ricalcoli significativi.
Presentazione: una presentazione PPTX con immagini, grafici e diverse diapositive, anziché una presentazione quasi vuota.
Utilizza gli stessi file per entrambe le piattaforme. Se un file richiede la conversione di formato in un programma, annotalo perché la conversione può incidere notevolmente sui tempi di apertura. Non ottimizzare un file specificamente per un editor e poi utilizzare il risultato come confronto generale tra piattaforme.
Eseguire test a più livelli di concorrenza.
Una sequenza pratica prevede 1, 5, 10 e 20 editor aperti simultaneamente, seguiti da un livello superiore che corrisponda al picco di utilizzo previsto. Per "utente" si intende sempre la stessa cosa: una scheda dell'editor con il documento completamente aperto. Ripetere ogni livello almeno tre volte dopo una fase di riscaldamento e riportare la mediana più il risultato più lento. In questo modo, è meno probabile che brevi picchi di utilizzo di base distorcano le conclusioni.
Metriche delle risorse da registrare
Docker fornisce un primo livello di telemetria indipendente dal fornitore. La documentazione ufficiale di Docker Stats spiega che docker statsvengono riportati la percentuale di utilizzo della CPU, l'utilizzo della memoria, l'I/O di rete, l'I/O a blocchi e i PID. È possibile acquisire sia un flusso in tempo reale durante il carico di lavoro, sia un campione senza flusso in punti di controllo definiti.
Per ogni livello di concorrenza, registrare la memoria inattiva prima di aprire qualsiasi applicazione, la memoria a regime dopo l'apertura di tutti i documenti, il picco di utilizzo della CPU durante l'apertura, la CPU dopo la stabilizzazione delle sessioni e la memoria dopo la chiusura di ogni sessione. Verificare inoltre se la memoria ritorna vicino al valore di base dopo un periodo di raffreddamento. Un valore post-test più elevato non indica automaticamente una perdita di memoria (le cache e la memoria condivisa possono rimanere utili), ma un valore di base in continuo aumento in cicli identici ripetuti merita un'indagine.
Non confrontare solo le percentuali dei container se uno di essi ha un limite di CPU o di memoria diverso. Registra i limiti effettivi dell'host o del cgroup insieme ai risultati del benchmark. Il dato relativo alla memoria Linux di Docker presenta anche delle sfumature legate alla cache, quindi utilizza lo stesso ambiente Docker e cgroup per entrambi i prodotti.
Come misurare la latenza di apertura
Definisci la latenza di apertura prima di eseguire i test. Una definizione valida è il tempo che intercorre tra l'azione di apertura dell'utente e il momento in cui l'editor è visibilmente pronto per l'input e il contenuto del documento si è stabilizzato a sufficienza per iniziare a digitare. Misura lo stesso parametro per entrambi i prodotti. Una semplice registrazione dello schermo con timestamp può essere più comparabile rispetto all'utilizzo di eventi interni specifici del prodotto.
Raccogli due forme di latenza di apertura. L'apertura a freddo inizia dopo il riavvio del container dell'ufficio e la chiusura della sessione di test. L'apertura a caldo ripete lo stesso file senza riavviare il servizio. L'impostazione prespawn di Collabora rende questa distinzione particolarmente importante perché un maggior numero di processi figlio in attesa può ridurre il ritardo di avvio, ma aumenta l'utilizzo della memoria. Se si ottimizza num_prespawn_children, elencare il suo valore accanto ai risultati anziché nasconderlo.
Come misurare la latenza della collaborazione
Per la modifica collaborativa in tempo reale, la metrica significativa non è il normale ping ICMP. Misura il ritardo tra una modifica nel browser A e la modifica visibile nel browser B. Utilizza due profili browser o due computer separati e sincronizza i loro orologi. Registra 20-50 modifiche semplici, come l'aggiunta di un carattere allo stesso paragrafo, quindi calcola la mediana e il 95° percentile del ritardo di propagazione visibile.
La descrizione ufficiale della co-editing di ONLYOFFICE conferma che le modifiche vengono propagate dall'editor al servizio di modifica del documento e quindi all'altro editor. Consultare il flusso di lavoro di co-editing di ONLYOFFICE . La configurazione del server espone anche le impostazioni relative a WebSocket, tra cui il comportamento di riconnessione e la dimensione massima del payload, nel riferimento alla configurazione del server di ONLYOFFICE . Anche Collabora dipende dal traffico WebSocket persistente attraverso il reverse proxy, quindi il buffering del proxy, il comportamento del timeout, la terminazione TLS e l'RTT di rete devono essere considerati parte dell'ambiente di test piuttosto che dettagli di sfondo.
Aggiungi ritardo di rete controllato
Se gli utenti sono remoti, ripetete il test di collaborazione con una latenza di andata e ritorno controllata, ad esempio di circa 20 ms, 80 ms e 150 ms. Applicate la stessa configurazione di rete a entrambi i sistemi e documentate esattamente dove viene introdotta. Questo mette in luce una differenza che i benchmark su LAN locale possono nascondere: un editor potrebbe risultare eccellente con un RTT di 1-5 ms, ma sensibilmente meno reattivo per le filiali o i team internazionali.
Salvare la latenza richiede una misurazione specifica
Il salvataggio non è sinonimo di latenza di digitazione. ONLYOFFICE documenta un flusso di lavoro in cui il servizio di modifica compila le modifiche e invia una callback al servizio di archiviazione al termine della modifica; la documentazione indica un ritardo predefinito di cinque secondi all'avvio della conversione e afferma che la tempistica finale dipende anche dal tempo di conversione, dalla complessità del file e dalle prestazioni del server. Consultare la documentazione di ONLYOFFICE sul salvataggio dei file . Ciò significa che un'osservazione del tipo "il salvataggio ha richiesto diversi secondi" non deve essere automaticamente interpretata come un ritardo interattivo.
Per entrambi i prodotti, il tempo di completamento del salvataggio va calcolato dal momento in cui l'ultimo editor termina la modifica fino alla conferma del file aggiornato nella memoria di supporto. Mantenere la memoria di archiviazione sullo stesso percorso di rete e sulla stessa classe di disco. In caso contrario, un Nextcloud, ownCloud, object store, database o reverse proxy lenti potrebbero essere attribuiti alla suite per ufficio.
Foglio dei risultati: i numeri che contano
metrico
Registrare a
Perché è importante
Memoria inattiva
Nessun documento aperto
Costo base per i server di piccole dimensioni
Memoria stabile per carico di lavoro
1, 5, 10, 20+ editor aperti
Mostra un comportamento di scalabilità migliore rispetto a RSS inattivo
Picco CPU
Durante l'apertura del documento e il ricalcolo del foglio di calcolo
Rivela i requisiti di capacità di picco
Latenza di apertura a freddo
Dopo il riavvio del servizio
Cattura il costo di avvio/generazione del processo
Latenza di apertura a caldo
Apertura ripetuta del file
Mostra una normale reattività alle sessioni ripetute
Propagazione della modifica p50/p95
Modifica collaborativa tra due utenti
Misure percepite del ritardo nella collaborazione
Salvataggio completato
L'ultimo editor chiude o termina
Separa il tempo di persistenza dalla latenza interattiva.
Come interpretare il risultato
Se Collabora utilizza più memoria inattiva nella tua configurazione ma produce una latenza di apertura a freddo inferiore, questo potrebbe essere un compromesso accettabile se gli utenti aprono frequentemente documenti e il server ha RAM disponibile. Se ONLYOFFICE mostra una baseline inferiore ma picchi di CPU più elevati durante la conversione, il margine di CPU potrebbe essere più importante della memoria. Sono possibili anche i modelli opposti; l'importante è collegare ogni curva di utilizzo delle risorse a un evento visibile all'utente.
Per una piccola installazione self-hosted, è importante concentrarsi sull'ingombro inattivo, sul tempo di prima apertura e sulla presenza di uno o due documenti di grandi dimensioni che causano lo swapping. Per un'implementazione aziendale con decine di editor attivi, è preferibile dare priorità alla crescita della memoria, alla saturazione della CPU, al ritardo di co-editing p95 e al recupero dopo il carico. Per gli utenti distribuiti geograficamente, il RTT di rete e la configurazione del proxy possono avere un peso maggiore rispetto a modeste differenze lato server.
Il vincitore più utile è quindi il prodotto che rimane entro il budget di CPU e RAM, rispettando al contempo il target di latenza sui documenti reali. Le pagine di dimensionamento dei fornitori sono punti di partenza, non risultati di benchmark. Eseguite lo stesso carico di lavoro, mantenete l'ambiente controllato, pubblicate la configurazione di test accanto ai dati numerici ed evitate di generalizzare una singola lettura della memoria inattiva per fare un'affermazione sulle prestazioni complessive.