How to Connect ONLYOFFICE Desktop Editors to an ownCloud Server

Connect ONLYOFFICE Desktop Editors to your ownCloud server, sign in, open cloud files, manage the connection, and troubleshoot common setup issues.
When Collabora Online suddenly uses most of a server's CPU, the most important first step is not to restart it repeatedly or immediately impose a very low CPU limit. First determine whether the load comes from normal document work, one pathological document session, too much parallel work, an idle session that is not being cleaned up, or a version-specific regression. The process name may be coolwsd on current releases and loolwsd on older installations.
Illustrative scenario: imagine an 8-vCPU server running Collabora Online behind Nextcloud. Only a few people appear to be editing documents, but the Collabora container sits around 250% to 350% CPU for several minutes. This is a hypothetical example used throughout this guide, not a measured benchmark or a report from a real deployment.
As of October 2026, Collabora's current stable branch is 26.04, and the official release notes list Collabora Online 26.04.3.3 as released on September 14, 2026. Current configuration templates use the coolwsd name. Collabora's migration tooling still documents the older /etc/loolwsd/loolwsd.xml path for installations from the 6.4 era or earlier, which is why administrators may still encounter both names.
Start at the operating-system or container level. A high number beside coolwsd does not automatically mean the coordinating daemon itself is doing all of the expensive document work. Collabora also runs kit/forkit processes for document sessions, so you want the process tree and per-process CPU usage before changing configuration.
ps -eo pid,ppid,pcpu,pmem,etime,cmd --sort=-pcpu | head -n 25
top -H -p $(pgrep -d, -f 'coolwsd|loolwsd|coolkit|loolkit|forkit')
For Docker, also check the container as a whole:
docker stats --no-stream
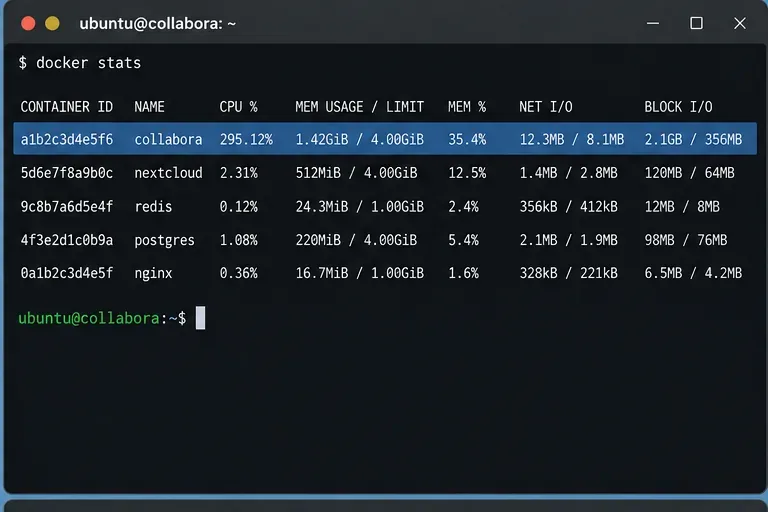
In the illustrative scenario, suppose the container is near 300% CPU and one kit process is consistently at the top of the process list. That points you toward a specific active document session rather than a generic assumption that the entire server is overloaded.
Collabora Online exposes Prometheus-compatible metrics at /cool/getMetrics. The current SDK manual says this endpoint can report CPU and memory use, running kit processes, views, and other server-usage data. It uses the same authentication as the admin console unless metrics are explicitly configured for unauthenticated access.
문제 해결을 단순화하기 위해 메트릭 엔드포인트를 공개적으로 노출하지 마십시오. 공식 Helm 설정에는 /cool/getMetrics인그레스에서 차단 및 관리자 URL에 대한 예제가 포함되어 있습니다. 가능한 한 인증된 내부 경로를 사용하십시오.
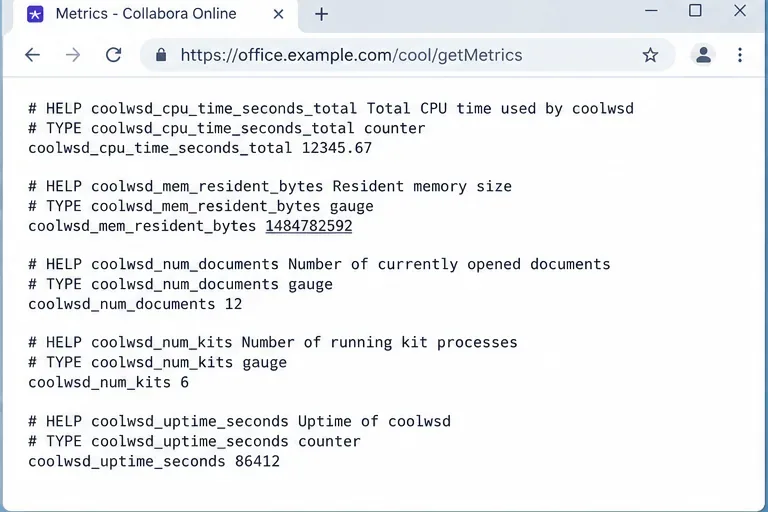
CPU 사용량과 활성 문서 또는 보기 간의 상관관계를 확인하십시오. 정상적인 편집 활동에 따라 CPU 사용량이 오르락내리락한다면 용량 또는 동시 접속 문제가 있을 수 있습니다. 상호 작용 작업이 없는데도 CPU 사용량이 계속 높다면 오래된 세션, 문제가 있는 문서, 반복적인 백그라운드 작업 또는 소프트웨어 문제를 조사하십시오.
systemd로 관리되는 패키지 설치의 경우:
journalctl -u coolwsd --since "15 minutes ago" --no-pager
journalctl -u coolwsd -f
Docker의 경우:
docker logs collabora --since 15m
docker logs -f collabora
서비스 또는 컨테이너 이름이 다른 경우 해당 이름으로 바꿔주세요. 문서 반복 로드, 키트 반복 생성, 저장 실패, 충돌, 재연결 루프 또는 동일한 문서 키가 반복적으로 나타나는 현상을 찾아보세요. 문서 열기, 재계산, 렌더링, 변환 또는 내보내기 중에 CPU 사용률이 일시적으로 높아지는 것은 정상적인 현상일 수 있습니다. 하지만 CPU 사용률이 지속적으로 높으면서 아무런 진전이 없거나 동일한 오류가 반복되는 경우가 더 심각한 경고 신호입니다.
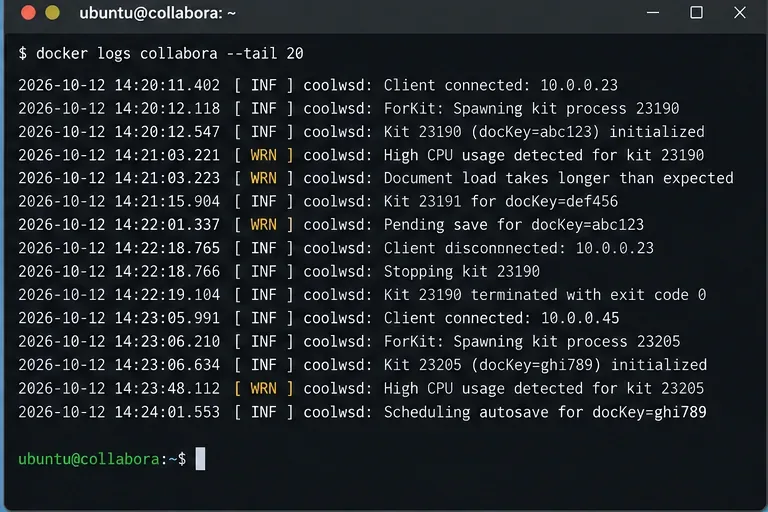
가상의 서버로 돌아갑니다. 키트 프로세스 중 하나라도 사용량이 많으면 해당 문서를 닫거나 격리하고 CPU 사용량이 감소하는지 확인합니다. 그런 다음 사용량이 적은 시간대에 동일한 파일을 열고 프로세스 목록과 메트릭을 모니터링합니다. 간단한 테스트 문서를 사용하여 이 과정을 반복합니다.
이러한 비교는 전체 서비스를 즉시 재시작하는 것보다 더 유용합니다.
현재 Collabora 구성 템플릿 문서에는 per_document.max_concurrency문서 처리 시 사용되는 최대 스레드 수가 명시되어 있습니다. 템플릿의 기본값은 4입니다. 호스트 사양이 낮거나 단일 복잡한 문서가 시스템 자원을 과도하게 사용하는 경우, 이 값을 줄이면 CPU 사용량을 더욱 예측 가능하게 만들 수 있습니다.
예를 들어, 2라는 값을 테스트할 수 있습니다.
<per_document>
    <max_concurrency>2</max_concurrency>
</per_document>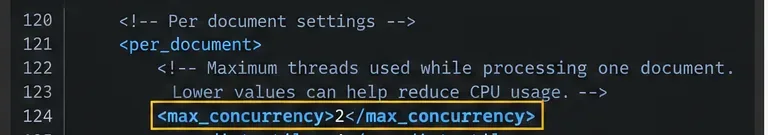
숫자 2를 맹목적으로 복사하지 마십시오. 사용자가 대용량 스프레드시트나 프레젠테이션을 자주 다루고 서버에 코어 수가 충분한 경우, 더 낮은 값은 오히려 작업 속도를 저하시킬 수 있습니다. 설정을 하나 변경하고 동일한 작업 부하를 재현한 다음 CPU 사용량, 응답 속도 및 완료 시간을 비교해 보십시오.
현재 coolwsd.xml템플릿에는 리소스를 많이 소모하는 유휴 문서를 정리하는 로직이 포함되어 있습니다. 이 글을 작성하는 시점에서 템플릿은 정리 점검 간격을 10,000ms, 비정상 동작 기간을 60초, 유휴 임계값을 300초, CPU 사용률 85% 이상으로 설정하여 문서를 정리 대상으로 지정하고 있습니다. 또한 문서별 유휴 시간 초과를 3,600초로 설정하고 있습니다.
동일한 템플릿에는 뷰별 시간 제한이 포함되어 있습니다. 현재 값은 포커스가 없는 브라우저 뷰가 흐려지고 업데이트가 중지되기까지 300초, 비활성 뷰가 유사하게 처리되기까지 900초가 걸립니다. 이러한 뷰 시간 제한은 전체 문서 세션을 즉시 종료하는 것과는 다릅니다.

그래프를 보기 좋게 하려고 CPU 임계값을 지나치게 낮게 설정하지 마십시오. 정리 기능은 리소스를 많이 소모하는 불량 문서나 유휴 문서를 걸러내기 위한 것이지, 계산 비용이 많이 들 때마다 일반적인 활성 편집 작업을 종료하기 위한 것이 아닙니다.
먼저 현재 활성화된 구성을 백업하십시오. 패키지 설치는 일반적으로 환경 변수를 사용합니다 /etc/coolwsd/coolwsd.xml. Docker 배포는 환경 변수 또는 명령줄 재정의를 통해 옵션을 전달하거나 구성 파일을 컨테이너에 마운트할 수 있습니다. 편집하기 전에 실제로 활성화된 소스가 무엇인지 확인하십시오.
패키지 설치의 경우:
sudo cp /etc/coolwsd/coolwsd.xml /etc/coolwsd/coolwsd.xml.before-cpu-tuning
sudo systemctl restart coolwsd
systemctl status coolwsd --no-pager
Docker 컨테이너의 경우:
docker restart collabora
docker ps --filter name=collabora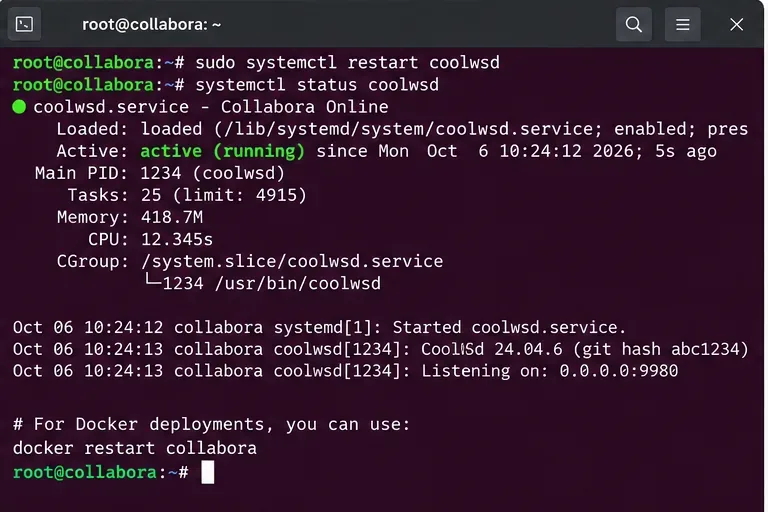
재부팅만으로 CPU 문제가 일시적으로 해결되지만 문제가 반복적으로 재발하는 경우, 이는 문제 해결의 근본적인 원인이 아니라 진단 정보일 뿐입니다. 어떤 작업 부하 또는 상태에서 문제가 재발하는지 파악할 수 있을 때까지 이 과정을 반복하십시오.
동일한 문서, 비슷한 수의 사용자, 그리고 동일한 작업 순서를 사용하십시오. 특정 순간을 비교하는 대신 몇 분 동안 측정하십시오. 예시 시나리오에서, 성공적인 결과는 재현된 작업 부하 동안 서버 과부하가 더 이상 발생하지 않으면서 문서 열기, 편집, 저장 및 공동 작업이 허용 가능한 수준으로 작동하는 것을 의미합니다.
| 관찰 | 다음 조치 예상 |
|---|---|
| 하나의 문서 또는 키트가 계속해서 주목받고 있습니다. | 해당 파일을 사용하여 문제를 재현하고, 로그를 보존한 다음, 현재 안정적인 마이크로 릴리스에서 테스트하십시오. |
| CPU는 활성 사용자 수를 추적합니다. | 부하를 누수로 간주하기보다는 용량, 동시 접속 수 및 배포 규모를 검토하십시오. |
| 사용자들이 자리를 비운 후에도 CPU 사용률이 높은 상태로 유지됩니다. | 사용되지 않는 문서, 정리 동작, 반복되는 백그라운드 작업, 그리고 연결이 끊기거나 재시작되는 키트를 검사합니다. |
| Spike는 업그레이드 직후 바로 작동하기 시작했습니다. | 여러 튜닝 값을 변경하기 전에 정확한 버전을 기록하고 최신 릴리스 노트와 알려진 문제를 확인하십시오. |
| max_concurrency 값을 낮추면 CPU 사용량은 줄어들지만 편집 속도가 느려집니다. | 점진적으로 높이거나 CPU 용량을 늘리세요. 이 설정은 만능 해결책이 아니라 절충안입니다. |
특정 Collabora 버전에서 문제가 발생하기 시작했고 특정 파일이나 작업에서 문제를 재현할 수 있다면, 구성 조정만으로는 소프트웨어 결함을 숨길 수 있습니다. Collabora는 현재 안정 브랜치의 최신 버전을 사용할 것을 권장합니다. 2026년 10월 7일 기준으로 공식 26.04 릴리스 노트 페이지에는 26.04.3.3이 최신 Collabora Online 릴리스로 표시되어 있습니다.
CODE 사용자 여러분께서는 Collabora에서 개발자 에디션을 소규모 팀, 재택 근무, 개발 환경 및 새로운 기능 테스트 용도로 적합하며, 프로덕션 환경에는 적합하지 않다고 명시하고 있음을 유념해 주시기 바랍니다. 따라서 CODE에서 프로덕션 환경에 문제가 발생할 경우, 개발 에디션의 동작 방식을 계속해서 조정하는 것보다 지원되는 Collabora Online 제품으로 전환하는 것이 더 나은 선택일 수 있습니다.
coolwsd수치가 메모리 누수나 무한 루프를 의미한다고 단정하지 마십시오.coolwsd, loolwsd아니면 하위 키트/키트 프로세스인지 확인하십시오.per_document.max_concurrency특정 문서가 병렬 CPU 사용량을 과도하게 차지하는 경우에만 테스트하십시오 .이 가이드의 구성 세부 정보는 현재 Collabora Online 소스 템플릿인 Collabora Online coolwsd.xml 구성 템플릿을 기반으로 합니다 . 공식 SDK 설명서에는 로깅, 성능 제어 및 Prometheus 호환 메트릭 엔드포인트에 대한 내용이 나와 있습니다. Collabora Online SDK 설명서를 참조하십시오. 버전 확인은 제조업체의 Collabora Online 26.04 릴리스 노트를 참조하십시오 . 개발자 에디션의 사용 목적에 대해서는 공식 CODE 26.04 릴리스 공지를 참조하십시오 .
실질적인 목표는 Collabora Online이 가능한 한 적은 CPU를 사용하도록 강제하는 것이 아닙니다. 오히려 적절한 편집 및 공동 작업 성능을 유지하면서 CPU 사용량을 설명 가능하고 유용한 작업에 비례하도록 만드는 것입니다.
Connect ONLYOFFICE Desktop Editors to your ownCloud server, sign in, open cloud files, manage the connection, and troubleshoot common setup issues.
Troubleshoot high Collabora Online CPU usage by identifying busy kit processes, checking metrics and logs, tuning concurrency and cleanup, and verifying fixes safely.
라이선스 제한, 테마 JSON 설정, Docker 경로 및 테스트를 포함하여 헤더 로고와 인터페이스 색상을 사용하여 ONLYOFFICE Docs의 브랜드를 사용자 지정하는 방법을 알아보세요.
LibreOffice Calc에서 읽기 어려운 텍스트를 수정하려면 앱 테마, 셀 글꼴 및 채우기 색상, 스타일, 조건부 서식을 확인한 다음 인쇄 출력을 확인하십시오.
LibreOffice의 알 수 없는 사용자 잠금 경고를 안전하게 해결하세요. 활성 세션을 확인하고, 사본을 보호하고, 검증된 만료된 잠금만 제거하고, 문서를 테스트할 수 있습니다.
LibreOffice Writer에서 아랍어 또는 히브리어 텍스트가 영어 텍스트와 잘못 섞이거나, 정렬되지 않거나, 흐름이 원활하지 않은 문제를 해결하세요. 복잡한 텍스트 레이아웃을 활성화하고, 단락 방향을 설정한 후 결과를 확인하세요.
LibreOffice Calc에서 VLOOKUP 및 XLOOKUP 함수를 사용하는 방법을 알아보세요. 정확한 일치, 왼쪽 검색, 찾을 수 없는 결과, 역방향 검색, INDEX/MATCH 함수의 대안, 일반적인 오류 등을 다룹니다.
Collabora Online WOPI 증명 유효성 검사 실패 문제를 해결하려면 검색 키, 키 순환, 프록시 URL, 타임스탬프 및 호스트 허용 목록을 확인하십시오.
ONLYOFFICE 문서에서 모든 사용자에 대해 변경 내용 추적 기능을 활성화하고, 문서를 다시 열었을 때도 이 기능을 유지하며, 전역 기본 설정의 한계를 이해하는 방법을 알아보세요.
Collabora Online의 보기별 시간 제한, 포커스 해제 시간 제한, 문서 유휴 시간 제한, 자동 저장 시간 제한 및 프록시 시간 제한을 비교한 다음 배포 환경에 맞는 설정을 선택하고 확인하십시오.




