Als een SUSE Linux-server tijdens het herstarten vastloopt bij een systemd-afsluitbericht, is de meest nuttige eerste aanname niet dat de herstartopdracht zelf defect is. In de meeste gevallen wacht systemd tot een unit, mount, proces of shutdown hook is voltooid. De veiligste oplossing is daarom om de exacte taak te identificeren die nog steeds actief is, te onderzoeken waarom deze niet stopt en dat onderdeel te corrigeren, in plaats van de afsluittime-outs in het algemeen te verkorten.
Deze handleiding gebruikt een hypothetisch voorbeeld : een server met de naam lab-sles01SUSE Linux Enterprise Server draait en pauzeert tijdens het herstarten met een bericht dat lijkt op A stop job is running for backup.service. Het voorbeeld dient slechts ter illustratie van de diagnostische methode; het is geen verslag van een echte test of een bewering dat een bepaalde SUSE-release een defect heeft in een service met de naam backup.service.
De oplossing in vier stappen, kort samengevat.
| Stap | Wat te doen | Wat je probeert te leren |
|---|
| 1 | Noteer het exacte afsluitbericht. | Welke eenheid of fase blokkeert de voortgang? |
| 2 | Bekijk het vorige opstartlogboek | Of het nu gaat om een time-out, een mislukte ontkoppeling of een latere fase in het afsluitproces. |
| 3 | Inspecteer de blokkeereenheid en de actieve werkzaamheden. | Of een service, mount, inhibitor of dependency hiervoor verantwoordelijk is. |
| 4 | Verhelp de hoofdoorzaak en test opnieuw. | Of een normale procedure systemctl rebootnu zonder vertraging wordt voltooid |
Stap 1: Noteer precies waar het afsluitproces stopt.
Houd de lokale console, de console van de virtuele machine, de BMC/IPMI-console of de hypervisorconsole in de gaten tijdens een geplande herstart. Een regel met de naam van een eenheid is veel nuttiger dan een algemene beschrijving zoals "systemd is vastgelopen". lab-sles01Stel, hypothetisch gezien, dat de console laat zien dat systemd backup.servicenog steeds bezig is met stoppen, terwijl andere eenheden al zijn afgesloten.
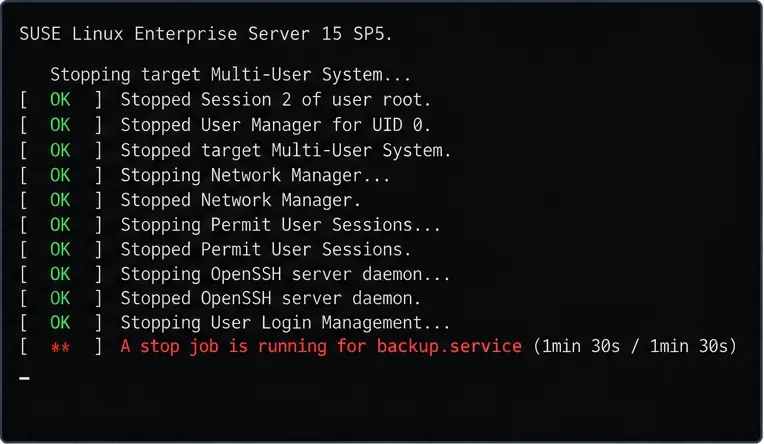
Illustratief voorbeeld: de afsluitconsole geeft aan backup.serviceop welke eenheid systemd nog wacht.
Als de console in plaats daarvan een .mounteenheid, een netwerkbestandssysteem, een apparaat of een andere service noemt, volg dan die naam in plaats van een algemene time-out voor de service toe te passen. De eenheid die onderaan de console wordt weergegeven, is een aanwijzing, maar niet automatisch de hoofdoorzaak: deze kan zelf wachten op een subproces, opslag, netwerk-I/O of een andere afhankelijkheid.
De huidige richtlijnen van SUSE voor systemd vermelden dat een lange herstart of uitschakeling kan worden veroorzaakt door een service die niet wordt afgesloten en raden aan om de systemd-taken te controleren. Zie SUSE Linux Enterprise Server 16.0: Inleiding tot de basisprincipes van systemd .
Stap 2: Gebruik het vorige opstartlogboek nadat de server is teruggekeerd.
Nadat de machine opnieuw is opgestart, controleer dan de zojuist uitgevoerde afsluiting. SUSE documenteert opstartoffsets in het logboek: boot 0is de huidige opstart, -1is de vorige opstart, enzovoort. Begin met:
sudo journalctl --list-boots
sudo journalctl -b -1
Bij een groot tijdschrift kunnen de laatste berichten sneller worden gevonden door de volgorde om te keren:
sudo journalctl -b -1 -r

Illustratief voorbeeld: het logboek van de vorige opstart toont de hypothetische back-upservice die een SIGTERM-signaal ontvangt en later een time-out geeft.
Zoek naar zinnen zoals Stopping, stop job, timed out, Failed with result, Unmounting, Dependency failed, of berichten van de verdachte dienst zelf. Je kunt de zoekresultaten verfijnen zodra je de naam van de eenheid weet:
sudo journalctl -b -1 -u backup.service
SUSE beschrijft in de documentatie van SLES 15 SP7journalctl -b -1 de mogelijkheden voor analyse van eerdere opstartpogingen . Als de eerdere opstartpoging niet is vastgelegd, trek dan geen conclusies op basis van de ontbrekende geschiedenis; controleer hoe de journald-opslag is geconfigureerd en gebruik console- of externe logboekregistratie voor de volgende reproductie.journalctl --list-boots
Stap 3: Bepaal of de blokkering een service, mount, inhibitor of late shutdown hook is.
Als u het probleem tijdens een onderhoudsvenster kunt reproduceren, zorg er dan voor dat er een tweede beheerdersconsole beschikbaar is. Voer de volgende opdracht uit voordat de verbinding wegvalt:
sudo systemctl list-jobs
sudo systemctl status backup.service
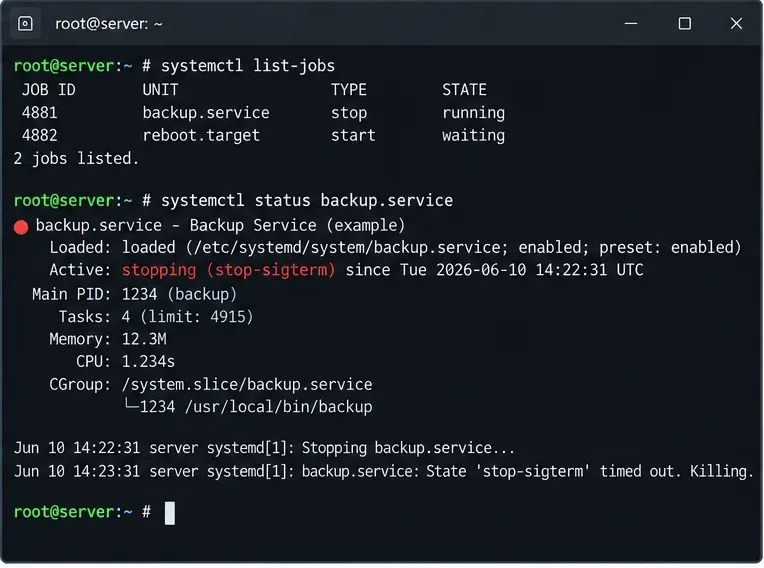
Illustratief voorbeeld: backup.serviceer is een stoptaak actief terwijl het herstartdoel erachter wacht.
De upstream systemd-debuggingrichtlijnen leggen uit dat taken die worden weergegeven als runningmoeten worden voltooid voordat afhankelijke taken die worden weergegeven als waitingkunnen worden uitgevoerd. SUSE raadt dit ook aan systemctl list-jobswanneer het afsluiten of herstarten te lang duurt. Dat maakt dit commando bijzonder nuttig wanneer de server niet volledig is vastgelopen en PID 1 nog steeds reageert.
Als een service te langzaam stopt
Controleer de eenheidsdefinitie en het afsluitgedrag ervan:
sudo systemctl cat backup.service
sudo systemctl status backup.service
sudo journalctl -u backup.service -b
Controleer of de service een ExecStop=actie heeft, of het proces SIGTERM afhandelt en of het wacht op opslag- of netwerkbronnen. Een database, back-upagent of middleware-service heeft mogelijk legitiem tijd nodig om gegevens te verwerken, dus het eerder beëindigen ervan is niet automatisch een oplossing.
Als er een mountpunt of netwerkbestandssysteem bij betrokken is
Zoek naar mislukte ontkoppelingsbewerkingen en identificeer de bron van de koppeling:
findmnt
systemctl list-units --type=mount
sudo journalctl -b -1 | grep -Ei 'unmount|umount|mount|nfs|cifs'
Bij NFS of CIFS moet u de bereikbaarheid van de server, verlopen sessies en de naleving van de afsluitvereisten van de server controleren. Als de geblokkeerde eenheid afkomstig is van een andere bron /etc/fstab, corrigeer dan de mountconfiguratie in plaats van een servicespecifieke time-out toe te passen op een niet-gerelateerde eenheid.
Als het herstartverzoek wordt geblokkeerd
Voordat het afsluitproces begint, kunt u de actieve systemd-remmers weergeven:
systemd-inhibit --list
Inhibitor-vergrendelingen kunnen afsluitverzoeken blokkeren of vertragen terwijl een applicatie bezig is met werkzaamheden die niet onderbroken mogen worden. Ze zijn vooral relevant wanneer het herstartverzoek zelf wordt vertraagd voordat het systeem de uiteindelijke afsluitprocedure heeft doorlopen. Zie de handleiding van systemd-inhibit .
Als het probleem zich voordoet nadat de services al niet meer beschikbaar zijn, kan het vastlopen optreden.
Een vastlopen in een later stadium vereist een ander onderzoek. systemd voert uitvoerbare bestanden uit /usr/lib/systemd/system-shutdown/vlak voor de uiteindelijke herstart of uitschakeling en wacht tot deze zijn voltooid. Als het logboek en de console laten zien dat de normale services al zijn gestopt en het vastlopen zich voordoet in de laatste afsluitfase, controleer dan die directory en eventuele door de leverancier geïnstalleerde hooks. De documentatie van de systemd shutdown-service beschrijft dit gedrag.
Stap 4: Repareer het onderdeel en test vervolgens een normale herstart.
Terug naar het hypothetische geval lab-sles01. Stel dat uit de logboeken blijkt dat backup.servicede service de normale beëindiging negeert nadat het back-upproces al is voltooid. De eerste optie is om de service of het stopcommando te repareren. Als bekend is dat de service na een bepaalde periode veilig kan worden beëindigd, kan een per-unit systemd-override de wachttijd van systemd beperken.
Maak een override aan in plaats van een leverancierseenheid te bewerken onder /usr/lib/systemd/system:
sudo systemctl edit backup.service
Bijvoorbeeld:
[Service]
TimeoutStopSec=30s
Herlaad vervolgens de unit-configuratie van systemd:
sudo systemctl daemon-reload
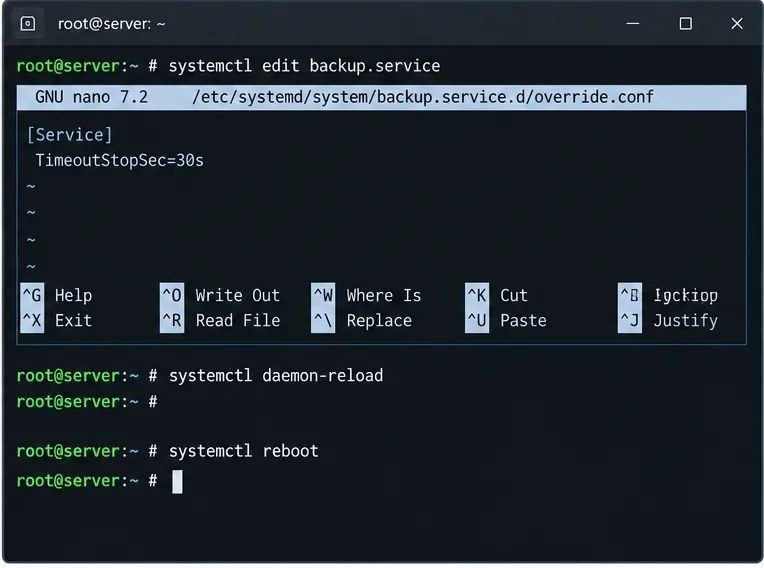
Illustratief voorbeeld: een time-out per service wordt pas toegepast nadat de hypothetische service als de blokkerende factor is geïdentificeerd.
Neem de waarde van 30 seconden niet blindelings over. De juiste time-out hangt af van wat de betreffende service veilig moet kunnen voltooien. Het verkorten van de time-out voor een database, opslagdaemon, geclusterde service of back-upproces kan legitieme opschoonwerkzaamheden verstoren. Een time-out is een vangnet, geen vervanging voor het herstellen van een defecte ExecStop=actie of een applicatie die niet correct wordt afgesloten.
Als je tevreden bent met de wijziging, test dan een normale herstart:
sudo systemctl reboot
Nadat de machine weer is opgestart, controleer dan nogmaals de vorige opstartprocedure en bevestig dat het apparaat correct is afgesloten en niet zomaar van het scherm is verdwenen.
Wanneer moet je een geforceerde herstart uitvoeren?
Een geforceerde herstart is een hersteloptie, geen strategie voor probleemoplossing. De upstream systemd-documentatie stelt dat een dergelijke --forceherstart systemctl rebootde normale service-afsluiting overslaat, maar wel processen beëindigt en probeert bestandssystemen als alleen-lezen te ontkoppelen of opnieuw te koppelen. Het --forcetweemaal opgeven van de optie is gevaarlijker, omdat de computer dan opnieuw kan opstarten zonder processen te beëindigen of bestandssystemen te ontkoppelen, met het risico op gegevensverlies.
Als de server al vastgelopen is en er geen veiligere manier is om de verbinding te herstellen, kan een geforceerde herstart gerechtvaardigd zijn volgens uw operationele procedures.
sudo systemctl reboot --force
Vermijd het behandelen systemctl reboot --force --forcevan een virtuele herstart of een fysieke reset als een normale oplossing. Deze acties kunnen het bewijsmateriaal verwijderen dat u nodig hebt en kunnen lopende schrijfbewerkingen in gevaar brengen. De officiële systemctl-documentatie maakt expliciet onderscheid tussen het gedrag bij een enkele en een dubbele herstart.
Wat als elke herstart vastloopt en je geen problemen kunt oplossen in de normale modus?
Gebruik een onderhoudsconsole en start op in de herstelmodus. SUSE beschrijft hoe je systemd.unit=rescue.targetvanuit de GRUB-editor de kernelopdrachtregel kunt toevoegen. De herstelmodus biedt een root-sessie met toegang tot lokale bestandssystemen en essentiële services, terwijl de netwerkverbinding inactief blijft. Dit kan helpen bij het uitschakelen of herstellen van de betreffende service of mountconfiguratie.
Raadpleeg de SLES 15 SP7-beheerhandleiding voor de officiële herstelmodusprocedure. Op systemen waar het probleem zich pas voordoet na een specifieke wijziging in een pakket, kernel, driver of opslagmedium, dient u ook de relevante SUSE-onderhoudsgeschiedenis te raadplegen voordat u permanente time-outwijzigingen doorvoert.
Snel beslissingstabel
| Wat je ziet | Waarschijnlijk te inspecteren gebied | Beste volgende stap |
|---|
A stop job is running for xyz.service | Service-afsluitingspad | Controleer systemctl statushet eenheidsbestand en het servicejournaal. |
| Herhaalde berichten over het ontkoppelen van bestanden of het externe bestandssysteem | Mount, NFS, CIFS, opslag | Controleer findmntde montage van de units /etc/fstaben de bereikbaarheid van de server. |
| Het herstartverzoek wordt geweigerd of vertraagd vóór het afsluiten. | Inhibitor of een andere systemd-taak | Ren systemd-inhibit --listensystemctl list-jobs |
| De services worden gestopt, maar de definitieve afsluiting wordt nooit voltooid. | Late shutdown hook, kernel, driver, storage | Bekijk het logboek van de vorige opstartprocedure en/usr/lib/systemd/system-shutdown/ |
| Normaal opstarten maakt reparatie onmogelijk. | Aanhoudende configuratie- of apparaatstoring | Opstarten metsystemd.unit=rescue.target |
Kortom
Voor een SUSE Linux-server die vastloopt tijdens het afsluiten met systemd, is de duurzame oplossing het identificeren van de taak waarop systemd wacht en het corrigeren van die taak of de afhankelijkheid ervan. Noteer het afsluitbericht, inspecteer de logbestanden journalctl -b -1, gebruik de commando's `systemd` systemctl list-jobsen systemctl status`systemd` om de blokkerende factor te isoleren, en pas daarna een time-out of mount-configuratie per service aan. Gebruik geforceerde herstartmethoden alleen voor herstelsituaties, niet voor routinematige bewerkingen.